
大模型原理与训练 / 系统课时
做人工偏好与错误分析
做人工偏好与错误分析
自动指标只能告诉你平均表现是否变化,不能解释模型为什么输、输在哪些任务上。本节把人工偏好评测和错误分析组织成可复现流程,用盲评、错误标签与难度切片定位整体分数掩盖的弱点,并判断新模型是否发生回归。
学习目标
- 设计可复现的成对盲评样本与评分维度
- 用错误类型和任务难度切片定位领域弱点
- 区分真实改进、局部回归和样本噪声
先把人工评测变成可复现流程
人工评测最怕两个问题:评审知道模型身份后产生预期偏差,以及不同模型拿到不同提示词、采样参数或上下文。比较前应固定评测集、推理配置和输出长度约束,再随机交换 A/B 展示顺序并隐藏模型名称。
样本不要只做完全随机抽样。至少按任务领域与难度分层,使常见任务、长上下文、复杂指令、安全边界等重要切片都有代表性。若线上已有高风险场景,还应单独保留一组固定回归集,避免平均分上涨却让关键能力退化。
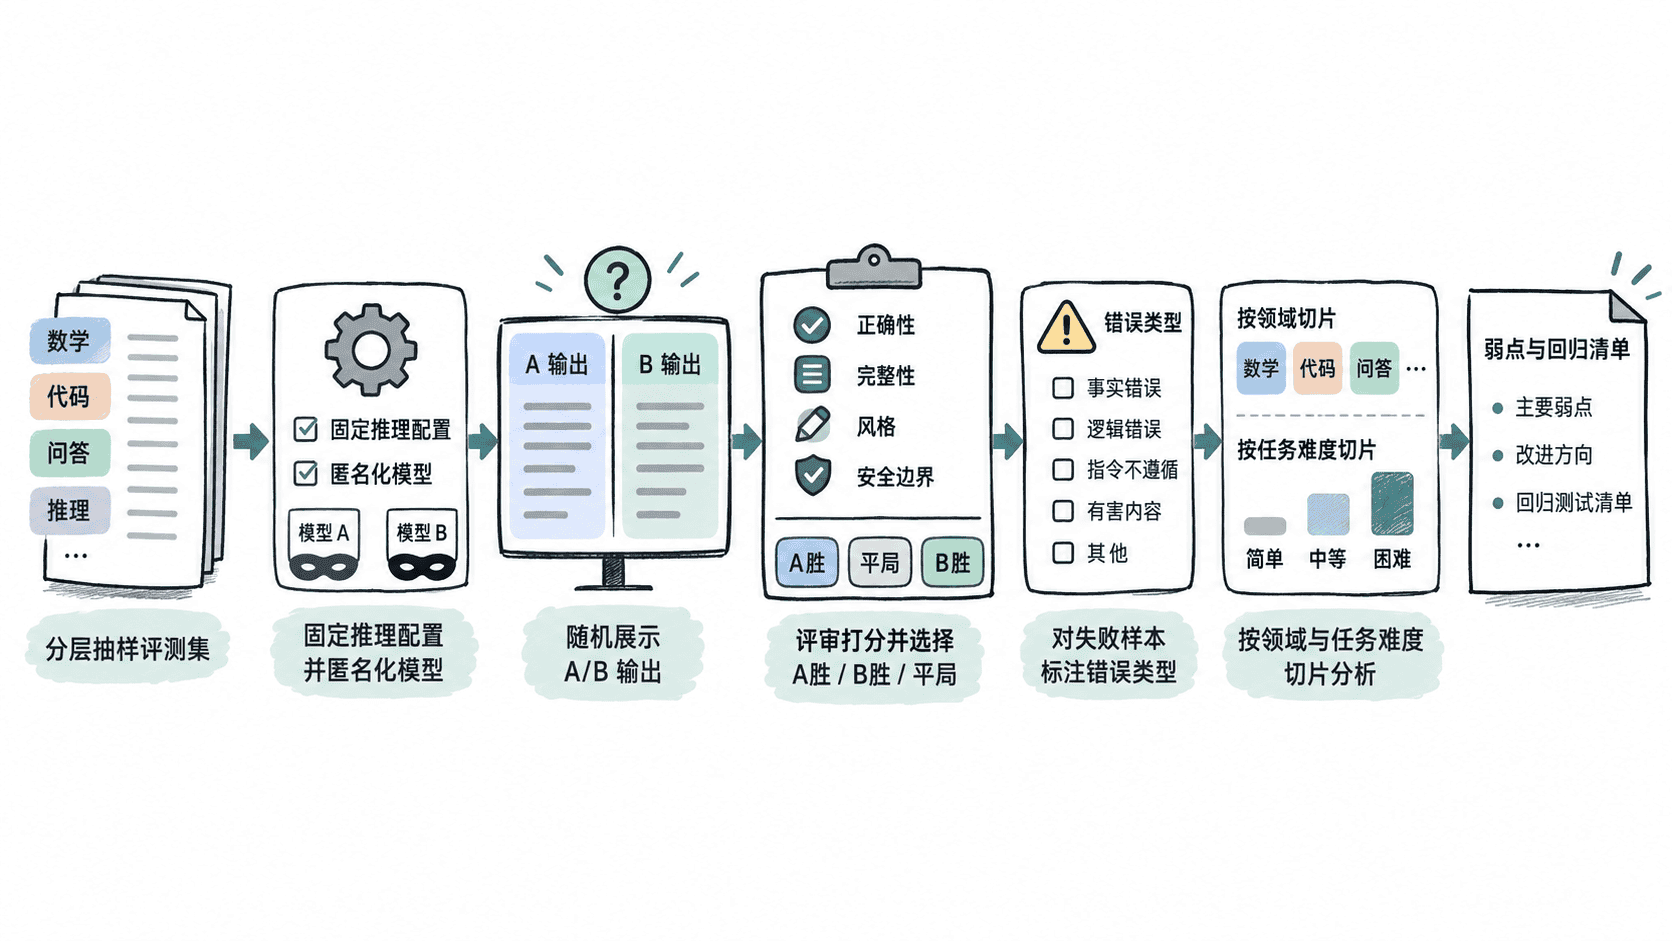
四个维度要先写成可执行的判定标准,而不是让评审凭感觉给分。
| 维度 | 重点检查 |
|---|---|
| 正确性 | 事实、计算、推理结论是否成立,是否出现幻觉 |
| 完整性 | 是否覆盖显式约束、关键步骤和必要边界 |
| 风格 | 是否清晰、简洁、格式合规,是否存在冗余或语气问题 |
| 安全边界 | 应拒绝时是否正确拒绝,可回答时是否发生过度拒绝 |
记录偏好而不是只记总分
成对比较通常比绝对打分更稳定。评审在 A 胜、B 胜、平局中选择,并补充最主要的理由。对同一批样本保持统一规则:如果答案都正确但一个更完整,可以判完整者胜;如果差异只来自无关措辞,不应强行分胜负。
汇总时不要只报胜率。可以把平局按半胜计入偏好率:
其中 是候选模型胜出的样本数, 是平局数, 是总样本数。偏好率适合描述总体趋势,但最终结论还要结合样本量、评审一致性和切片结果。对于关键样本,可由两名以上评审独立判断,再复核分歧最大的案例。
用错误类型和难度切片找弱点
错误标签应回答“为什么失败”,而不是重新描述题目。一个实用的一级分类可以包含:事实错误、漏掉约束、推理中断、无依据补充、格式或风格不合规、安全判断错误。每条失败样本优先标一个主错误,必要时再补一个次错误,避免标签过多导致统计失真。
难度切片要与任务真实复杂度相关。例如可以按单轮与多轮、短上下文与长上下文、单约束与多约束、直接问答与多步推理拆分。再把错误类型与领域交叉查看,才能发现“总体正确率稳定,但长上下文代码任务的漏约束明显增加”这类平均分看不到的问题。
判断改进还是回归
比较基线模型与候选模型时,先看固定回归集,再看整体偏好,最后查看领域、难度和错误类型切片。某个切片样本过少时,只把它当作风险信号,不要直接据此否决模型;应预先约定最小样本量或补充样本复测。
真正需要关注的是可重复的退化模式:同一领域连续出现相似错误、关键安全边界变差,或候选模型在总体偏好上升的同时让高价值任务明显退步。遇到这种情况,应回到具体样本核对输入、参考答案与评审理由,再决定是数据覆盖不足、训练目标冲突,还是推理配置改变造成的假回归。
人工偏好评测的价值不在于再制造一个总分,而在于把模型差异还原成可定位的问题。最终保留原始样本、评审理由、错误标签和切片统计,才能让下一轮数据修正或微调有明确目标。