
大模型原理与训练 / 系统课时
配置可训练参数与目标模块
配置可训练参数与目标模块
LoRA 配置的关键不是把 r 写进去,而是确认适配器插入了哪些线性层、哪些参数真的参与梯度更新。本文用一个本地构造的小型 Llama 模型完成包装、可训练参数占比核对、目标模块检查和前向验证,避免“代码能跑,但实际训错参数”的隐性问题。
学习目标
- 用
LoraConfig明确秩、缩放系数、目标模块和偏置策略。 - 用参数统计与模块清单确认只有预期的 LoRA 权重可训练。
- 在开始训练前完成一次前向传播,排除包装后模型不可用的问题。
先把可训练边界写进配置
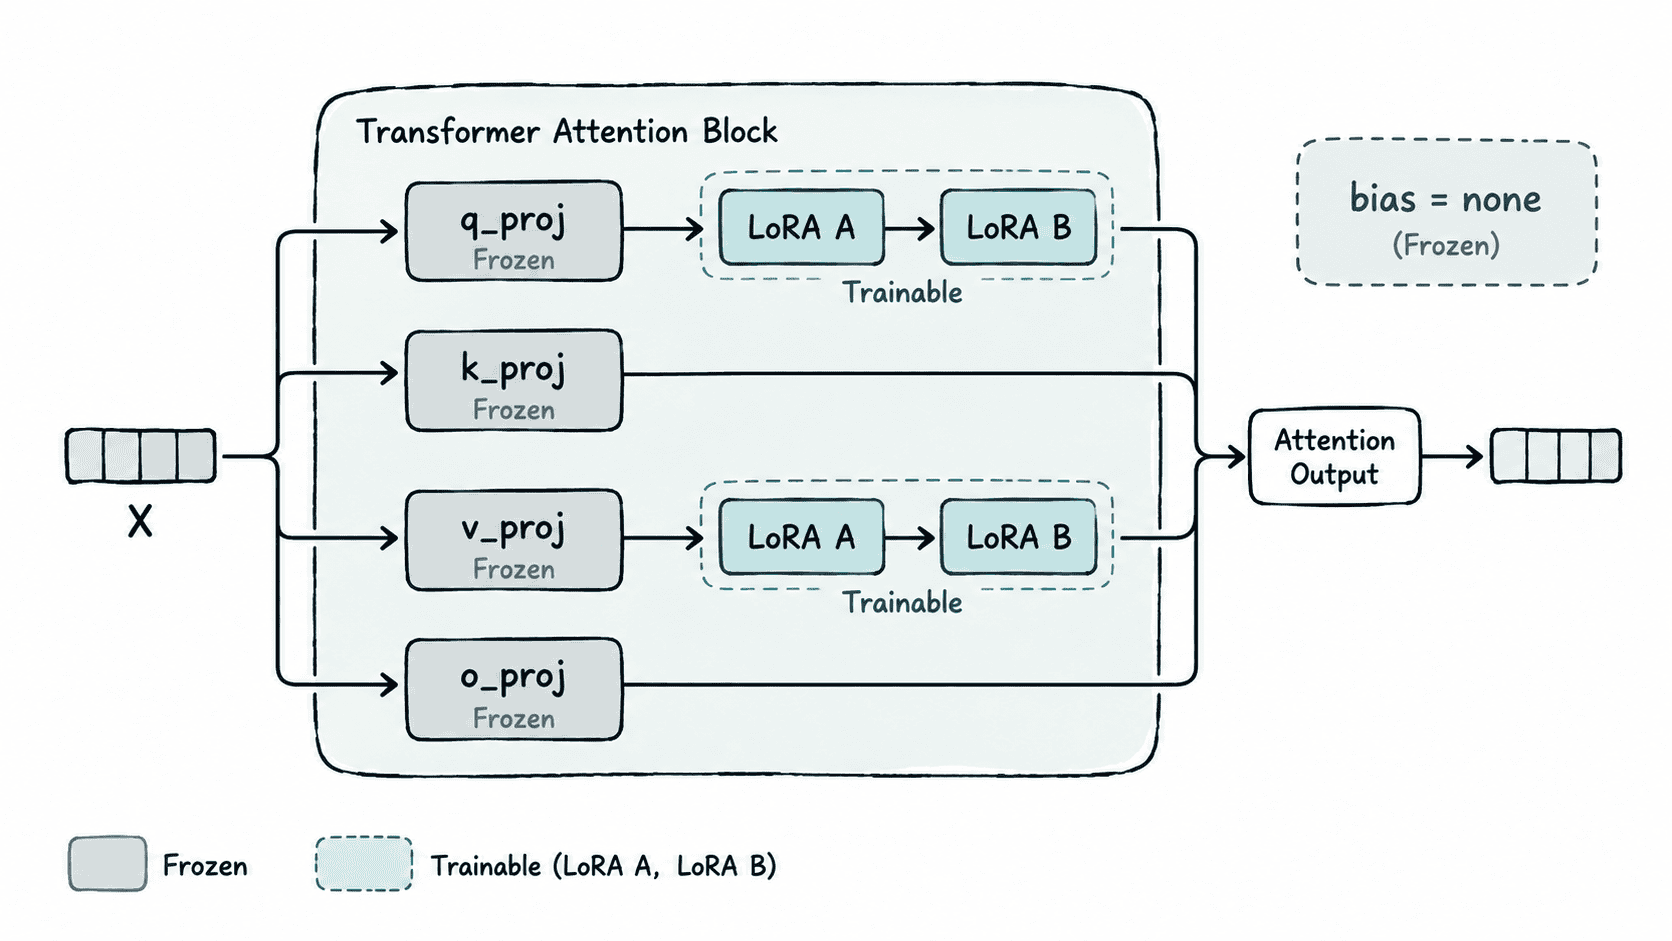
对因果语言模型,LoRA 通常把低秩矩阵插入注意力或前馈网络中的线性层。target_modules 决定“改哪里”,r 决定每个适配器的容量,lora_alpha 控制更新缩放,lora_dropout 只作用于 LoRA 分支;bias 则决定偏置参数是否跟着训练。
本例选择 q_proj 和 v_proj,并设置 bias="none"。这样基座权重和偏置保持冻结,可训练集合应只包含名字带 lora_ 的参数。若改成 bias="all" 或 bias="lora_only",可训练参数集合会扩大,后面的“只有 LoRA 参数可训练”检查也应相应调整。
用可运行脚本包装并核对
下面的脚本不下载模型权重,而是用 LlamaConfig 构造一个很小的因果语言模型,因此适合专门验证 LoRA 配置。运行环境需要已经安装 PyTorch、Transformers 与 PEFT。
import torch
from peft import LoraConfig, TaskType, get_peft_model
from transformers import LlamaConfig, LlamaForCausalLM

torch.manual_seed(0)

base_model = LlamaForCausalLM(
    LlamaConfig(
        vocab_size=128,
        hidden_size=64,
        intermediate_size=128,
        num_hidden_layers=2,
        num_attention_heads=4,
        num_key_value_heads=4,
        max_position_embeddings=64,
    )
)

lora_config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    r=8,
    lora_alpha=16,
    lora_dropout=0.0,
    target_modules=["q_proj", "v_proj"],
    bias="none",
)

model = get_peft_model(base_model, lora_config)

trainable, total = model.get_nb_trainable_parameters()
targeted_suffixes = sorted(
    {name.rsplit(".", 1)[-1] for name in model.targeted_module_names}
)
only_lora_trainable = all(
    ("lora_" in name) == parameter.requires_grad
    for name, parameter in model.named_parameters()
)

print(f"trainable: {trainable}")
print(f"total: {total}")
print(f"trainable_ratio: {trainable / total:.2%}")
print(f"targeted_suffixes: {targeted_suffixes}")
print(f"only_lora_trainable: {only_lora_trainable}")

with torch.no_grad():
    output = model(input_ids=torch.tensor([[1, 5, 7, 2]]))
print("logits_shape:", tuple(output.logits.shape))
预期输出
trainable: 4096
total: 102720
trainable_ratio: 3.99%
targeted_suffixes: ['q_proj', 'v_proj']
only_lora_trainable: True
logits_shape: (1, 4, 128)
这组结果同时验证了四件事:可训练参数远少于总参数;实际命中的模块后缀只有 q_proj 与 v_proj;冻结策略没有把基座参数意外打开;包装后的模型仍能产生形状正确的 logits。真实大模型的参数数量会不同,但核对方法不变。
目标模块必须按模型结构核实
不同架构的投影层命名并不统一,不能把某个模型的 q_proj、v_proj 机械复制到所有模型。配置前应先检查 named_modules() 或模型打印结果,确认目标字符串能匹配真实线性层;匹配范围过窄会导致容量不足,过宽则会增加显存、优化器状态和适配器文件大小。
排查时优先看三类信号:可训练参数占比是否与预期同量级,targeted_module_names 是否覆盖了预期层,所有 requires_grad=True 的参数名是否符合策略。只看“训练没有报错”并不足以证明 LoRA 配置正确,因为错误的目标范围也可能正常完成前向和反向计算。
当这三项检查都通过,再进入正式训练更稳妥:目标模块决定 LoRA 学什么,偏置策略决定除适配器外还有没有额外可训练权重,而一次成功的前向传播则确认包装没有破坏模型接口。