
大模型原理与训练 / 系统课时
运行 LoRA 监督微调任务
运行 LoRA 监督微调任务
LoRA 适配器配置正确后,下一步是把它交给监督微调训练器,并让批大小、梯度累积、学习率、评估和保存策略形成可复现的训练节奏。本文用离线可构造的小模型和小数据集跑完 4 个优化步骤,同时记录 loss、吞吐和峰值显存,并验收最终适配器文件。
学习目标
- 根据显存预算设置微批大小与梯度累积,并计算有效批大小。
- 用
SFTTrainer训练已经包装好的PeftModel,同时启用日志、评估和 checkpoint。 - 从 loss、吞吐、峰值显存和保存结果判断训练任务是否按预期运行。
先确定一个优化步骤包含多少样本
在单进程训练中,有效批大小可以先按 per_device_train_batch_size × gradient_accumulation_steps 计算;多进程数据并行时,再乘训练进程数。显存紧张时,通常先减小微批大小,再用梯度累积补回有效批大小,而不是直接让一次前向塞入更多样本。
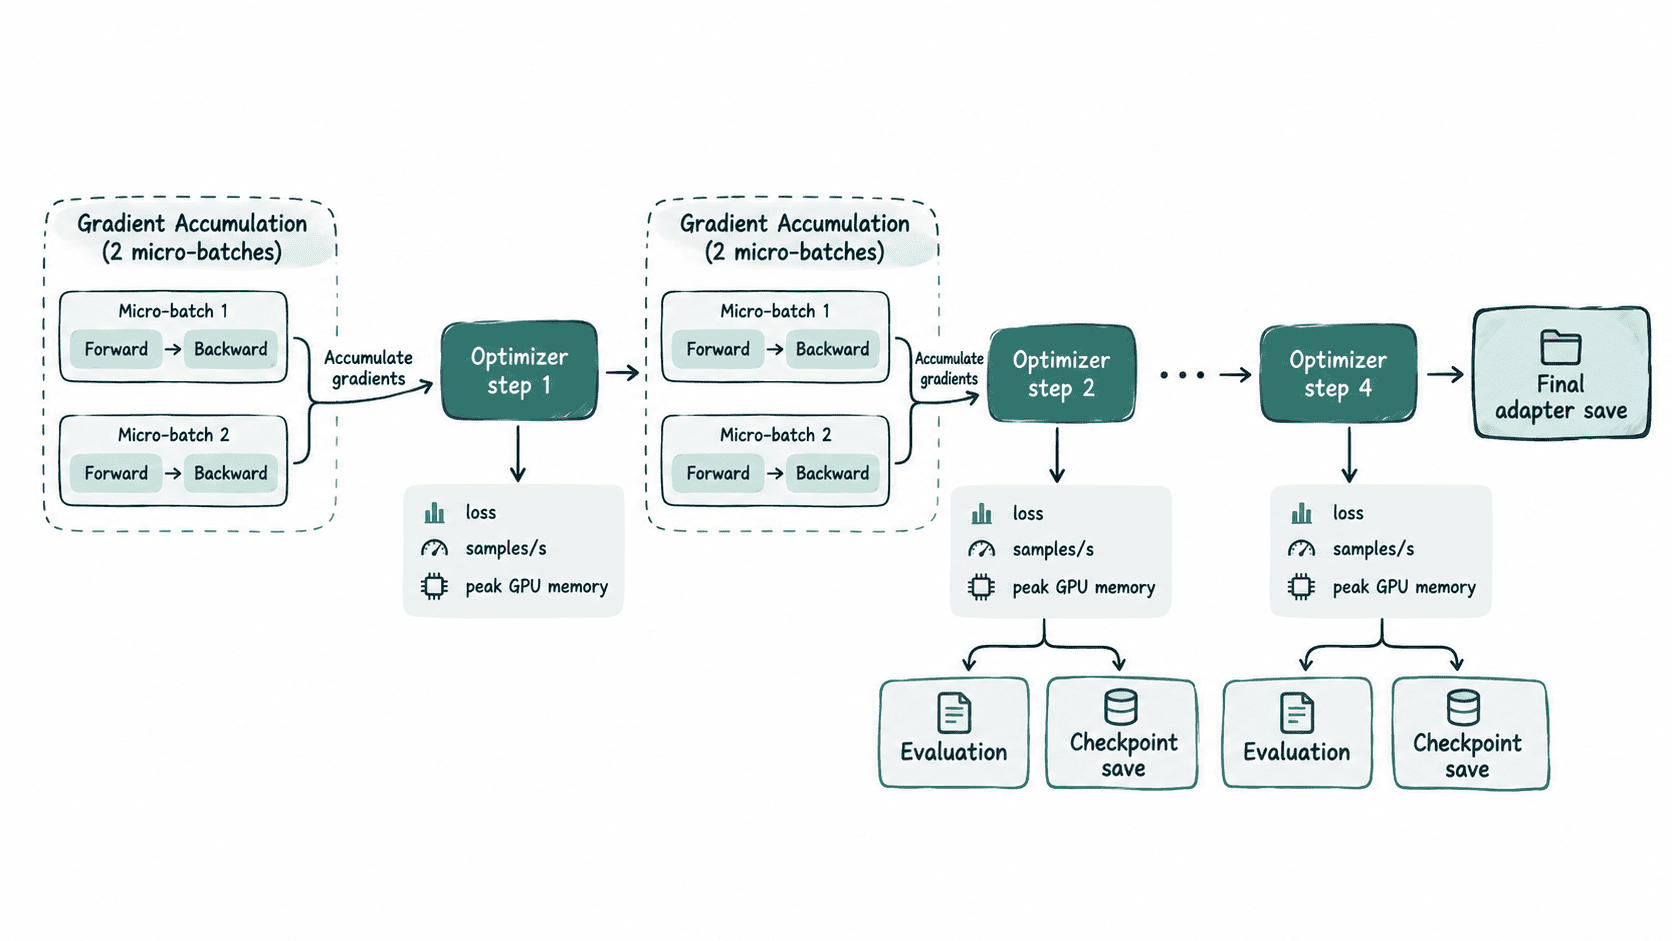
本例把单卡微批设为 1、梯度累积设为 2,因此每次参数更新累计 2 个样本。学习率设为 1e-3 是为了让极小的教学模型在 4 个步骤内产生可观察变化;换成真实预训练大模型时,应重新试验学习率,而不是照搬这个数值。
运行一个最小监督微调任务
下面的脚本用 tokenizers 在内存中训练一个小词表,再构造小型 Llama、包装 LoRA 并交给 SFTTrainer。它不依赖外部模型或数据集下载,适合先验证训练链路;运行环境需要 PyTorch、Transformers、PEFT、TRL、Datasets 与 Tokenizers。
import time
from pathlib import Path

import torch
from datasets import Dataset
from peft import LoraConfig, TaskType, get_peft_model
from tokenizers import Tokenizer
from tokenizers.models import WordLevel
from tokenizers.pre_tokenizers import Whitespace
from tokenizers.trainers import WordLevelTrainer
from transformers import (
    LlamaConfig,
    LlamaForCausalLM,
    PreTrainedTokenizerFast,
    TrainerCallback,
)
from trl import SFTConfig, SFTTrainer

train_texts = [
    "用户 加法 是 什么 助手 加法 把 两个 数 合并",
    "用户 减法 是 什么 助手 减法 表示 求 两数 之差",
    "用户 乘法 是 什么 助手 乘法 可以 看作 重复 加法",
    "用户 除法 是 什么 助手 除法 表示 平均 分组",
    "用户 太阳 从 哪里 升起 助手 太阳 从 东方 升起",
    "用户 水 的 冰点 是 什么 助手 标准 条件 下 是 零 摄氏度",
    "用户 一周 有 几天 助手 一周 有 七天",
    "用户 Python 列表 用 什么 括号 助手 使用 方括号",
]
eval_texts = [
    "用户 三加二 等于 几 助手 三加二 等于 五",
    "用户 一天 有 几小时 助手 一天 有 二十四 小时",
]

backend = Tokenizer(WordLevel(unk_token="<unk>"))
backend.pre_tokenizer = Whitespace()
backend.train_from_iterator(
    train_texts + eval_texts,
    WordLevelTrainer(
        special_tokens=["<pad>", "<bos>", "<eos>", "<unk>"]
    ),
)
tokenizer = PreTrainedTokenizerFast(
    tokenizer_object=backend,
    pad_token="<pad>",
    bos_token="<bos>",
    eos_token="<eos>",
    unk_token="<unk>",
)

base_model = LlamaForCausalLM(
    LlamaConfig(
        vocab_size=len(tokenizer),
        hidden_size=64,
        intermediate_size=128,
        num_hidden_layers=2,
        num_attention_heads=4,
        num_key_value_heads=4,
        max_position_embeddings=64,
        pad_token_id=tokenizer.pad_token_id,
        bos_token_id=tokenizer.bos_token_id,
        eos_token_id=tokenizer.eos_token_id,
    )
)
model = get_peft_model(
    base_model,
    LoraConfig(
        task_type=TaskType.CAUSAL_LM,
        r=8,
        lora_alpha=16,
        target_modules=["q_proj", "v_proj"],
        bias="none",
    ),
)

class StepMonitor(TrainerCallback):
    def on_step_begin(self, args, state, control, **kwargs):
        self.started = time.perf_counter()
        if torch.cuda.is_available():
            torch.cuda.reset_peak_memory_stats()

    def on_step_end(self, args, state, control, **kwargs):
        elapsed = max(time.perf_counter() - self.started, 1e-9)
        peak_gb = (
            torch.cuda.max_memory_allocated() / 1024**3
            if torch.cuda.is_available()
            else 0.0
        )
        print(
            f"step={state.global_step} "
            f"throughput={2 / elapsed:.2f} samples/s "
            f"peak_gpu={peak_gb:.3f} GB"
        )

    def on_log(self, args, state, control, logs=None, **kwargs):
        if logs and "loss" in logs:
            print(f"loss step={state.global_step} value={logs['loss']:.4f}")

args = SFTConfig(
    output_dir="./lora-sft-output",
    max_steps=4,
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    learning_rate=1e-3,
    logging_steps=1,
    logging_first_step=True,
    eval_strategy="steps",
    eval_steps=2,
    save_strategy="steps",
    save_steps=2,
    save_total_limit=2,
    max_length=64,
    dataset_text_field="text",
    gradient_checkpointing=False,
    optim="adamw_torch",
    report_to="none",
    disable_tqdm=True,
    dataloader_pin_memory=False,
    seed=7,
)

trainer = SFTTrainer(
    model=model,
    args=args,
    train_dataset=Dataset.from_dict({"text": train_texts}),
    eval_dataset=Dataset.from_dict({"text": eval_texts}),
    processing_class=tokenizer,
    callbacks=[StepMonitor()],
)

result = trainer.train()
trainer.save_model("./lora-sft-output/final")

train_losses = [x["loss"] for x in trainer.state.log_history if "loss" in x]
eval_losses = [
    x["eval_loss"] for x in trainer.state.log_history if "eval_loss" in x
]

print("global_step:", result.global_step)
print("train_loss_records:", len(train_losses))
print("eval_loss_records:", len(eval_losses))
print(
    "adapter_saved:",
    Path("./lora-sft-output/final/adapter_config.json").exists(),
)
预期输出
step=1 throughput=<FREQ> samples/s peak_gpu=<MEMORY> GB
loss step=1 value=<LOSS>
step=2 throughput=<FREQ> samples/s peak_gpu=<MEMORY> GB
loss step=2 value=<LOSS>
step=3 throughput=<FREQ> samples/s peak_gpu=<MEMORY> GB
loss step=3 value=<LOSS>
step=4 throughput=<FREQ> samples/s peak_gpu=<MEMORY> GB
loss step=4 value=<LOSS>
global_step: 4
train_loss_records: 4
eval_loss_records: 2
adapter_saved: True<FREQ>、<MEMORY> 与 <LOSS> 会随硬件、PyTorch 实现和随机初始化而变化;CPU 环境的 peak_gpu 为 0。训练器自身还可能输出评估字典和运行统计,但最后四行是本例的固定验收条件:执行了 4 次参数更新,按 step 2 和 step 4 完成两次评估,并成功保存适配器配置。
用日志判断训练是否健康
loss 不要求每一步都单调下降,小批量训练本来就会波动,应看一段窗口内的趋势以及评估 loss 是否同步恶化。若训练 loss 很快下降而评估 loss 持续上升,应优先检查数据量、训练步数和学习率,而不是继续增加 LoRA 秩。
吞吐要在序列长度和有效批大小相近时比较。若只有评估或保存步骤附近变慢,这是额外工作带来的正常抖动;若每一步都越来越慢,则应检查数据预处理、显存压力和是否发生频繁的 CPU/GPU 数据搬运。峰值显存则用于确认当前微批是否还有余量,接近设备上限时应先降低 per_device_train_batch_size。
评估与保存策略要和训练节奏对齐
示例每 2 个优化步骤评估并保存一次,因此 4 步训练会产生两次评估记录,并保留至多两个 checkpoint。正式训练时,评估过密会明显降低吞吐,保存过密还会增加磁盘写入;间隔过大则可能错过最佳模型或让故障恢复损失更多进度。
完成训练后,最终目录中的 adapter_config.json 是一个直接的验收信号:它说明保存的是 PEFT 适配器配置而不是整套基座权重。真正扩大到长序列或大模型时,仍应沿用同一顺序调参:先确定微批能否稳定放入显存,再用梯度累积恢复有效批大小,最后根据 loss、吞吐、显存和评估曲线决定是否调整学习率与训练步数。