
大模型原理与训练 / 系统课时
定位适合注入的线性层
定位适合注入的线性层
LoRA 是否真正生效,首先取决于 target_modules 是否匹配模型里的线性层。本节用一个本地构造的迷你 Llama 检查模块命名、区分注意力与 MLP 投影,并在注入后验证可训练参数,避免目标模块写错却继续训练。
学习目标
- 枚举模型中的线性层并识别注意力、MLP 与输出头
- 根据任务范围选择
q_proj、v_proj或更广的注入集合 - 用可训练参数数量验证 LoRA 已成功挂载
先看清 Transformer 里的线性层
同一种 Transformer 结构通常同时包含注意力投影和 MLP 投影。以 Llama 系模型为例,注意力常见 q_proj、k_proj、v_proj、o_proj,MLP 常见 gate_proj、up_proj、down_proj。lm_head 虽然也是线性层,但通常不属于默认 LoRA 注入目标。
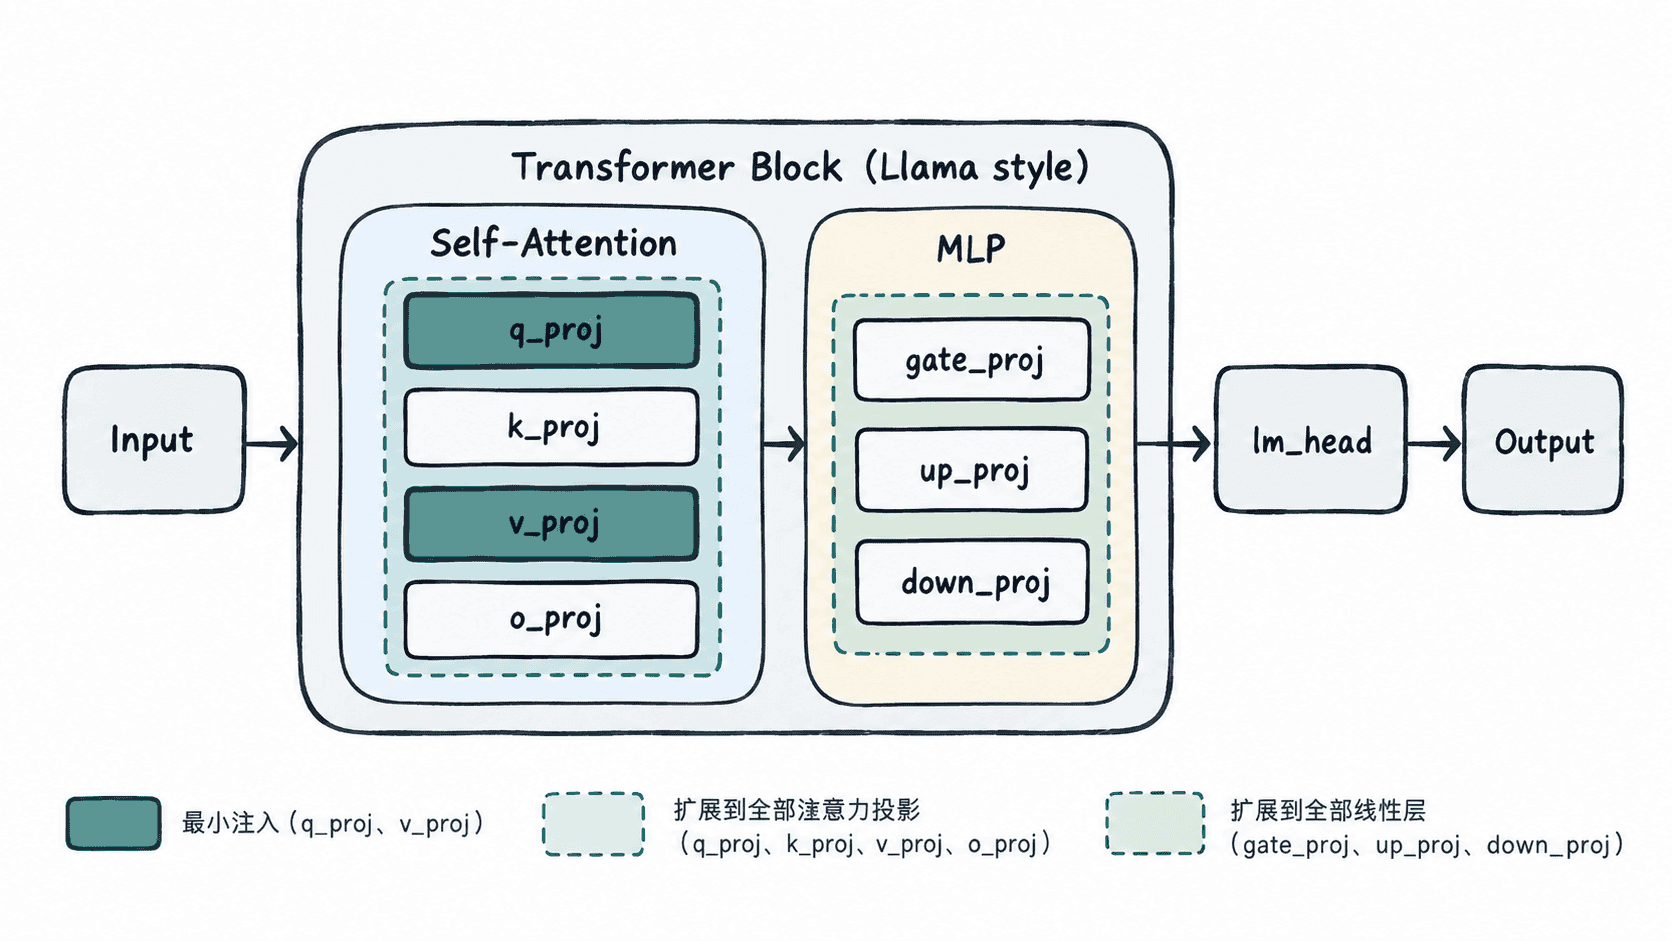
不同模型家族的命名并不统一,因此不要直接复制别人的 target_modules。最可靠的方法是先枚举当前模型,再按模块语义筛选。
枚举模块并验证注入
下面的示例不下载权重,而是用 LlamaConfig 构造一个很小的模型,因此可以直接观察标准模块名。安装 torch、transformers 与 peft 后即可运行。
import torch.nn as nn
from transformers import LlamaConfig, LlamaForCausalLM
from peft import LoraConfig, get_peft_model

config = LlamaConfig(
    vocab_size=128,
    hidden_size=64,
    intermediate_size=128,
    num_hidden_layers=1,
    num_attention_heads=4,
    num_key_value_heads=4,
)
model = LlamaForCausalLM(config)

suffixes = sorted({
    name.rsplit('.', 1)[-1]
    for name, module in model.named_modules()
    if isinstance(module, nn.Linear)
})
print('linear_suffixes=' + ','.join(suffixes))

targets = ['q_proj', 'v_proj']
peft_config = LoraConfig(
    r=8,
    lora_alpha=16,
    lora_dropout=0.05,
    target_modules=targets,
)
model = get_peft_model(model, peft_config)

trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)
print('selected=' + ','.join(targets))
print(f'trainable_parameters={trainable}')
预期输出
linear_suffixes=down_proj,gate_proj,k_proj,lm_head,o_proj,q_proj,up_proj,v_proj
selected=q_proj,v_proj
trainable_parameters=2048
如果真实模型没有这些后缀,新版本 PEFT 通常会直接报告找不到目标模块;即使没有报错,也应该检查可训练参数是否大于 0,并抽查参数名中是否出现 lora_A、lora_B。
决定注入范围
只注入 q_proj、v_proj 是一个保守起点:新增参数少,显存压力低,适合先验证数据和训练链路。任务差异较大、数据充足时,可以扩展到 k_proj、o_proj,再进一步覆盖 MLP 的 gate_proj、up_proj、down_proj。
注入范围越广,适配容量通常越高,但训练参数、优化器状态和计算量也随之增加。不要把“更多层”当成必然更好;更合理的做法是固定数据、秩和训练步数,只比较目标模块集合带来的验证集变化。
排除输出头和命名陷阱
lm_head 是否训练取决于任务设计。纯 LoRA 微调通常保持它冻结;只有词表扩展、特殊输出映射等场景,才需要单独评估是否训练输出头或使用 modules_to_save。
还要注意模型可能采用融合投影,例如一个 qkv_proj 同时产生 Q、K、V;也可能用 query_key_value、Wqkv 等命名。遇到这类结构时,应依据当前模型的 named_modules() 结果选择真实存在的层,而不是强行套用 q_proj、v_proj。最终标准很简单:目标层语义正确、LoRA 参数确实挂载、可训练参数数量符合预期。