
大模型原理与训练 / 系统课时
合并适配器与基座权重
合并适配器与基座权重
独立 LoRA 适配器适合频繁切换和复用同一基座,但有些推理服务只希望加载一个普通模型目录。本节把 LoRA 更新合并回基座权重,验证合并前后输出等价,并比较适配器目录与完整模型目录的体积差异。
学习目标
- 理解 LoRA 合并后模型结构和部署依赖发生的变化。
- 使用
merge_and_unload导出可独立加载的完整模型。 - 用固定输入验证合并前后数值结果,并据场景选择独立适配器或合并模型。
合并改变了什么
LoRA 推理时可以理解为在基座权重上叠加一个低秩增量。合并会把这部分增量直接写回目标层,得到新的完整权重;随后 LoRA 模块被卸载,导出的模型可以按普通 Transformers 模型加载,不再需要运行时额外挂载该适配器。
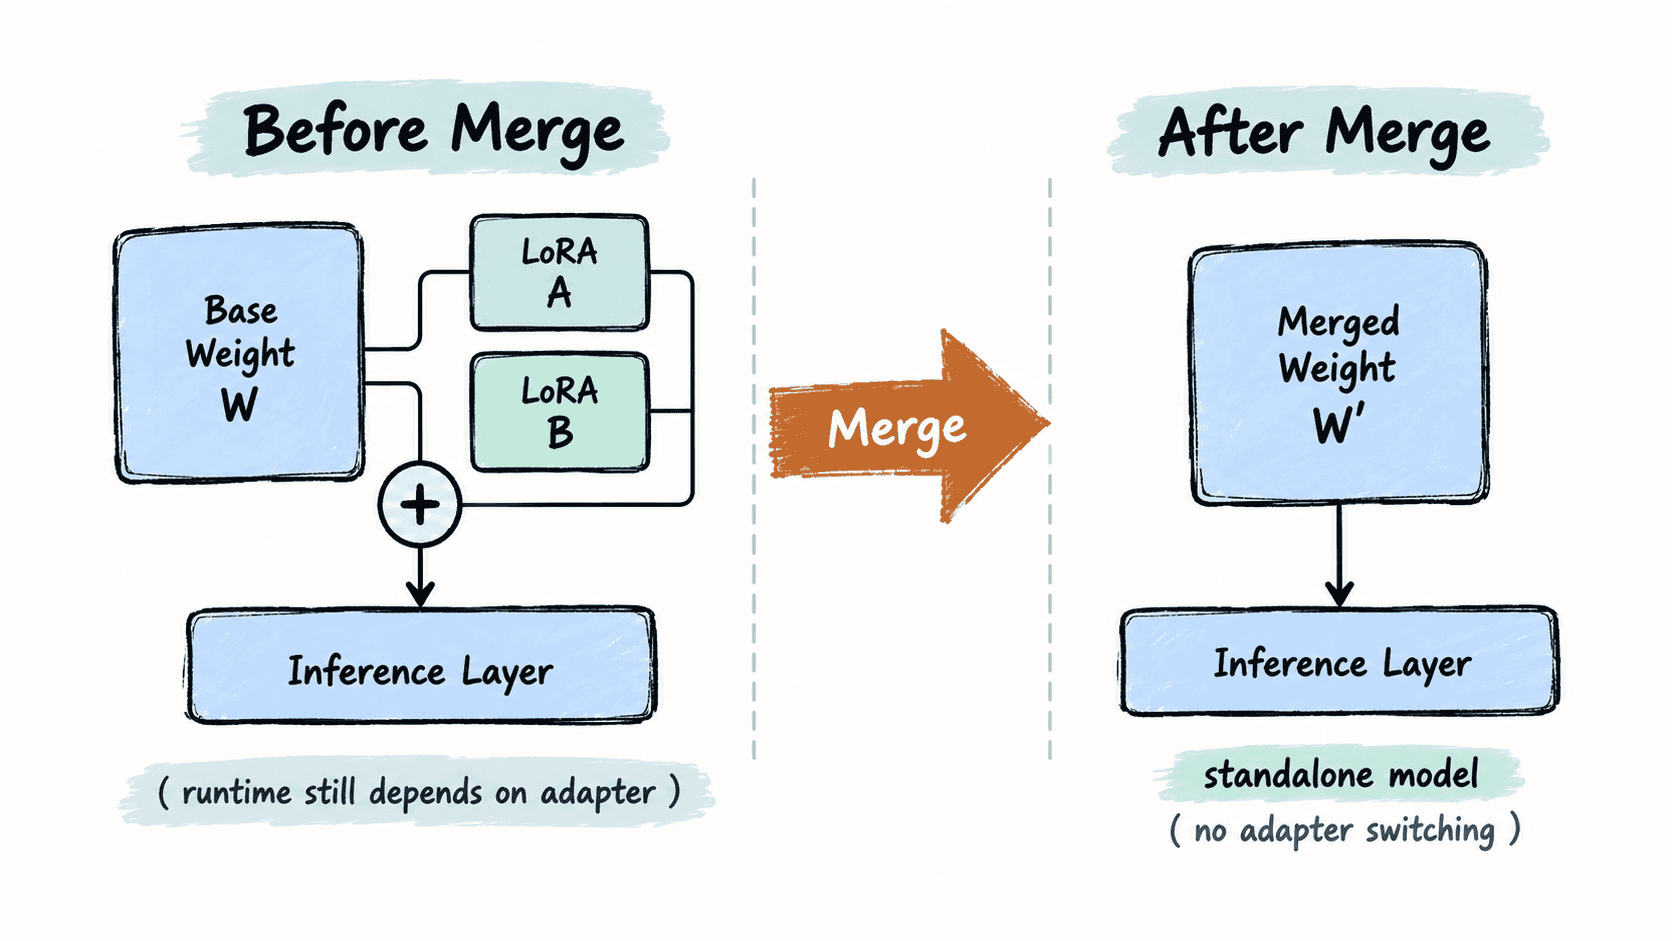
这一步换来的是更简单的部署形态,但也失去独立适配器的灵活性:合并后的单一模型不能再靠切换适配器回到另一个领域版本。需要同时服务多个领域时,通常应保留“共享基座 + 多适配器”;确定只部署一个版本时,合并模型更方便交给不理解 PEFT 的推理链路。
执行合并并验证
下面仍用一个本地小模型,先保存独立适配器,再调用 merge_and_unload 得到完整模型。脚本随后完全不用 PEFT 包装器重新加载导出目录,并比较固定输入下的 logits。
from pathlib import Path
import shutil

import torch
from transformers import GPT2Config, GPT2LMHeadModel
from peft import LoraConfig, get_peft_model

torch.manual_seed(11)

base_dir = Path("merge-base")
adapter_dir = Path("merge-adapter")
merged_dir = Path("merge-output")
for path in (base_dir, adapter_dir, merged_dir):
    shutil.rmtree(path, ignore_errors=True)

config = GPT2Config(
    vocab_size=64,
    n_positions=32,
    n_embd=32,
    n_layer=1,
    n_head=4,
    bos_token_id=1,
    eos_token_id=2,
)
GPT2LMHeadModel(config).save_pretrained(base_dir)

base = GPT2LMHeadModel.from_pretrained(base_dir)
model = get_peft_model(
    base,
    LoraConfig(
        r=4,
        lora_alpha=8,
        target_modules=["c_attn"],
        lora_dropout=0.0,
        bias="none",
        task_type="CAUSAL_LM",
    ),
)
model.eval()
model.save_pretrained(adapter_dir)

input_ids = torch.tensor([[1, 6, 10, 2]])
with torch.no_grad():
    logits_before = model(input_ids=input_ids).logits

# safe_merge 会在合并时执行额外安全检查;返回值要作为后续模型使用。
merged = model.merge_and_unload(safe_merge=True)
merged.save_pretrained(merged_dir)

standalone = GPT2LMHeadModel.from_pretrained(merged_dir).eval()
with torch.no_grad():
    logits_after = standalone(input_ids=input_ids).logits

torch.testing.assert_close(
    logits_before, logits_after, rtol=1e-4, atol=1e-5
)

def directory_bytes(path: Path) -> int:
    return sum(p.stat().st_size for p in path.rglob("*") if p.is_file())

adapter_bytes = directory_bytes(adapter_dir)
merged_bytes = directory_bytes(merged_dir)
print("outputs_close=True")
print(f"adapter_bytes={adapter_bytes}")
print(f"merged_bytes={merged_bytes}")
print(f"merged_larger_than_adapter={merged_bytes > adapter_bytes}")
预期输出
outputs_close=True
adapter_bytes=<ADAPTER_BYTES>
merged_bytes=<MERGED_BYTES>
merged_larger_than_adapter=True
<ADAPTER_BYTES> 与 <MERGED_BYTES> 会随 PEFT、Transformers 和序列化格式变化,因此不应写死;关键验收点是合并前后输出在允许误差内一致,而且独立适配器目录明显小于包含完整基座权重的合并目录。真实训练模型应把固定提示词集和任务指标一起纳入回归,而不只比较单个张量。
选择独立适配器还是合并模型
| 场景 | 更合适的形态 | 原因 |
|---|---|---|
| 一个基座服务多个领域 | 独立适配器 | 共享基座,切换快,增量文件小 |
| 适配器需要频繁升级 | 独立适配器 | 更新时不必重新发布整套基座权重 |
| 下游只接受普通模型目录 | 合并模型 | 推理端不需要理解 PEFT |
| 单一版本长期部署 | 合并模型 | 交付路径更简单,依赖更少 |
对量化基座或特殊 PEFT 方法,不要默认所有组合都能直接合并。应先确认当前方法与量化方式支持合并,再用目标精度重新加载导出结果做回归;如果部署端还要进行 INT8、INT4 等量化,通常也应把“合并后的最终模型”作为新的验收对象。
导出后的验收边界
合并成功不等于部署完成。最终交付至少要确认三件事:完整模型目录能在不加载适配器的情况下独立启动;Tokenizer 与特殊 Token 配置和训练阶段一致;固定评测集上的生成结果、任务指标和延迟没有出现不可接受的回退。
一旦已经确定只需要单一领域模型,合并可以把运行时的“基座 + 适配器”依赖收敛成一个普通模型工件;如果仍需要在多个领域之间动态切换,则保留独立适配器会更合适。