
大模型原理与训练 / 系统课时
设计指令与对话样本结构
设计指令与对话样本结构
微调数据的关键不是把文本塞进 JSON,而是把“谁在提出任务、谁提供上下文、谁应该生成答案”表达得稳定一致。本文给出单轮指令与多轮对话两种结构,并用角色校验规则避免 system、user、assistant 混用导致模型学习到错误行为。
学习目标
- 区分指令式样本与多轮
messages样本的适用场景。 - 正确安排
system、user、assistant的职责和顺序。 - 用简单校验规则发现缺失回答、角色错位和非法轮次。
先确定样本要表达什么
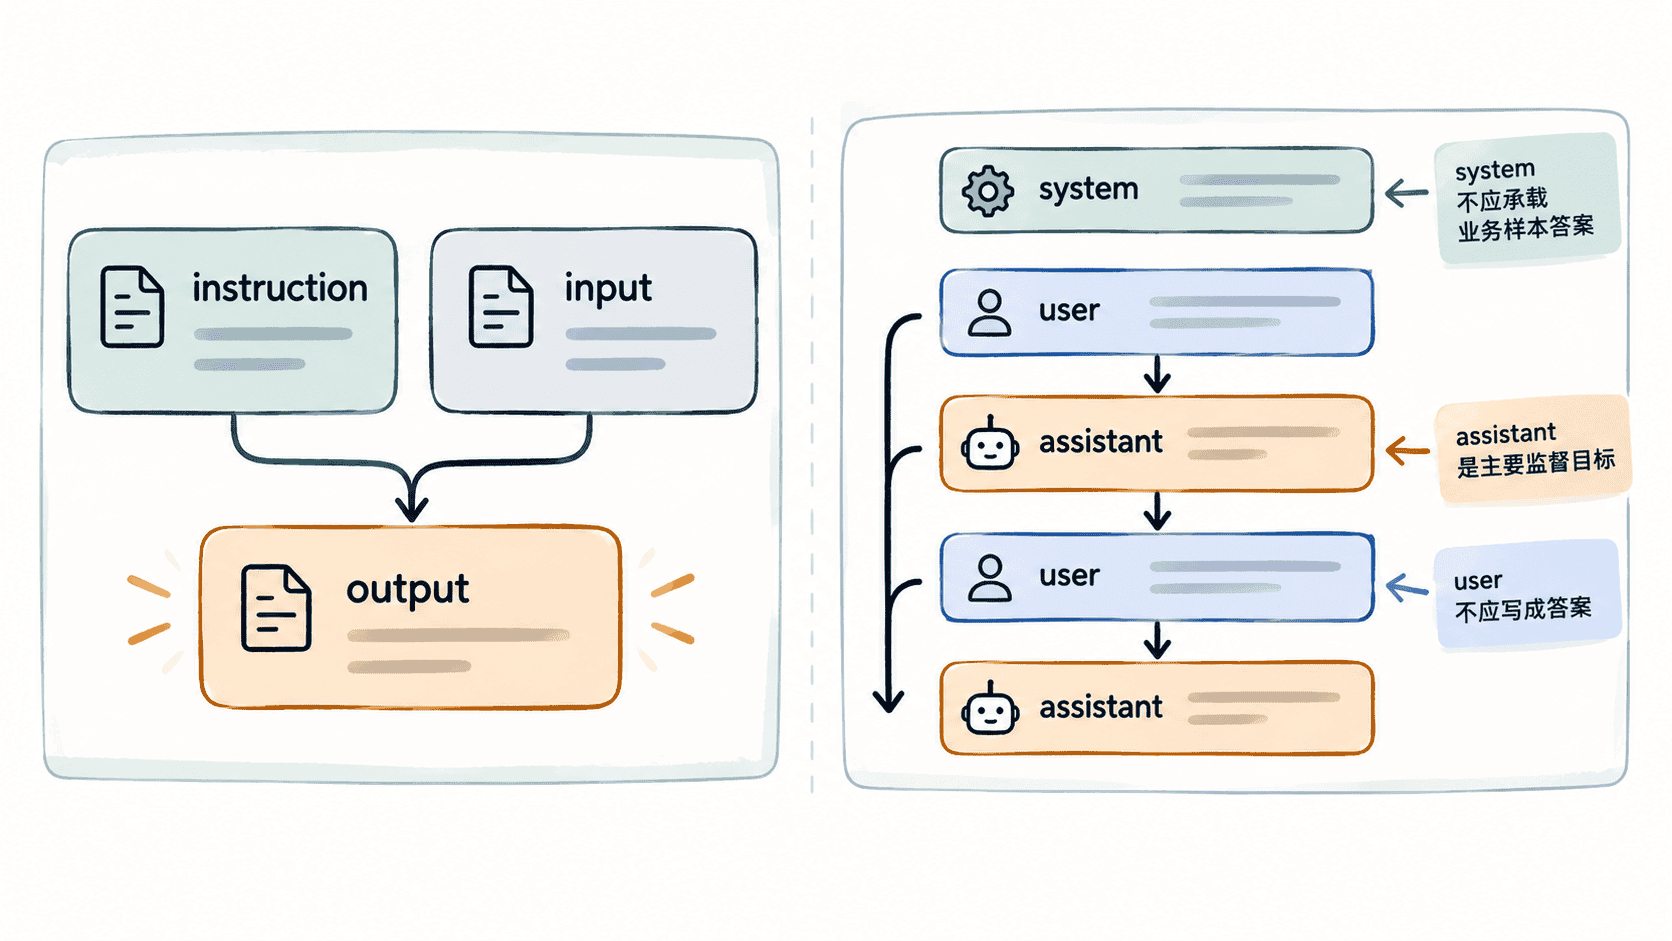
单轮任务适合“输入一个请求,得到一个目标回答”的数据,例如摘要、分类、信息抽取或固定格式生成。可以拆成 instruction、input、output 三部分,其中 instruction 描述任务,input 保存本条样本的业务内容,output 是训练期希望模型生成的答案。
{
  "instruction": "根据工单内容判断问题类别,只返回类别名称。",
  "input": "用户反馈付款成功,但订单仍显示待支付。",
  "output": "支付状态异常"
}
这是数据结构示例,不需要单独运行。若任务本身不需要额外输入,可以把 input 设为空字符串,但不要一会儿省略字段、一会儿保留字段,否则后续预处理会增加分支。
对于聊天模型,多轮 messages 更接近模型实际推理接口,也能表达上下文依赖。每条消息只承担一个角色职责。
{
  "messages": [
    {
      "role": "system",
      "content": "你是售后客服,只根据已知信息回答,不编造订单状态。"
    },
    {
      "role": "user",
      "content": "我的退款什么时候到账?"
    },
    {
      "role": "assistant",
      "content": "通常会原路退回。请提供退款申请时间,我再帮你判断当前进度。"
    },
    {
      "role": "user",
      "content": "昨天 14:30 提交的。"
    },
    {
      "role": "assistant",
      "content": "目前仍处于常见处理时段内,建议先等待支付渠道继续处理。"
    }
  ]
}
这同样是数据结构示例。真正送入模型前,还需要由对应 tokenizer 的 chat template 把消息序列转换成模型期望的特殊标记格式,不要手工猜测 <|user|>、<|assistant|> 等模板标记。
角色职责要稳定
system 用来描述长期行为边界,例如身份、输出约束和安全规则。它通常不是每条样本变化最大的部分。把具体问题答案写进 system 会让模型把业务事实误学成全局规则。
user 表示用户请求或后续补充信息,assistant 表示希望模型学习生成的内容。训练集里最常见的角色错误,是把参考答案放进 user,或让连续两个 assistant 消息没有对应的新上下文。这样的数据即使 JSON 完全合法,也会破坏监督信号。
多轮样本还要注意信息可得性:某个 assistant 回答只能依赖它之前已经出现的消息。若答案引用了后面轮次才提供的信息,模型学到的是无法在线复现的“提前知道答案”。
用校验器挡住结构错误
下面的脚本检查四个基本规则:messages 必须非空;system 如果存在只能位于开头;会话部分必须从 user 开始并按 user、assistant 交替;最后一条必须是 assistant,确保样本存在明确训练目标。
ALLOWED_ROLES = {"system", "user", "assistant"}

def validate_messages(messages: list[dict[str, str]]) -> None:
    if not messages:
        raise ValueError("messages must not be empty")

    for index, message in enumerate(messages):
        role = message.get("role")
        content = message.get("content")

        if role not in ALLOWED_ROLES:
            raise ValueError(f"invalid role at index {index}: {role}")
        if not isinstance(content, str) or not content.strip():
            raise ValueError(f"empty content at index {index}")
        if role == "system" and index != 0:
            raise ValueError("system message must be first")

    start = 1 if messages[0]["role"] == "system" else 0
    if start == len(messages):
        raise ValueError("conversation must contain user and assistant messages")

    for index in range(start, len(messages)):
        expected = "user" if (index - start) % 2 == 0 else "assistant"
        if messages[index]["role"] != expected:
            raise ValueError(f"expected {expected} at index {index}")

    if messages[-1]["role"] != "assistant":
        raise ValueError("last message must be assistant")

sample = [
    {"role": "system", "content": "你是售后客服。"},
    {"role": "user", "content": "订单可以改地址吗?"},
    {"role": "assistant", "content": "若尚未发货,可以尝试修改收货地址。"},
]

validate_messages(sample)
print("sample is valid")
预期输出
sample is valid这只是最小结构校验,不代表样本质量已经合格。生产数据还应检查重复样本、异常超长文本、空白答案、敏感信息以及答案是否与输入事实一致。
保持一种可训练的语义边界
同一数据集可以同时存在单轮和多轮业务,但送入同一训练管线前,最好归一到统一的模型输入结构。例如先把 instruction + input + output 转成 messages,再统一应用 tokenizer 的 chat template。这样格式差异留在预处理层,训练器只处理一种样本表示。
不要为了“信息更全”把标签、内部评分、数据来源、审核备注都塞进用户可见消息。只有推理时真正会提供给模型的信息才适合进入输入;只有希望模型生成的内容才应进入目标回答。结构稳定、角色一致、信息时序正确,比堆更多字段更能减少微调后的行为漂移。