
大模型原理与训练 / 系统课时
完成领域助手微调演练
完成领域助手微调演练
这一节把领域样本从清洗、切分到两组微调、评测、检查点选择和交付验收串成一条可复现流水线。最终产物既包含可独立保存的 LoRA 适配器,也保留可选合并路径,并用同一套验证集比较 QLoRA 与 BF16 LoRA 对照方案。
学习目标
- 用固定规则清洗领域指令数据,并生成可复现的训练集与验证集
- 在相同数据、随机种子和 LoRA 配置下运行 QLoRA 与 BF16 LoRA 对照实验
- 根据验证指标选择检查点,保存或合并适配器,并完成行为验收
先定义可交付的闭环
本次演练把 QLoRA 作为低成本方案,把 BF16 LoRA 作为对照方案。两组实验必须共享基座模型、数据切分、提示模板、LoRA 秩、训练轮数与随机种子;否则显存、损失和生成质量的差异不能归因于量化。
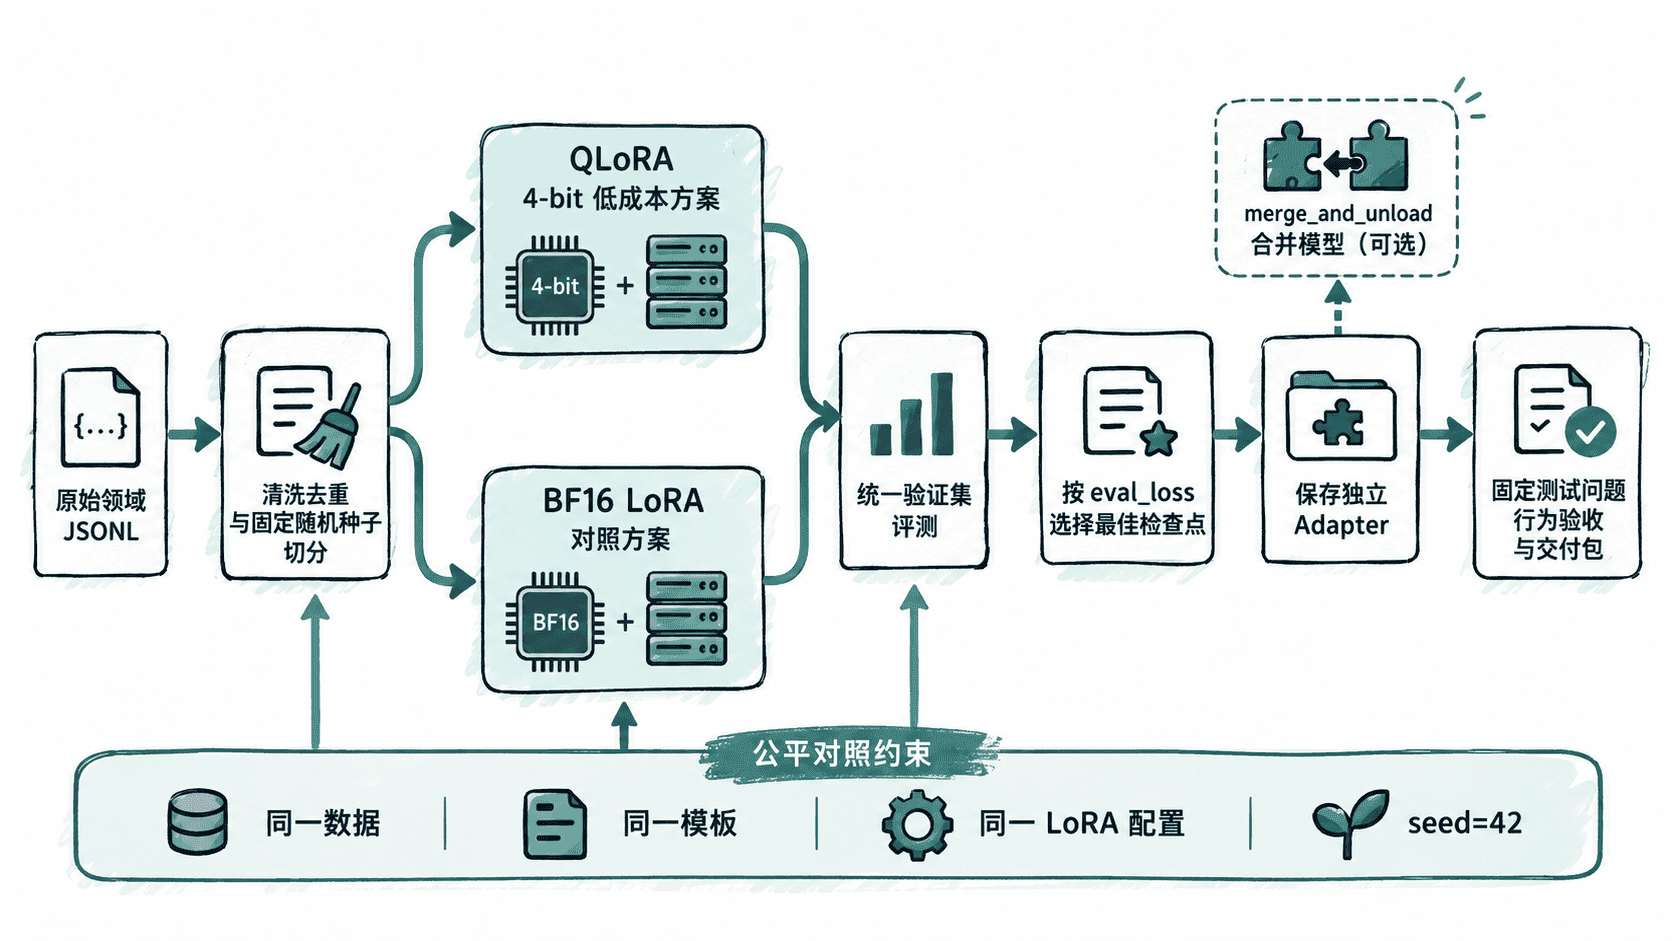
交付前至少记录三类证据:验证集 eval_loss、峰值显存,以及固定业务问题的通过率。低损失并不自动等于业务可用,因此最后一关必须加载真正要交付的适配器重新推理,而不是只看训练日志。
清洗并固定数据切分
原始 raw.jsonl 每行约定包含 instruction 和 response。下面的脚本会去掉空白样本、完全重复样本和过短回答,再以 seed=42 固定切分;同一份 train.jsonl 与 eval.jsonl 必须同时供两组实验使用。
# prepare_data.py
import argparse
import json
import random

def normalize(text: str) -> str:
    return " ".join(text.strip().split())

parser = argparse.ArgumentParser()
parser.add_argument("--input", required=True)
parser.add_argument("--train", required=True)
parser.add_argument("--eval", required=True)
parser.add_argument("--eval-ratio", type=float, default=0.1)
args = parser.parse_args()

# 先归一化再去重,避免仅由多余空白造成的重复样本。
rows = []
seen = set()
with open(args.input, "r", encoding="utf-8") as f:
    for line in f:
        item = json.loads(line)
        instruction = normalize(item.get("instruction", ""))
        response = normalize(item.get("response", ""))
        if not instruction or len(response) < 8:
            continue
        key = (instruction, response)
        if key in seen:
            continue
        seen.add(key)
        rows.append({"instruction": instruction, "response": response})

if len(rows) < 10:
    raise ValueError("清洗后至少需要 10 条样本,当前不足以稳定切分")

# 固定随机种子,让 QLoRA 与 LoRA 永远复用同一数据切分。
rng = random.Random(42)
rng.shuffle(rows)
eval_size = max(1, round(len(rows) * args.eval_ratio))
eval_rows = rows[:eval_size]
train_rows = rows[eval_size:]

# JSONL 保持一行一个样本,便于 datasets 直接读取。
for path, data in ((args.train, train_rows), (args.eval, eval_rows)):
    with open(path, "w", encoding="utf-8") as f:
        for item in data:
            f.write(json.dumps(item, ensure_ascii=False) + "\n")

print(f"clean={len(rows)} train={len(train_rows)} eval={len(eval_rows)} seed=42")
预期输出
clean=<ID> train=<ID> eval=<ID> seed=42其中 <ID> 会随原始样本数变化,但必须满足 clean = train + eval,并且两次以相同输入运行时计数和切分内容保持一致。
运行 QLoRA 与对照方案
先准备单卡 CUDA 环境。bitsandbytes 用于 4-bit QLoRA;BF16 LoRA 对照要求显卡原生支持 BF16,并且显存通常明显高于 QLoRA。
# 安装训练与 PEFT 所需依赖,并立即验证 CUDA 与 BF16 能力。
python -m pip install "torch" "transformers" "datasets" "peft" "accelerate" "bitsandbytes"
python - <<'PY'
import torch, transformers, peft
print("cuda=", torch.cuda.is_available())
print("bf16=", torch.cuda.is_bf16_supported())
print("transformers=", transformers.__version__)
print("peft=", peft.__version__)
PY
预期输出
cuda= True
bf16= True
transformers= <VERSION>
peft= <VERSION>
若 cuda 或 bf16 为 False,不要继续做这组公平对照;应先更换支持 BF16 的 GPU 环境。下面的训练脚本只改变基座权重的加载精度,其余关键超参数保持一致。<MODEL_ID> 请替换为同一个可用于因果语言建模的基座模型。
# train_domain.py
import argparse
import json
import math
import os
import torch
from datasets import load_dataset
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    DataCollatorForLanguageModeling,
    Trainer,
    TrainingArguments,
)

parser = argparse.ArgumentParser()
parser.add_argument("--model", required=True)
parser.add_argument("--train", required=True)
parser.add_argument("--eval", required=True)
parser.add_argument("--mode", choices=["qlora", "lora"], required=True)
parser.add_argument("--output", required=True)
args = parser.parse_args()

tokenizer = AutoTokenizer.from_pretrained(args.model, use_fast=True)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

# 两个实验使用完全相同的提示模板与最大序列长度。
files = {"train": args.train, "validation": args.eval}
dataset = load_dataset("json", data_files=files)

def tokenize(batch):
    texts = [
        f"### 指令\n{i}\n### 回答\n{r}{tokenizer.eos_token}"
        for i, r in zip(batch["instruction"], batch["response"])
    ]
    return tokenizer(texts, truncation=True, max_length=1024, padding=False)

tokenized = dataset.map(
    tokenize,
    batched=True,
    remove_columns=dataset["train"].column_names,
)

# 唯一的方案差异是基座权重:QLoRA 用 NF4 4-bit,LoRA 用 BF16。
if args.mode == "qlora":
    quant_config = BitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_use_double_quant=True,
        bnb_4bit_compute_dtype=torch.bfloat16,
    )
    model = AutoModelForCausalLM.from_pretrained(
        args.model,
        quantization_config=quant_config,
        device_map="auto",
    )
    model = prepare_model_for_kbit_training(model)
else:
    model = AutoModelForCausalLM.from_pretrained(
        args.model,
        torch_dtype=torch.bfloat16,
        device_map="auto",
    )

# all-linear 避免把目标模块名写死在某一种模型架构上。
model.config.use_cache = False
model = get_peft_model(
    model,
    LoraConfig(
        r=16,
        lora_alpha=32,
        lora_dropout=0.05,
        bias="none",
        task_type="CAUSAL_LM",
        target_modules="all-linear",
    ),
)

# 每个 epoch 都评测和保存,训练结束后自动回载 eval_loss 最低的检查点。
training_args = TrainingArguments(
    output_dir=args.output,
    num_train_epochs=3,
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=8,
    learning_rate=2e-4,
    logging_steps=10,
    eval_strategy="epoch",
    save_strategy="epoch",
    save_total_limit=2,
    load_best_model_at_end=True,
    metric_for_best_model="eval_loss",
    greater_is_better=False,
    bf16=True,
    report_to="none",
    seed=42,
)

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized["train"],
    eval_dataset=tokenized["validation"],
    data_collator=DataCollatorForLanguageModeling(tokenizer, mlm=False),
)

torch.cuda.reset_peak_memory_stats()
trainer.train()
metrics = trainer.evaluate()

# save_model 保存的是已回载最佳检查点后的 PEFT 适配器。
adapter_dir = os.path.join(args.output, "adapter")
trainer.save_model(adapter_dir)
tokenizer.save_pretrained(adapter_dir)
result = {
    "mode": args.mode,
    "best_checkpoint": trainer.state.best_model_checkpoint,
    "eval_loss": round(metrics["eval_loss"], 4),
    "perplexity": round(math.exp(metrics["eval_loss"]), 2),
    "peak_vram_gb": round(torch.cuda.max_memory_allocated() / 1024**3, 2),
    "adapter_dir": adapter_dir,
}
with open(os.path.join(args.output, "result.json"), "w", encoding="utf-8") as f:
    json.dump(result, f, ensure_ascii=False, indent=2)
print(json.dumps(result, ensure_ascii=False))
预期结果
{"mode":"<MODE>","best_checkpoint":"<PATH>","eval_loss":<VALUE>,"perplexity":<VALUE>,"peak_vram_gb":<VALUE>,"adapter_dir":"<PATH>"}用相同输入顺序执行两组实验:
# 先生成一次固定切分,再让两个实验复用这两个文件。
python prepare_data.py --input raw.jsonl --train train.jsonl --eval eval.jsonl
python train_domain.py --model <MODEL_ID> --train train.jsonl --eval eval.jsonl --mode qlora --output runs/qlora
python train_domain.py --model <MODEL_ID> --train train.jsonl --eval eval.jsonl --mode lora --output runs/lora
预期输出
clean=<ID> train=<ID> eval=<ID> seed=42
{"mode":"qlora","best_checkpoint":"<PATH>","eval_loss":<VALUE>,"perplexity":<VALUE>,"peak_vram_gb":<VALUE>,"adapter_dir":"runs/qlora/adapter"}
{"mode":"lora","best_checkpoint":"<PATH>","eval_loss":<VALUE>,"perplexity":<VALUE>,"peak_vram_gb":<VALUE>,"adapter_dir":"runs/lora/adapter"}
比较时先看业务质量是否接近,再看显存收益。若 QLoRA 的验证损失和固定问题通过率与 LoRA 接近,而峰值显存明显更低,就优先交付 QLoRA 适配器;若质量差距不可接受,则回到数据、学习率或 LoRA 容量继续实验,而不是直接用更低损失的一组覆盖业务判断。
选择检查点并处理适配器
脚本启用了 load_best_model_at_end=True,因此训练结束后内存中的模型已经回到验证集 eval_loss 最低的保存点,随后写出的 adapter 目录就是候选交付物。交付时至少保留 adapter_model.safetensors、适配器配置、Tokenizer 文件、result.json 以及基座模型标识;这样体积小,也最容易回溯。
如果推理平台不支持动态挂载 PEFT 适配器,可以在显存足够的机器上把适配器合回非量化基座。下面脚本会生成独立的合并目录,不覆盖原始适配器。
# merge_adapter.py
import argparse
import torch
from peft import PeftModel
from transformers import AutoModelForCausalLM, AutoTokenizer

parser = argparse.ArgumentParser()
parser.add_argument("--model", required=True)
parser.add_argument("--adapter", required=True)
parser.add_argument("--output", required=True)
args = parser.parse_args()

# 从非量化 BF16 基座重新挂载适配器,避免把 4-bit 基座当成交付母本。
base = AutoModelForCausalLM.from_pretrained(
    args.model,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
model = PeftModel.from_pretrained(base, args.adapter)
merged = model.merge_and_unload()
merged.save_pretrained(args.output, safe_serialization=True)

# Tokenizer 与模型一起保存,保证新进程可以直接加载。
tokenizer = AutoTokenizer.from_pretrained(args.adapter)
tokenizer.save_pretrained(args.output)
print(f"merged_model={args.output}")
预期输出
merged_model=<PATH>用真实交付物做验收
最终验收要从候选目录重新加载模型,而不是复用训练进程。先把不会泄漏训练答案的固定业务问题保存为 cases.json;must_include 只放真正必要的领域术语,不要把完整参考答案拆成关键词。
[
  {"instruction":"<DOMAIN_QUESTION_1>","must_include":["<TERM_1>"]},
  {"instruction":"<DOMAIN_QUESTION_2>","must_include":["<TERM_2>"]},
  {"instruction":"<DOMAIN_QUESTION_3>","must_include":["<TERM_3>"]}
]
该文件是验收配置,不产生控制台输出;验证方法是由下面脚本读取全部用例,并按 90% 通过率设置退出码。
# smoke_test.py
import argparse
import json
import torch
from peft import PeftModel
from transformers import AutoModelForCausalLM, AutoTokenizer

parser = argparse.ArgumentParser()
parser.add_argument("--model", required=True)
parser.add_argument("--adapter", required=True)
parser.add_argument("--cases", required=True)
args = parser.parse_args()

# 必须从候选交付目录重新加载,避免误用训练进程里的内存状态。
tokenizer = AutoTokenizer.from_pretrained(args.adapter)
base = AutoModelForCausalLM.from_pretrained(
    args.model,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
model = PeftModel.from_pretrained(base, args.adapter)
model.eval()

with open(args.cases, "r", encoding="utf-8") as f:
    cases = json.load(f)
if not cases:
    raise ValueError("cases.json 不能为空")

passed = 0
for index, case in enumerate(cases, start=1):
    prompt = f"### 指令\n{case['instruction']}\n### 回答\n"
    inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
    # 贪心解码减少采样随机性,让回归验收更容易复现。
    with torch.no_grad():
        output = model.generate(**inputs, max_new_tokens=128, do_sample=False)
    text = tokenizer.decode(
        output[0][inputs["input_ids"].shape[1]:],
        skip_special_tokens=True,
    )
    ok = all(term in text for term in case["must_include"])
    passed += int(ok)
    print(f"case_{index:02d}: {'PASS' if ok else 'FAIL'}")

# 关键词通过率只是机器门槛,事实正确性和拒答边界仍要人工抽查。
rate = passed / len(cases)
print(f"pass_rate={rate:.2%}")
if rate < 0.90:
    raise SystemExit("delivery rejected")
预期结果
case_01: <PASS_OR_FAIL>
case_02: <PASS_OR_FAIL>
case_03: <PASS_OR_FAIL>
pass_rate=<VALUE>%
只有当脚本退出码为 0、固定问题通过率达到门槛、人工抽查无明显事实错误,并且交付目录能在全新进程中重新加载时,候选适配器才算通过。把 result.json 与测试用例版本一并归档,后续就能准确说明“用什么数据、什么方案、哪个检查点、以什么标准”得到当前模型。