
大模型原理与训练 / 系统课时
验证 CUDA 与混合精度能力
验证 CUDA 与混合精度能力
训练前先把“GPU 能否被框架正确使用”和“该用 BF16 还是 FP16”验证清楚。本文用驱动查询、PyTorch 能力检测和一次最小矩阵计算,确认设备可见性、精度支持与实际计算路径,避免到微调阶段才暴露兼容问题。
学习目标
- 检查驱动、GPU 型号、显存和 CUDA 运行环境是否可见。
- 用 PyTorch 判断 CUDA、BF16 与 FP16 相关能力,并完成最小计算验证。
- 根据硬件能力选择 BF16、FP16 或回退方案。
先确认驱动与 GPU 可见
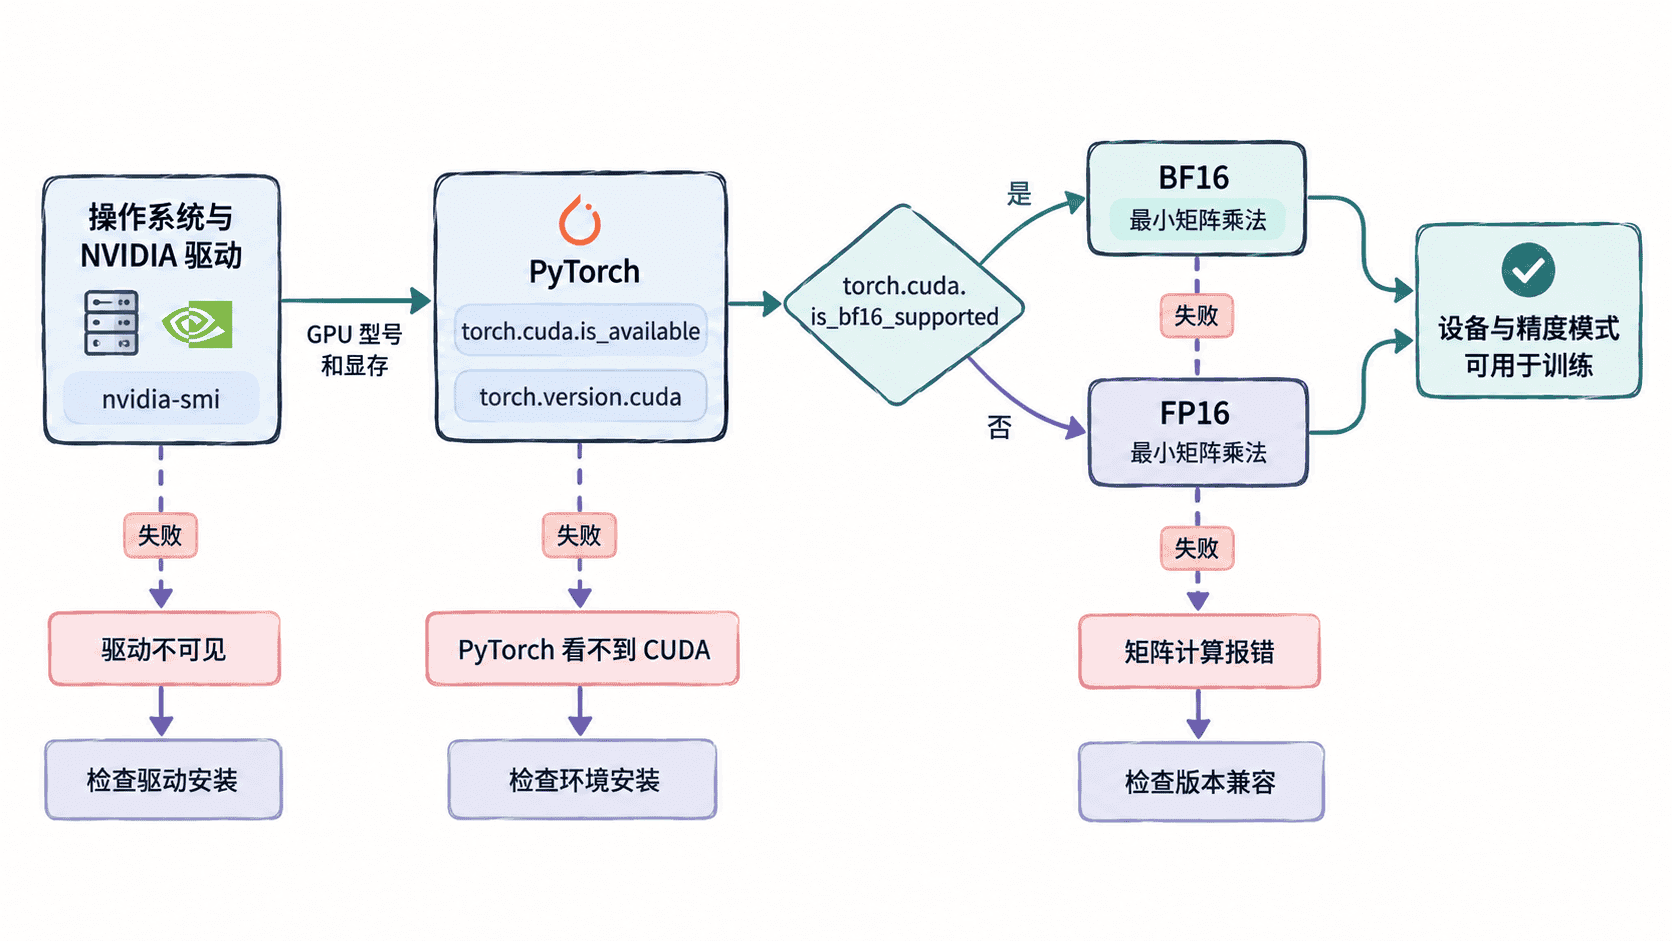
第一层只验证操作系统和驱动。nvidia-smi 能正常返回 GPU,说明 NVIDIA 驱动已工作;它显示的 CUDA Version 表示驱动可支持的最高 CUDA 版本,不等于当前 Python 环境实际链接的 CUDA Runtime 版本。
nvidia-smi --query-gpu=name,driver_version,memory.total --format=csv,noheader预期输出
NVIDIA <GPU_MODEL>, <DRIVER_VERSION>, <MEMORY_TOTAL> MiB型号、驱动版本和显存会因机器而不同。若命令不存在、提示无法与驱动通信,或根本看不到目标 GPU,应先修复驱动或容器的 GPU 映射,不要继续排查训练代码。
用 PyTorch 做能力探测
下面的最小脚本同时检查 PyTorch 自身版本、它编译时绑定的 CUDA Runtime、GPU 名称、BF16 支持情况,并分别尝试 FP16 与 BF16 矩阵乘法。它比只看版本号更可靠,因为最终验证的是实际张量能否在目标精度下执行。
import torch

def try_matmul(dtype: torch.dtype) -> None:
    x = torch.randn((256, 256), device="cuda", dtype=dtype)
    y = torch.randn((256, 256), device="cuda", dtype=dtype)
    z = x @ y
    print(f"{dtype}: ok, shape={tuple(z.shape)}, device={z.device}")

def main() -> None:
    print("torch:", torch.__version__)
    print("torch_cuda:", torch.version.cuda)
    print("cuda_available:", torch.cuda.is_available())

    if not torch.cuda.is_available():
        raise SystemExit("CUDA is not available to PyTorch")

    print("gpu:", torch.cuda.get_device_name(0))
    print("bf16_supported:", torch.cuda.is_bf16_supported())
    try_matmul(torch.float16)

    if torch.cuda.is_bf16_supported():
        try_matmul(torch.bfloat16)

if __name__ == "__main__":
    main()
预期输出
torch: <TORCH_VERSION>
torch_cuda: <CUDA_RUNTIME_VERSION>
cuda_available: True
gpu: <GPU_MODEL>
bf16_supported: True
torch.float16: ok, shape=(256, 256), device=cuda:0
torch.bfloat16: ok, shape=(256, 256), device=cuda:0
如果 bf16_supported 为 False,最后一行不会出现,这是脚本的预期分支,并不代表 CUDA 故障。版本、型号和 Runtime 版本属于动态值,实际结果可能不同。
选择 BF16、FP16 还是回退
如果硬件原生支持 BF16,训练大模型时通常优先选择 BF16。它与 FP32 具有相同的指数位宽,数值范围更大,较少因为梯度过大或过小触发溢出;代价是尾数精度低于 FP16,但对神经网络训练通常更稳定。
FP16 适合支持 Tensor Core 但缺少 BF16 能力的较早 GPU。FP16 的数值范围更窄,训练时往往需要梯度缩放。若 CUDA 本身不可用,或目标算子在半精度下持续报错,应先退回 FP32 验证功能正确,再定位驱动、PyTorch、CUDA Runtime 与算子兼容性。
常见失败的定位顺序
遇到 torch.cuda.is_available() 为 False 时,先看 nvidia-smi。如果系统层已经失败,问题通常在驱动或容器映射;如果系统层正常而 PyTorch 看不到 CUDA,则重点检查是否误装 CPU 版 PyTorch,以及当前环境的 PyTorch 构建与驱动是否兼容。
如果 CUDA 可见但半精度矩阵计算失败,先确认失败只发生在某个 dtype 还是所有 CUDA 计算都失败。仅 BF16 失败时可以改用 FP16;FP16 与 BF16 都失败时,则不应直接开始 LoRA 或 QLoRA 训练。先把最小张量计算跑通,后续出现的显存不足、量化算子缺失或训练参数问题才有明确的排查边界。