
大模型原理与训练 / 系统课时
选择基座模型与许可边界
选择基座模型与许可边界
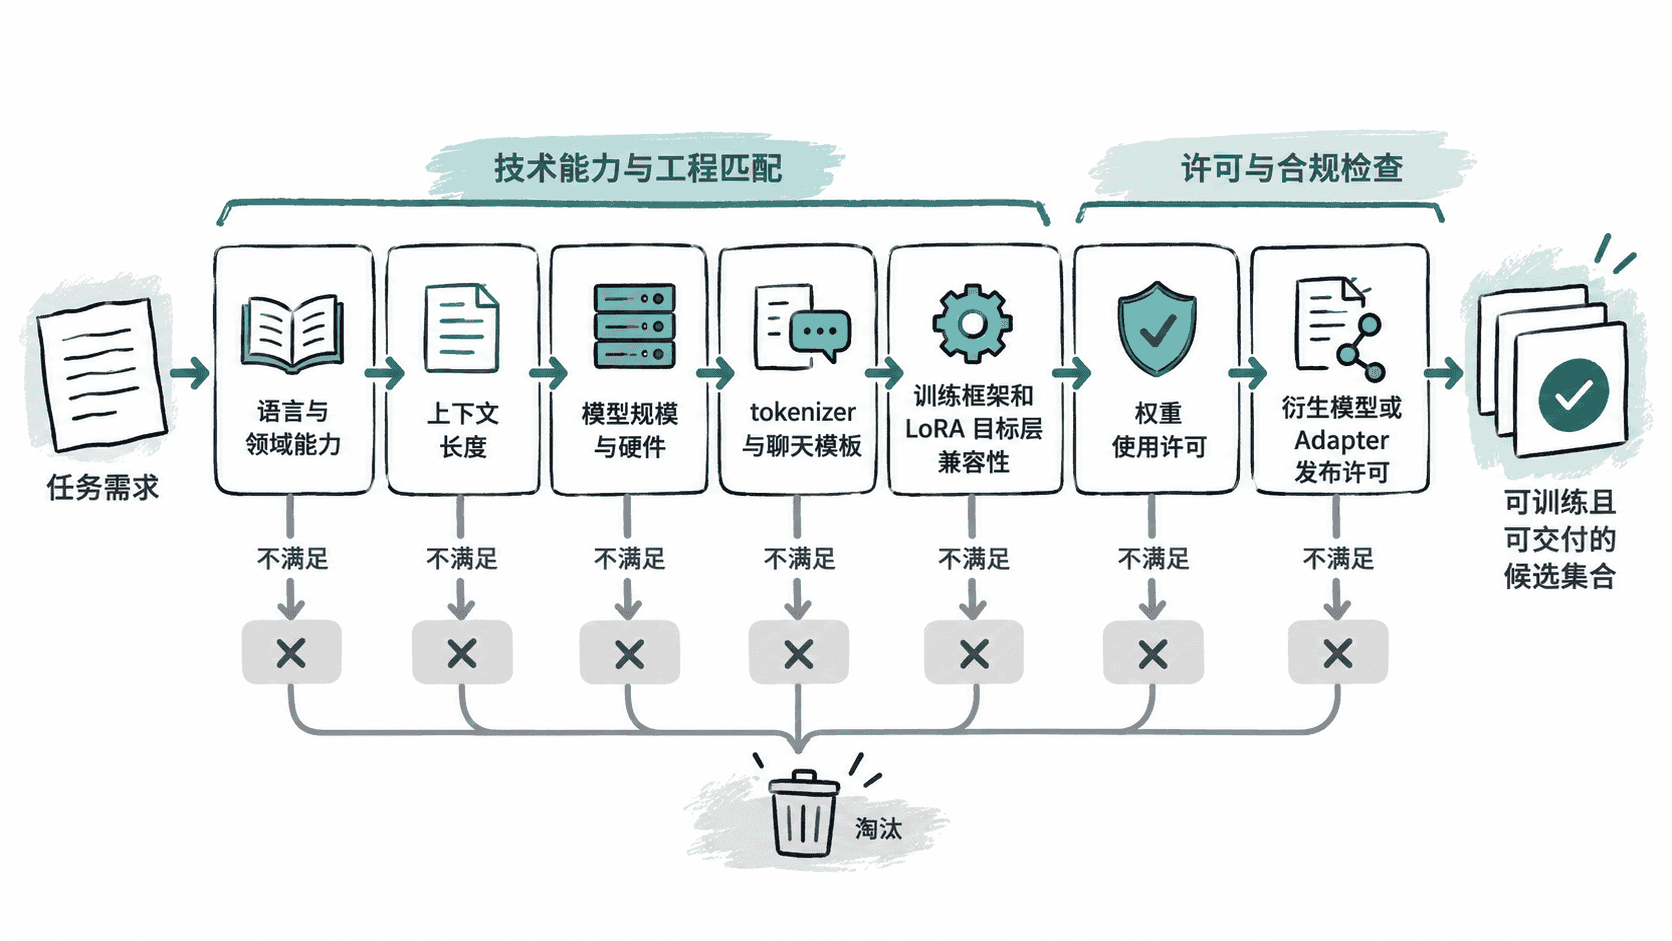
基座模型选错,问题往往要到训练完成甚至准备交付时才暴露:语言能力不匹配、上下文不够、聊天模板错误,或者许可证根本不允许预期的使用和发布方式。本节建立一套先筛技术条件、再核许可边界的选择流程。
学习目标
- 根据任务语言、上下文、模型规模和训练资源筛选基座模型
- 检查 tokenizer、聊天模板和 LoRA 目标层等训练兼容性
- 区分权重使用、衍生模型发布和配套资源各自的许可要求
先用任务约束砍掉大部分候选
选择基座模型时,不要先问“哪个模型排行榜最高”,而要先写出不能妥协的任务条件。候选模型只有同时满足这些条件,后续微调才值得投入资源。
| 筛选维度 | 需要确认的问题 | 典型淘汰原因 |
|---|---|---|
| 任务与语言 | 目标语言、领域和输出形式是否属于模型能力范围 | 目标语言能力明显不足 |
| 上下文长度 | 训练样本和线上请求实际需要多少 Token | 所需上下文超过可用范围 |
| 模型规模 | 权重、激活值和训练状态能否放进现有资源 | 即使 QLoRA 也无法稳定运行 |
| 输入格式 | tokenizer、特殊 Token、聊天模板是否与数据格式匹配 | 模板与模型训练格式不一致 |
| 交付方式 | 最终是内部推理、发布 Adapter,还是发布合并权重 | 许可证不允许预期用途 |
模型声明的最大上下文长度也不等于训练时就应该使用同样长度。真正的训练长度应由样本分布、显存预算和线上需求共同决定,否则可能为极少数长样本付出大量显存与计算成本。
别把能加载当成能训练
通过规模筛选后,还要确认训练栈是否真正理解这个模型。首先检查当前框架是否支持对应架构和数据类型;随后确认 tokenizer 的特殊 Token 与模型配置一致,避免结束符、填充符或角色边界被错误处理。
对于聊天模型,聊天模板尤其重要。同一组 user、assistant 消息经过不同模板后,会形成不同的特殊 Token 和提示结构。微调时如果使用了与基座训练不一致的模板,模型可能学到多余标记,甚至在推理时无法正确结束回答。纯 Base 模型则可能根本没有可直接沿用的聊天模板,需要由任务数据格式明确规定输入和目标文本。
LoRA 还多一层结构兼容性:需要确认计划注入适配器的模块名称确实存在,并判断只训练注意力投影层是否足够。不要直接照搬另一种架构的 q_proj、v_proj 等目标模块名称;模块命名和组织方式取决于具体模型实现。
把许可证拆成三个边界
许可证检查不能只看模型页面上的一个标签。真正需要确认的是具体模型版本随附的许可文本、NOTICE、使用政策以及它们对当前交付方式的约束。不同版本甚至不同发布仓库可能存在差异,因此记录精确来源和版本比只记模型名称更可靠。
第一层是权重能否按预期使用。需要确认训练、推理、研究、商业服务等计划用途是否被允许,以及是否存在特定用途限制。能够下载权重不代表自动获得任意商业使用或再分发权利。
第二层是衍生成果如何发布。需要查看是否要求保留版权声明、附带许可证或 NOTICE、注明修改、遵守命名规则,或者对再分发方式存在额外条件。发布合并后的模型会包含基座权重,因此尤其要确认基座模型的再分发条款。
第三层是周边资产是否另有许可。训练代码、tokenizer 文件、数据集和评测集可能分别采用不同许可。一个基座模型允许商用,并不能自动推导出训练数据或其他配套资源同样允许商用和再发布。
给每个候选保留决策证据
实际项目中,最容易丢失的不是模型名称,而是“当时为什么认为它可以用”。因此在确定基座前,至少保留下面这些信息:
- 精确的模型标识与版本或 revision,而不是只记录系列名称
- 权重来源以及对应的许可证、NOTICE 和使用政策位置
- 计划采用的 tokenizer、聊天模板与特殊 Token 约定
- 训练精度、量化方式、预计上下文长度和最低硬件需求
- LoRA 目标模块以及是否计划发布 Adapter、合并权重或仅内部部署
- 许可要求中的署名、通知、使用范围和再分发条件,以及核对日期
这份记录的价值在于让技术决策与交付约束绑定在一起。当模型版本升级、仓库条款变化或交付方式从内部使用变成公开发布时,可以立即看出哪些条件必须重新核对,而不用从训练日志中反推当初的选择。
发布 Adapter 也要重新检查边界
LoRA 只保存少量增量参数,因此文件体积远小于完整模型,但不能据此假设 Adapter 天然不受基座条款影响。Adapter 是否可以独立发布、需要附带哪些声明,以及接收者能否与原始基座组合使用,都应依据具体许可证和发布条款判断。
如果最终决定合并 LoRA 与基座权重再发布,交付物已经包含基座参数,更不能跳过再分发条件。若只是内部部署,也应确认当前用途属于许可范围,而不是把“没有公开下载链接”等同于“没有许可问题”。
因此,可靠的基座选择顺序应当是:先用任务和资源约束筛掉技术上不合适的模型,再验证 tokenizer、模板和训练结构,最后用真实的交付方式检查许可证。只有技术条件与许可条件同时通过,模型才算真正进入可训练候选集。