
大模型原理与训练 / 系统课时
排查量化训练质量退化
排查量化训练质量退化
量化训练出现 loss 不降、生成重复、NaN/Inf 或部分层不兼容时,最危险的做法是同时改很多参数。本节用最小复现和 LoRA 对照实验拆分变量,先判断问题来自数据与训练配置,还是 4-bit 量化与计算精度,再按症状逐项修复。
学习目标
- 用最小 A/B 实验区分量化问题与普通训练问题
- 检查计算精度、量化参数、学习率、梯度与 LoRA 目标模块
- 为 loss 异常、重复生成、数值溢出和层不兼容建立稳定排查顺序
先把问题归因到正确层级
先固定同一小批数据、同一随机种子、同一 LoRA 配置和相同训练 step,做两次短跑:一次用 BF16/FP16 基座做普通 LoRA,一次用 4-bit 基座做 QLoRA。如果两边都异常,优先检查数据、标签、学习率和目标模块;只有 QLoRA 异常时,再把重点放到量化配置、计算 dtype 与 4-bit 层兼容性。
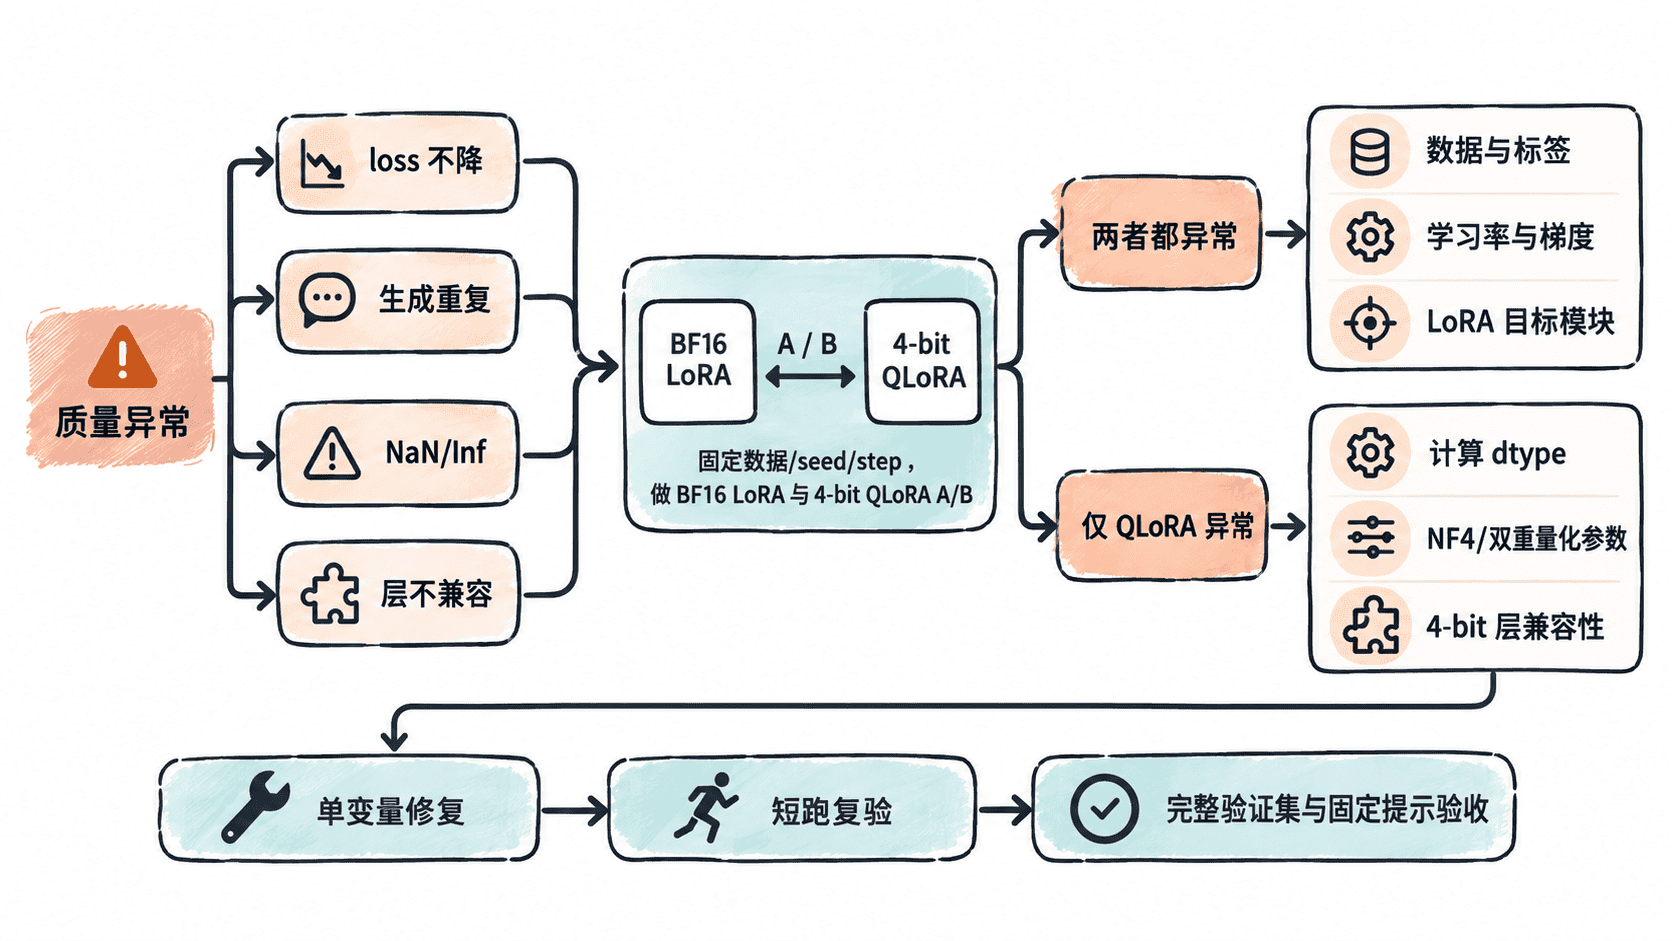
这一步的价值在于缩小搜索空间。没有 A/B 对照时,量化、优化器、标签掩码和数据质量会混在一起,任何“调小学习率就好了”的结论都可能只是偶然。
做一次最小梯度诊断
下面脚本在同一个样本上连续更新 5 次 LoRA 参数,并打印计算 dtype、可训练参数数量、loss、梯度范数和梯度是否有限。它不是正式训练脚本,而是用来确认“量化基座能前向、LoRA 能反向、梯度没有 NaN/Inf”的最小诊断。保存为 diagnose_qlora.py 后直接运行即可。
import math

import torch
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

MODEL_ID = "Qwen/Qwen2.5-0.5B-Instruct"
TARGET_MODULES = [
    "q_proj",
    "k_proj",
    "v_proj",
    "o_proj",
    "gate_proj",
    "up_proj",
    "down_proj",
]

def main():
    if not torch.cuda.is_available():
        raise RuntimeError("该诊断需要支持 bitsandbytes 4-bit 的 CUDA GPU")

    use_bf16 = torch.cuda.is_bf16_supported()
    compute_dtype = torch.bfloat16 if use_bf16 else torch.float16
    quant_config = BitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_use_double_quant=True,
        bnb_4bit_compute_dtype=compute_dtype,
    )

    tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, use_fast=True)
    model = AutoModelForCausalLM.from_pretrained(
        MODEL_ID,
        quantization_config=quant_config,
        device_map={"": 0},
    )
    model = prepare_model_for_kbit_training(model)
    model.config.use_cache = False
    model = get_peft_model(
        model,
        LoraConfig(
            r=16,
            lora_alpha=32,
            lora_dropout=0.0,
            bias="none",
            task_type="CAUSAL_LM",
            target_modules=TARGET_MODULES,
        ),
    )
    model.train()

    prompt = tokenizer.apply_chat_template(
        [{"role": "user", "content": "用一句话解释梯度裁剪的作用。"}],
        tokenize=False,
        add_generation_prompt=True,
    )
    full_text = tokenizer.apply_chat_template(
        [
            {"role": "user", "content": "用一句话解释梯度裁剪的作用。"},
            {"role": "assistant", "content": "梯度裁剪通过限制梯度范数来降低训练数值爆炸的风险。"},
        ],
        tokenize=False,
        add_generation_prompt=False,
    )
    prompt_ids = tokenizer(prompt, add_special_tokens=False)["input_ids"]
    batch = tokenizer(full_text, add_special_tokens=False, return_tensors="pt")
    batch = {k: v.to(model.device) for k, v in batch.items()}
    labels = batch["input_ids"].clone()
    labels[:, : min(len(prompt_ids), labels.shape[1])] = -100
    batch["labels"] = labels

    trainable = [p for p in model.parameters() if p.requires_grad]
    optimizer = torch.optim.AdamW(trainable, lr=2e-4)

    print(f"compute_dtype={compute_dtype}")
    print(f"trainable_params={sum(p.numel() for p in trainable)}")

    for step in range(1, 6):
        optimizer.zero_grad(set_to_none=True)
        loss = model(**batch).loss
        loss.backward()

        grads = [p.grad for p in trainable if p.grad is not None]
        if not grads:
            raise RuntimeError("LoRA 参数没有产生梯度,请检查 target_modules 与标签")
        finite_grads = all(torch.isfinite(g).all().item() for g in grads)
        grad_norm = torch.nn.utils.clip_grad_norm_(trainable, max_norm=0.3)
        print(
            f"step={step} loss={loss.item():.6f} "
            f"grad_norm={float(grad_norm):.6f} finite_grads={finite_grads}"
        )

        if not math.isfinite(loss.item()) or not finite_grads:
            break
        optimizer.step()

if __name__ == "__main__":
    main()
预期输出
compute_dtype=<DTYPE>
trainable_params=<COUNT>
step=1 loss=<LOSS> grad_norm=<NORM> finite_grads=True
step=2 loss=<LOSS> grad_norm=<NORM> finite_grads=True
step=3 loss=<LOSS> grad_norm=<NORM> finite_grads=True
step=4 loss=<LOSS> grad_norm=<NORM> finite_grads=True
step=5 loss=<LOSS> grad_norm=<NORM> finite_grads=True<DTYPE>、<COUNT>、<LOSS> 和 <NORM> 会随硬件与模型变化。关键不是要求 loss 每一步严格单调下降,而是它应保持有限值、梯度持续存在且 finite_grads=True;如果第一步就出现 NaN/Inf,先处理数值路径,不要继续长跑。
按症状定位根因
诊断时把“现象、第一检查点、下一动作”固定下来,比凭经验连续改参数更容易找到真正变量。
| 现象 | 第一检查点 | 下一动作 |
|---|---|---|
| loss 不降 | 标签中是否有非 -100 token、LoRA 是否有梯度、目标模块是否命中 |
固定 step 逐档降低学习率,并与普通 LoRA 短跑对照 |
| 生成重复 | 基线与 QLoRA 是否使用相同解码参数、训练回答是否高度重复 | 排除过拟合后再比较 LoRA 与 QLoRA 的固定提示输出 |
| NaN/Inf | 首批 loss、finite_grads、计算 dtype 与梯度范数 |
降低学习率、保留梯度裁剪,硬件支持时优先验证 BF16 计算 |
| 层不兼容 | 报错模块名是否真的在 target_modules 中、是否属于特殊投影层 |
先移除异常目标层做最小复现,再逐个加回 |
若只有 QLoRA 异常,再核对量化配置本身:确认确实是 load_in_4bit=True,权重量化类型与实验约定一致,例如 NF4;确认 bnb_4bit_compute_dtype 没有意外落到不合适的精度;确认双重量化开关没有在两组实验间悄然变化。不要一次同时改量化类型、dtype 和学习率,否则无法知道是哪项修复了问题。
对于 loss 不降,最先排除“没有监督信号”和“适配器没接上”这两类结构性错误。普通 LoRA 也不下降时,应回到数据、标签和优化超参数;只有 4-bit 版本复现时,才继续检查量化路径。
对于生成重复,先用完全相同的温度、采样、最大生成长度和重复惩罚做对照。训练 loss 正常但输出快速重复时,还要检查小数据过拟合与回答模板单一,不能仅凭生成现象断定量化损伤。
对于 NaN/Inf,首批次就异常通常比“训练到后期才发散”更像数值或输入问题。硬件支持时,BF16 的指数范围更宽,常适合作为 FP16 溢出的对照;如果降低学习率后仍立即溢出,再回查输入、量化计算 dtype 与异常层。
对于层不兼容,不要假设所有架构都使用同一组 q_proj、v_proj 命名。目标模块必须来自当前模型的真实模块树;移除特殊层后能恢复训练时,再逐个加回,且 LoRA 基线必须使用同样的目标集合。
用单变量复验收口
修复后先跑固定的少量 step,不要直接恢复完整训练。验收至少包含:loss 保持有限且有下降趋势、梯度无 NaN/Inf、验证损失没有相对 LoRA 基线异常恶化、固定提示不再出现重复或格式崩坏,并记录峰值显存确认修复没有意外关闭 4-bit 路径。
每次只改一个变量,并把“现象、修改项、短跑结果、是否通过”写进实验记录。这样最终才能回答退化究竟来自量化本身、计算精度、优化超参数还是目标模块,而不是得到一组无法复现的参数组合。