
大模型原理与训练 / 系统课时
跟踪损失与过拟合信号
跟踪损失与过拟合信号
训练日志里单看 train loss 很容易误判。本篇把 train loss、eval loss、梯度范数和检查点差异放在同一条时间线上,给出一套可执行的判断规则,帮助你区分欠拟合、过拟合与训练不稳定,并据此决定继续训练、回退检查点还是调整超参数。
学习目标
- 联合解释 train loss、eval loss、梯度范数和检查点差异,而不是只盯单一指标。
- 用趋势而非单点识别欠拟合、过拟合和训练不稳定。
- 根据评测信号选择继续训练、回退检查点或调整超参数。
先把四条信号放到同一时间轴
train loss 表示模型对训练数据的拟合程度,eval loss 表示这种拟合能否迁移到未参与更新的数据。两者都下降通常是正常学习;train loss 持续下降而 eval loss 连续上升,则说明模型开始记忆训练集细节,典型地进入过拟合区间。
梯度范数用于判断更新是否稳定。偶发抬升不等于故障,但若梯度范数突然比常态高出数倍、出现 NaN 或同时伴随 loss 剧烈震荡,就应优先排查学习率、数值精度、异常样本和梯度裁剪。检查点差异则回答另一个问题:哪个训练时刻真正最好,而不是哪个检查点最新。
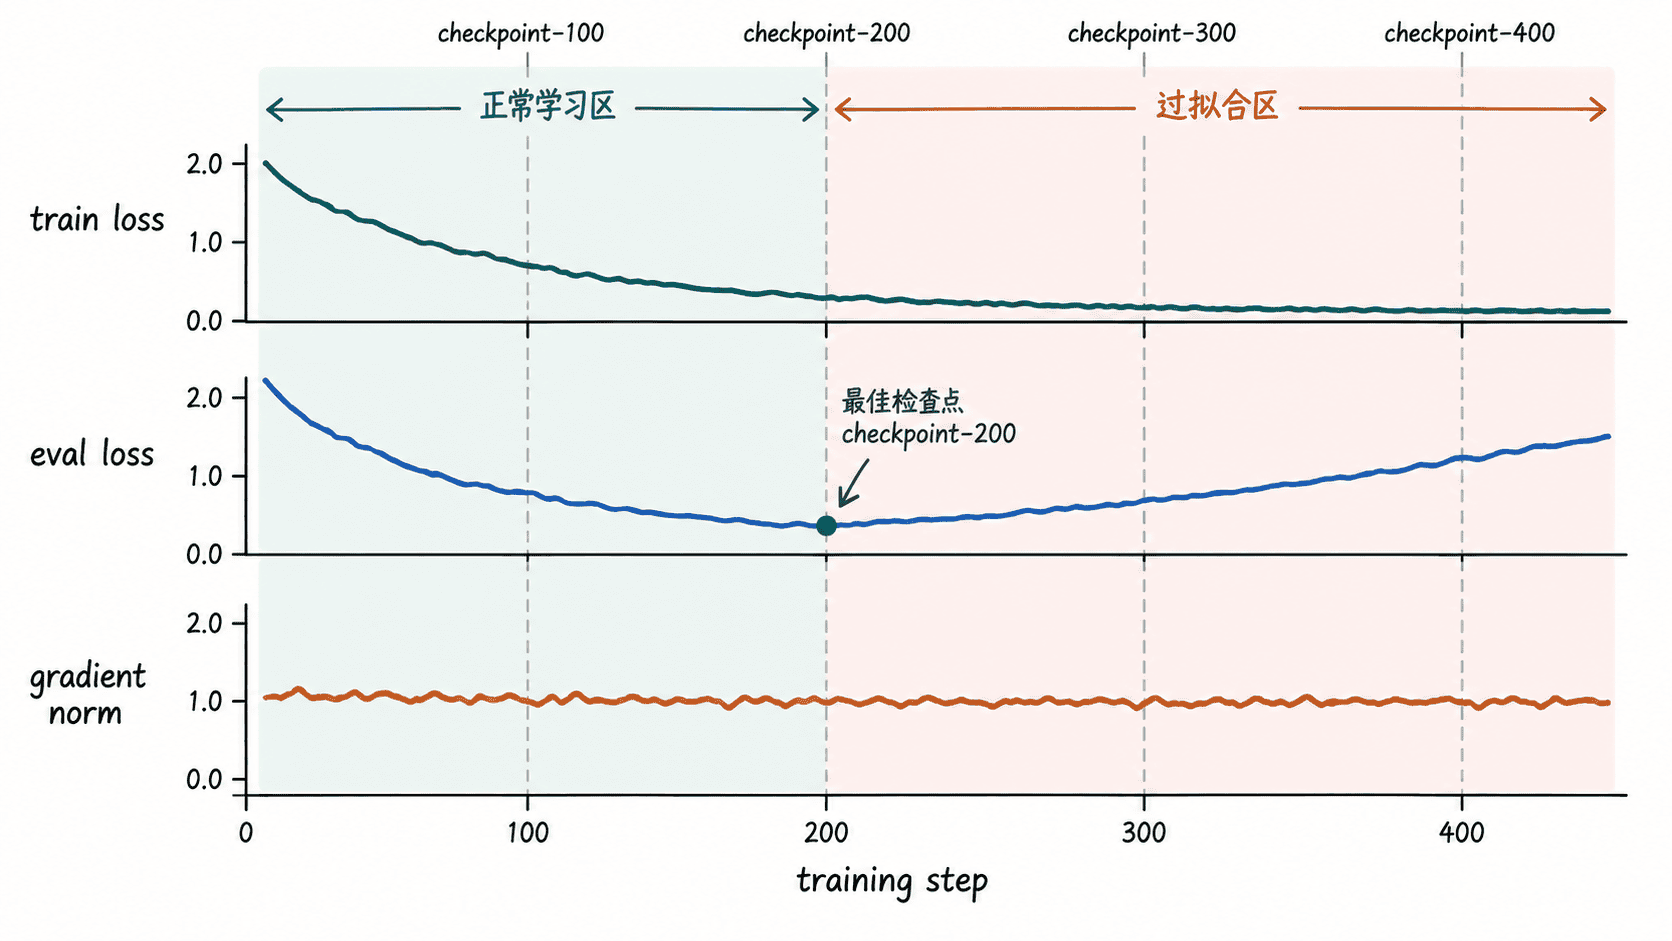
常见状态可以先用下面的组合关系快速判断:
| 现象 | 更可能的状态 | 优先动作 |
|---|---|---|
| train loss 与 eval loss 都高且下降缓慢 | 欠拟合 | 增加有效训练、检查数据与容量或调大学习率 |
| train loss 下降,eval loss 连续上升 | 过拟合 | 回退到最佳检查点,减少训练轮次或加强正则 |
| loss 剧烈震荡,梯度范数异常放大或非有限 | 训练不稳定 | 降低学习率,检查精度设置与异常批次 |
| eval loss 仍下降且梯度稳定 | 仍在有效学习 | 可以继续训练并保持评测频率 |
用最小脚本识别趋势
下面的脚本用四个检查点模拟一次训练记录。判断逻辑故意保持简单:先检查数值稳定性,再看最近三个点中 train loss 是否持续下降、eval loss 是否持续上升,同时输出最佳检查点和最新检查点相对最佳点的泛化差距。
import math

history = [
    {"step": 100, "train_loss": 1.42, "eval_loss": 1.51, "grad_norm": 0.82},
    {"step": 200, "train_loss": 1.05, "eval_loss": 1.20, "grad_norm": 0.91},
    {"step": 300, "train_loss": 0.78, "eval_loss": 1.21, "grad_norm": 1.03},
    {"step": 400, "train_loss": 0.61, "eval_loss": 1.38, "grad_norm": 1.15},
]

def strictly_decreasing(values):
    return all(left > right for left, right in zip(values, values[1:]))

def strictly_increasing(values):
    return all(left < right for left, right in zip(values, values[1:]))

recent = history[-3:]
unstable = any(
    not math.isfinite(row["train_loss"])
    or not math.isfinite(row["eval_loss"])
    or not math.isfinite(row["grad_norm"])
    or row["grad_norm"] > 5.0
    for row in history
)

if unstable:
    state = "unstable"
elif strictly_decreasing([x["train_loss"] for x in recent]) and strictly_increasing(
    [x["eval_loss"] for x in recent]
):
    state = "overfitting"
else:
    state = "healthy_or_underfitting"

best = min(history, key=lambda x: x["eval_loss"])
latest = history[-1]
gap = latest["eval_loss"] - latest["train_loss"]
checkpoint_delta = latest["eval_loss"] - history[-2]["eval_loss"]

print(f"state={state}")
print(f"best_checkpoint=step-{best['step']}")
print(f"latest_eval_gap={gap:.3f}")
print(f"checkpoint_eval_delta={checkpoint_delta:+.3f}")
预期输出
state=overfitting
best_checkpoint=step-200
latest_eval_gap=0.770
checkpoint_eval_delta=+0.170
这里的阈值不是通用标准。真实训练应使用滑动窗口、多个 eval 点和任务指标共同判断,梯度范数也要和本模型的历史基线比较,而不是机械地把 5.0 当成所有模型的告警线。
从信号直接映射到训练动作
当 eval loss 仍稳定下降、任务指标同步改善且梯度范数处于正常区间时,继续训练通常是合理的。此时要保持固定评测间隔,否则不同检查点之间无法公平比较。
当 train loss 下降而 eval loss 已连续多个评测点恶化,应优先回退到历史最佳检查点,而不是继续等待最新检查点“追回来”。随后再考虑减少 epoch、增加权重衰减、提高 dropout、扩充数据或降低可训练参数规模。
当梯度范数和 loss 同时出现尖峰,先处理稳定性问题,再讨论过拟合。可优先降低学习率、启用或收紧梯度裁剪,并定位是否存在超长样本、异常标签或混合精度溢出。若恢复稳定后 eval loss 仍恶化,再回到过拟合路径。
最终选择最佳模型时,不要把“最后一个检查点”当成默认答案。应以独立评测集上的目标指标为主,结合 eval loss、稳定性和检查点间差异确认最佳点;这套证据链比任何单一 loss 数值都更可靠。