
大模型原理与训练 / 系统课时
配置 FSDP 参数分片训练
配置 FSDP 参数分片训练
FSDP 的关键不是把 DDP 换成一个包装器,而是决定“按什么边界聚合参数、哪些状态要分片、检查点怎样落盘”。本节用两张 GPU 跑一个最小 Transformer,配置 wrapping、FULL_SHARD 与完整 state dict,并用峰值显存观察分片训练是否真正生效。
学习目标
- 能按 Transformer block 选择 FSDP wrapping 边界,避免包得过粗或过细。
- 能解释
FULL_SHARD相比 DDP 对参数、梯度和优化器状态的显存与通信影响。 - 能保存可直接加载的完整 state dict,并知道何时应改用分片检查点。
先确定分片边界
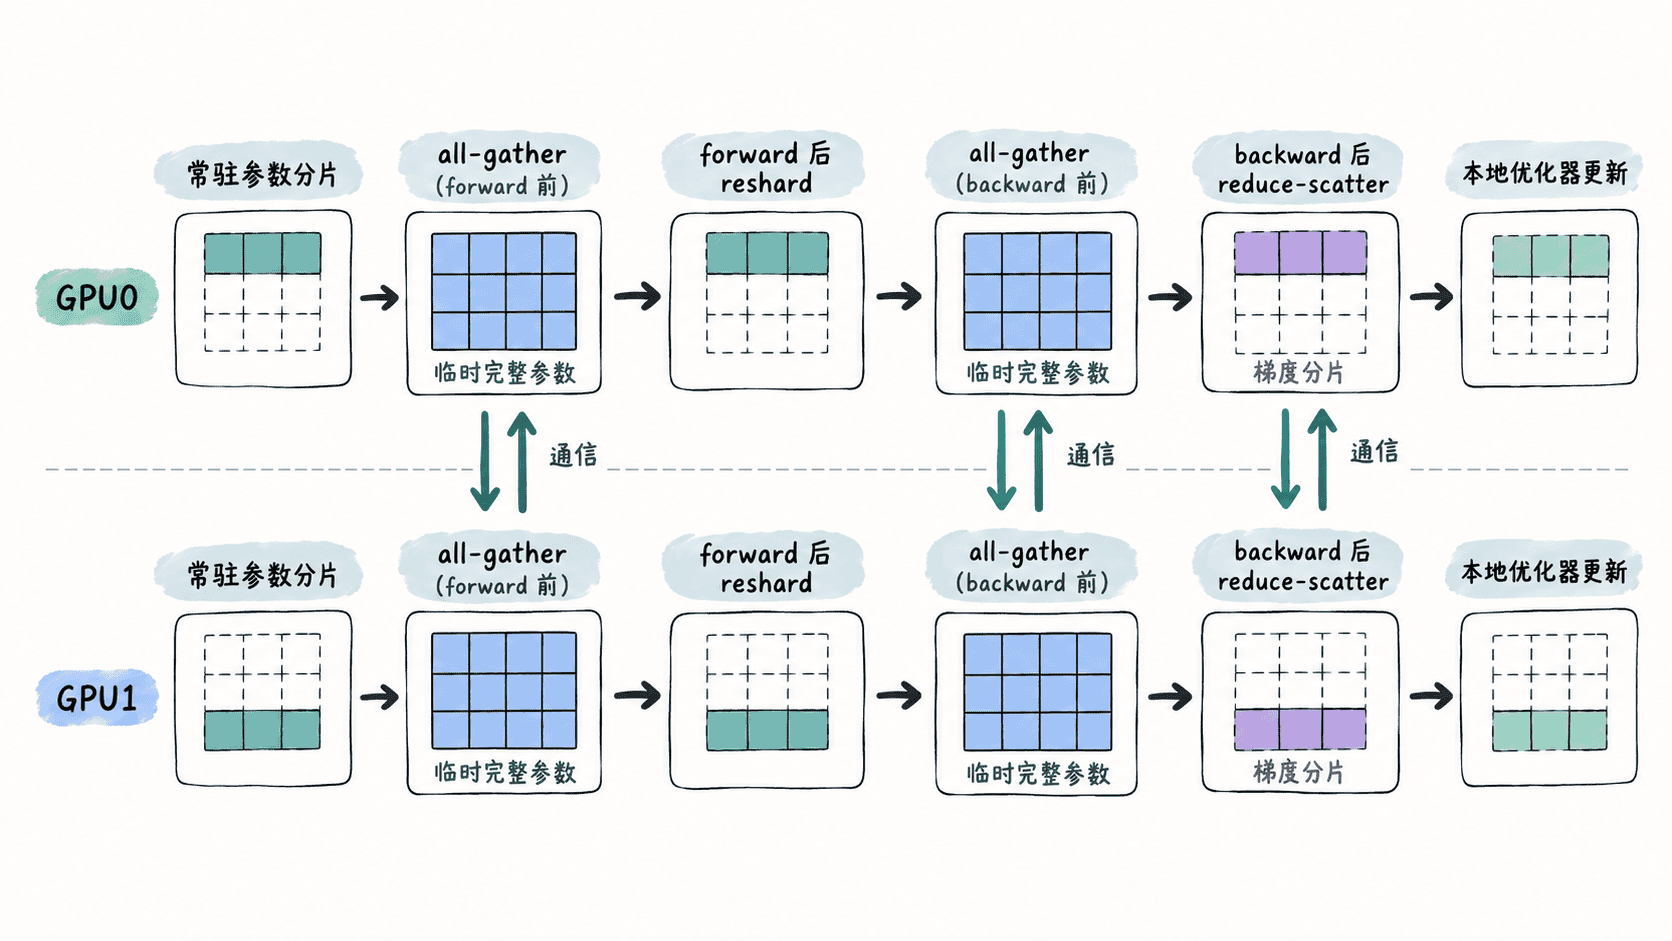
DDP 会在每个 rank 上保留完整模型副本,主要在反向阶段同步梯度;FSDP 则让各 rank 常驻参数分片,在某个 FSDP 单元计算前用 all-gather 临时恢复完整参数,计算后再释放非本地分片,并在反向阶段用 reduce-scatter 同步并重新分片梯度。这样显存下降,但通信次数和参数重建成本会上升。
对 Transformer,常见做法是“一个 block 一个 FSDP 单元”。如果整个模型只包成一个单元,单次 all-gather 可能临时物化太多参数;如果把每个很小的线性层都独立包装,又会制造大量小通信。共享参数还应保持在兼容的包装边界内。
配置 wrapping 与 FULL_SHARD
下面的完整示例要求至少两张 CUDA GPU,并通过 torchrun 建立 NCCL 进程组。transformer_auto_wrap_policy 让每个 TransformerEncoderLayer 成为独立 FSDP 单元,FULL_SHARD 同时分片参数、梯度与优化器状态。
import functools
import os

import torch
import torch.distributed as dist
import torch.nn as nn
from torch.distributed.fsdp import (
    FullStateDictConfig,
    FullyShardedDataParallel as FSDP,
    ShardingStrategy,
    StateDictType,
)
from torch.distributed.fsdp.wrap import transformer_auto_wrap_policy


def main():
    dist.init_process_group("nccl")
    local_rank = int(os.environ["LOCAL_RANK"])
    rank = dist.get_rank()
    device = torch.device("cuda", local_rank)
    torch.cuda.set_device(device)
    torch.manual_seed(7)

    layer = nn.TransformerEncoderLayer(
        d_model=512,
        nhead=8,
        dim_feedforward=2048,
        batch_first=True,
    )
    model = nn.TransformerEncoder(layer, num_layers=4)

    wrap_policy = functools.partial(
        transformer_auto_wrap_policy,
        transformer_layer_cls={nn.TransformerEncoderLayer},
    )
    model = FSDP(
        model,
        auto_wrap_policy=wrap_policy,
        sharding_strategy=ShardingStrategy.FULL_SHARD,
        device_id=device,
        limit_all_gathers=True,
    )
    optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)

    # 固定输入规模,便于和 DDP 基线比较峰值显存与单步耗时。
    torch.cuda.reset_peak_memory_stats(device)
    x = torch.randn(2, 128, 512, device=device)
    loss = model(x).square().mean()
    loss.backward()
    optimizer.step()
    optimizer.zero_grad(set_to_none=True)

    peak_mb = torch.cuda.max_memory_allocated(device) / 1024**2
    print(f"rank={rank} peak_cuda_mb={peak_mb:.1f}")

    # 保存时在 CPU 聚合完整权重,并且只让 rank 0 持有最终 state dict。
    save_cfg = FullStateDictConfig(offload_to_cpu=True, rank0_only=True)
    with FSDP.state_dict_type(
        model, StateDictType.FULL_STATE_DICT, save_cfg
    ):
        state = model.state_dict()

    if rank == 0:
        torch.save(state, "fsdp-full.pt")
        print("checkpoint=fsdp-full.pt")

    dist.barrier()
    dist.destroy_process_group()


if __name__ == "__main__":
    main()
预期输出(由下方 torchrun 启动后;显存值和各 rank 输出顺序会因 GPU 与运行环境不同):
rank=0 peak_cuda_mb=<MEMORY_MB>
rank=1 peak_cuda_mb=<MEMORY_MB>
checkpoint=fsdp-full.pt
启动两个进程:
torchrun --standalone --nproc-per-node=2 fsdp_demo.py预期输出:
rank=<RANK> peak_cuda_mb=<MEMORY_MB>
checkpoint=fsdp-full.pt
其中 <RANK>、<MEMORY_MB> 为动态值;两条 rank 日志的先后顺序不固定。
选择 sharding 策略时看什么
FULL_SHARD 追求较低的常驻 GPU 状态,适合参数与优化器状态已经成为主要瓶颈的大模型;代价是按包装单元执行参数聚合与梯度分散。SHARD_GRAD_OP 减少一部分参数重分片动作,可能获得更高吞吐,但运行期间会保留更多已聚合参数,峰值显存通常更高。
调优时不要只看 nvidia-smi 的某个瞬时值。应在相同 batch size、序列长度和精度下记录 torch.cuda.max_memory_allocated() 与 step time,并通过 profiler 检查 all-gather、reduce-scatter 的耗时占比。wrapping 过粗时常见现象是峰值显存仍高;过细时则可能显存下降但 collective 数量增加、step time 变长。
选择 state dict 保存方式
示例使用 FULL_STATE_DICT,并把权重卸载到 CPU、只让 rank 0 保存,优点是产物就是普通 PyTorch state dict,便于推理、发布或脱离 FSDP 加载。缺点是保存时必须把分片重新聚合成完整权重,大模型会增加保存延迟和主机内存压力。
长期训练更适合分片检查点:各 rank 保留分布式 shard,恢复时无需每次先聚合完整模型。验收时至少确认三件事:两张 GPU 的峰值显存都低于同配置 DDP 基线、step time 没有因过细 wrapping 明显恶化、生成的 fsdp-full.pt 能在 CPU 上被 torch.load() 正常读取。