
大模型原理与训练 / 系统课时
读懂数据并行与参数分片
读懂数据并行与参数分片
多卡训练最容易混淆的不是“有几张 GPU”,而是每张卡到底保存哪些训练状态、何时需要跨卡通信。本篇用 DDP、FSDP 和 ZeRO 对照参数、梯度与优化器状态,建立“省显存靠分片,分片越深越依赖通信”的判断框架。
学习目标
- 说清 DDP、FSDP 与 ZeRO 分别复制或分片哪些训练状态
- 根据显存瓶颈判断需要复制模型还是进一步做状态分片
- 理解更深分片为什么会增加参数聚合、梯度归约等通信成本
先拆开训练时真正占显存的状态
一次全参数训练至少要同时考虑四类占用:模型参数、梯度、优化器状态和激活值。DDP、FSDP 与 ZeRO 主要改变前三类状态在各个 rank 上的保存方式;激活值是否节省,通常还要靠减小 micro batch、梯度检查点或序列并行等手段。
DDP 的核心是每个进程各放一份完整模型,不同 rank 读取不同的数据分片。反向传播后,各 rank 通过梯度归约得到一致梯度,再各自在本地执行相同的优化器更新。因此,增加 GPU 能摊薄计算和样本,但不会把完整参数与优化器状态自动切成更小的份额。([PyTorch Documentation][1])
FSDP 把完整状态拆成按需聚合的分片
FSDP 的 FULL_SHARD 会把参数、梯度和优化器状态都分散到不同 rank。某个 FSDP 单元进入前向或反向计算前,通过 all-gather 暂时恢复该单元所需的完整参数;梯度计算完成后,再通过 reduce-scatter 同步并保留本 rank 对应的梯度分片。这样能显著降低长期驻留的模型状态显存,但会引入更多集合通信和临时聚合峰值。([PyTorch Documentation][2])
这也解释了为什么 FSDP 不能只看“理论上除以 GPU 数”的平均显存。实际峰值还受 FSDP 包裹粒度、当前正在 all-gather 的参数块、激活值、通信缓冲区以及优化器实现影响。包裹过大时,单次聚合的参数太多;包裹过碎时,又可能让通信调用变得频繁。
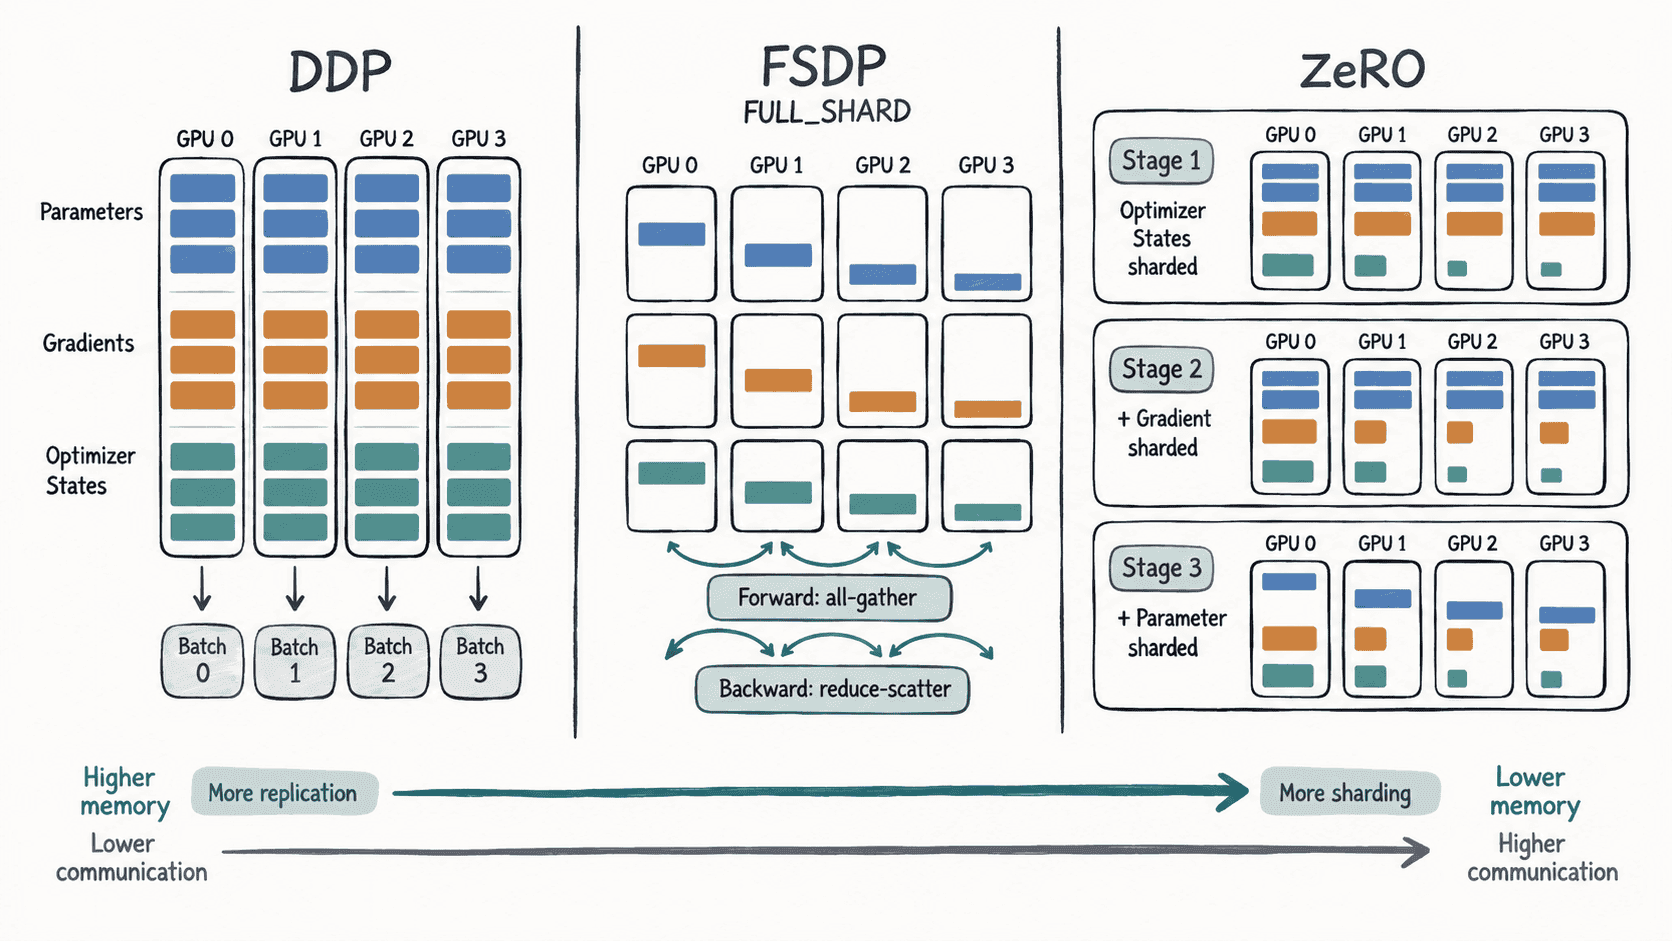
ZeRO 用阶段表达“分到什么程度”
ZeRO 更像一组逐级加深的状态分片策略。Stage 1 只分片优化器状态;Stage 2 再分片梯度;Stage 3 进一步分片参数。DeepSpeed 的官方配置也按这三个层级定义 ZeRO。([DeepSpeed][3])
| 方案 | 参数 | 梯度 | 优化器状态 | 主要特点 |
|---|---|---|---|---|
| DDP | 每卡完整复制 | 每卡保留并同步 | 每卡完整复制 | 简单直接,但状态显存基本不随卡数下降 |
| ZeRO Stage 1 | 完整复制 | 完整保留 | 分片 | 先解决优化器状态占用 |
| ZeRO Stage 2 | 完整复制 | 分片 | 分片 | 继续减少梯度常驻显存 |
| ZeRO Stage 3 | 分片 | 分片 | 分片 | 省显存最彻底,参数需要按需聚合 |
| FSDP FULL_SHARD | 分片 | 分片 | 分片 | 在 PyTorch FSDP 体系内实现完整状态分片 |
从显存维度看,FSDP FULL_SHARD 与 ZeRO Stage 3 很接近,但它们不是两个可以简单互换名字的开关:FSDP 是 PyTorch 的并行封装体系,ZeRO 常通过 DeepSpeed 使用,配置入口、状态保存方式和工程集成都不同。
选择方案时先判断真正的瓶颈
如果完整模型、梯度和优化器状态都能轻松放进单卡,DDP 往往是更直接的起点,因为模型复制换来了较简单的执行路径。只有当单卡状态显存成为限制时,FSDP 或 ZeRO 的分片收益才开始明显抵消额外通信成本。
对 LoRA 或 QLoRA 还要多看一步:可训练参数已经很少,优化器状态通常不再是最大头,因此仅做 ZeRO Stage 1 的收益可能有限。此时更应检查基座模型权重、激活值和临时缓冲区各占多少,再决定是否需要参数分片、梯度检查点或更小的 micro batch。
判断多卡策略时,不要只问“哪一种最省显存”,而应问“当前最大的常驻状态是什么、跨卡链路有多快、为了省这部分显存愿意增加多少通信”。这三个问题能把 DDP、FSDP 和 ZeRO 从名词比较变成可操作的工程选择。