
大模型原理与训练 / 系统课时
判断何时值得全参数训练
判断何时值得全参数训练
全参数微调的关键不是“效果是否可能更高”,而是新增收益能否覆盖数据、显存、训练稳定性和运维成本。本篇给出一套可执行的升级判断方法:先确认 LoRA 的上限,再用受控对照实验验证全参数训练是否真的值得。
学习目标
- 根据任务偏移、数据规模和质量目标判断是否需要更新全部权重
- 用同预算对照实验区分“LoRA 配置问题”和“参数容量不足”
- 识别全参数训练带来的显存、检查点、恢复和回归验证成本
先判断瓶颈是不是参数容量
LoRA 只训练低秩增量,适合把已有能力定向到新格式、新风格或相对接近的任务。全参数训练则允许模型内部表示整体移动,理论上上限更高,但前提是数据足以约束这么多自由度。
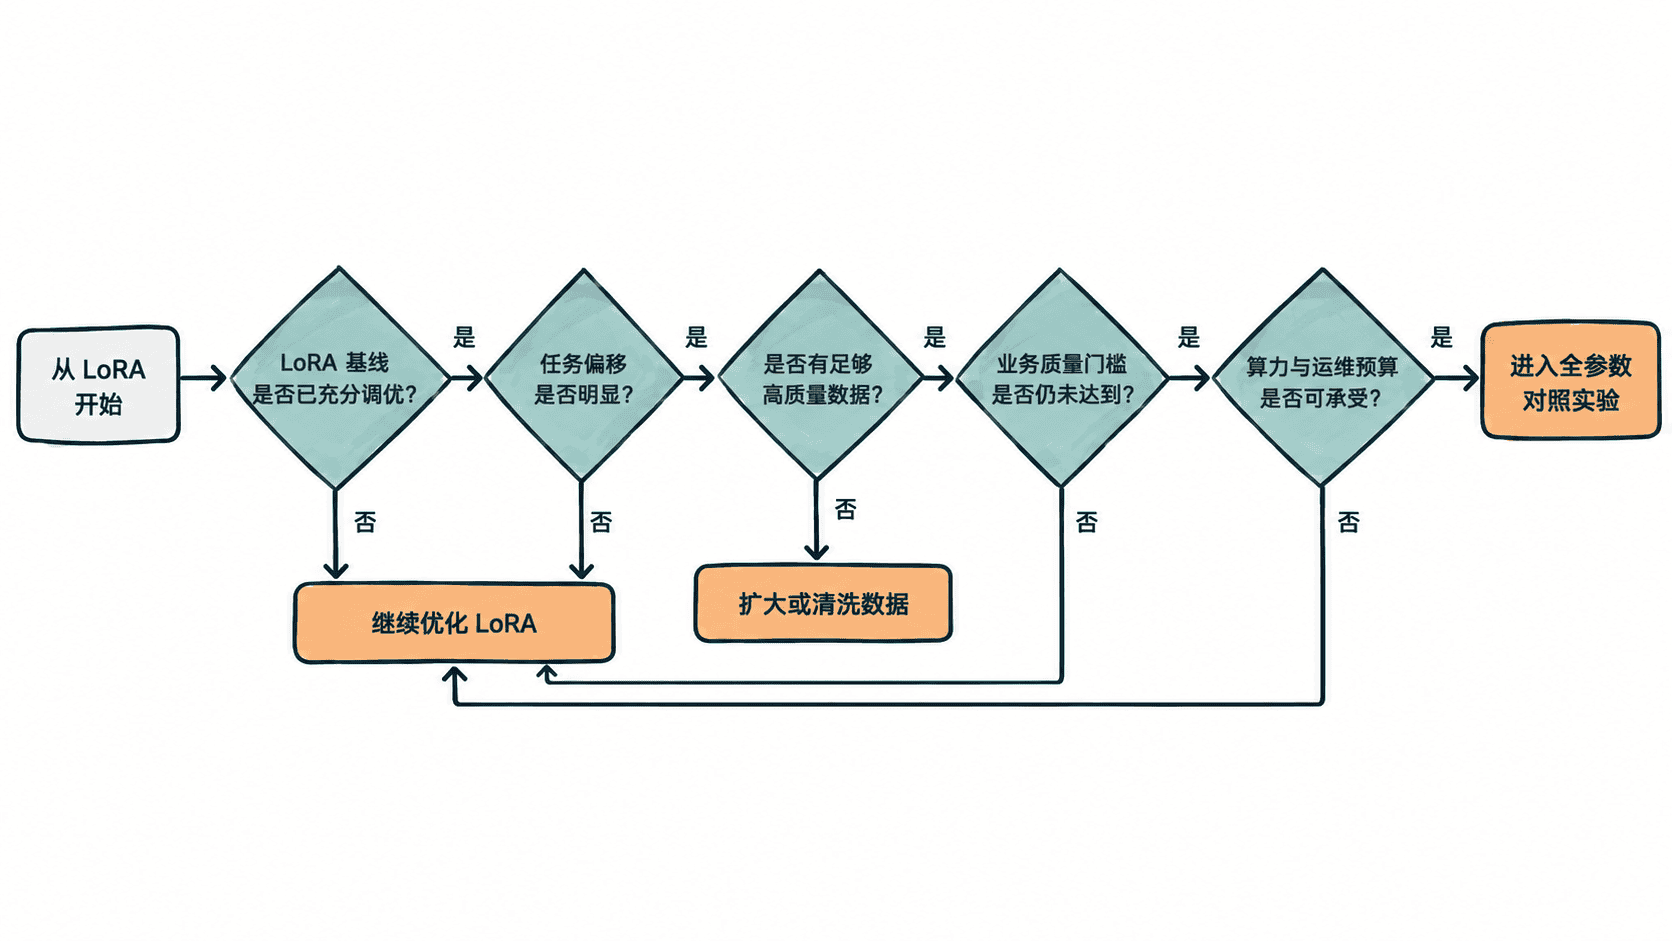
如果 LoRA 还没有做过合理的秩、学习率、目标模块和训练步数搜索,就直接切全参,往往会把“适配器没调好”误判为“LoRA 能力不够”。先把一个稳定的 LoRA 基线跑到收敛,再讨论升级。
用四个条件决定是否升级
最值得关注的是四类信号:任务与基座能力的偏移程度、有效训练数据规模、质量目标与当前差距、以及可用算力和运维能力。它们共同决定全参训练是否有真实收益空间。
| 判断信号 | 更偏向 LoRA | 更偏向全参数训练 |
|---|---|---|
| 任务偏移 | 输出格式、语气、领域术语适配 | 需要明显重塑推理模式或内部表示 |
| 数据规模 | 数据少且分布窄 | 数据量大、覆盖面广且质量稳定 |
| 质量差距 | LoRA 已满足验收线 | LoRA 多轮调优后仍稳定低于目标 |
| 资源条件 | GPU 紧张、需频繁迭代多个版本 | 能承担优化器状态、检查点和长时间训练 |
其中“数据量大”没有统一样本数阈值。更重要的是去重、覆盖、难例比例和标签一致性:低质量数据在全参训练中会更广泛地改写模型能力,风险也更高。
用同预算实验验证真实收益
不要把一次全参训练和一次随手配置的 LoRA 结果直接比较。更可靠的做法是固定训练集、验证集、最大序列长度、训练 token 预算和评测脚本,只改变“哪些参数可训练”,再比较任务指标、通用能力回归和训练成本。
先为业务定义一个最小有意义提升,例如某个核心指标必须提升到预先约定的门槛,同时通用评测不得出现不可接受的回退。只有全参方案稳定跨过这个门槛,额外成本才有依据;否则应优先保留 LoRA。
把隐藏运维成本算进去
全参训练会更新全部权重,优化器状态、梯度和主权重可能让训练显存远高于纯推理占用;分布式切分、检查点保存与恢复也更复杂。模型越大,失败重跑和版本存储的成本越不能忽略。
还要把“能力回归”当成正式成本。全参训练更容易改变原有通用能力,因此除了目标任务,还应增加安全、格式遵循、长文本、工具调用或其他关键能力的回归集。若团队没有稳定的评测与恢复链路,全参训练带来的风险通常高于它的潜在收益。
哪些情况优先保留 LoRA
数据较少、任务只是风格或格式迁移、需要为多个客户维护独立版本、GPU 预算有限,或模型必须频繁回滚时,LoRA 通常更合适。它的参数隔离也更利于快速试验和版本管理。
全参数训练更像一次“模型能力重塑”,而不是更昂贵的默认选项。只有在 LoRA 已被充分验证仍有明确质量缺口、数据足以支撑更大自由度,并且训练与回归成本都可控时,才值得进入全参数训练。