
大模型原理与训练 / 系统课时
选择优化器与学习率计划
选择优化器与学习率计划
全参数微调里,优化器和学习率计划直接决定参数更新幅度:步子过大会震荡或快速遗忘,过小又可能几乎学不动。本节配置 AdamW、warmup、峰值学习率、权重衰减与余弦衰减,并用最小训练循环验证实际学习率轨迹。
学习目标
- 正确设置 AdamW 的学习率、权重衰减以及不参与衰减的参数
- 解释 warmup、峰值学习率和衰减阶段分别解决什么问题
- 根据模型规模、数据量和训练症状调整学习率计划
AdamW 里真正要配置的东西
AdamW 把权重衰减从梯度更新中解耦,适合 Transformer 全参数训练。最关键的旋钮是峰值学习率和 weight_decay;beta1、beta2、eps 通常先保持框架默认值,除非已有明确实验依据。
偏置和 LayerNorm 一类一维参数通常不做权重衰减,因此可以按参数维度或名称分组。这样能避免把所有参数机械地套上同一个正则项。
把 warmup 和衰减连成一条计划
一个稳妥的起点是:训练开始从接近 0 的学习率升到峰值,随后再逐步衰减。Warmup 给刚开始训练的优化器一个缓冲区,峰值决定最大更新幅度,后半程衰减则让参数在接近收敛时减少抖动。
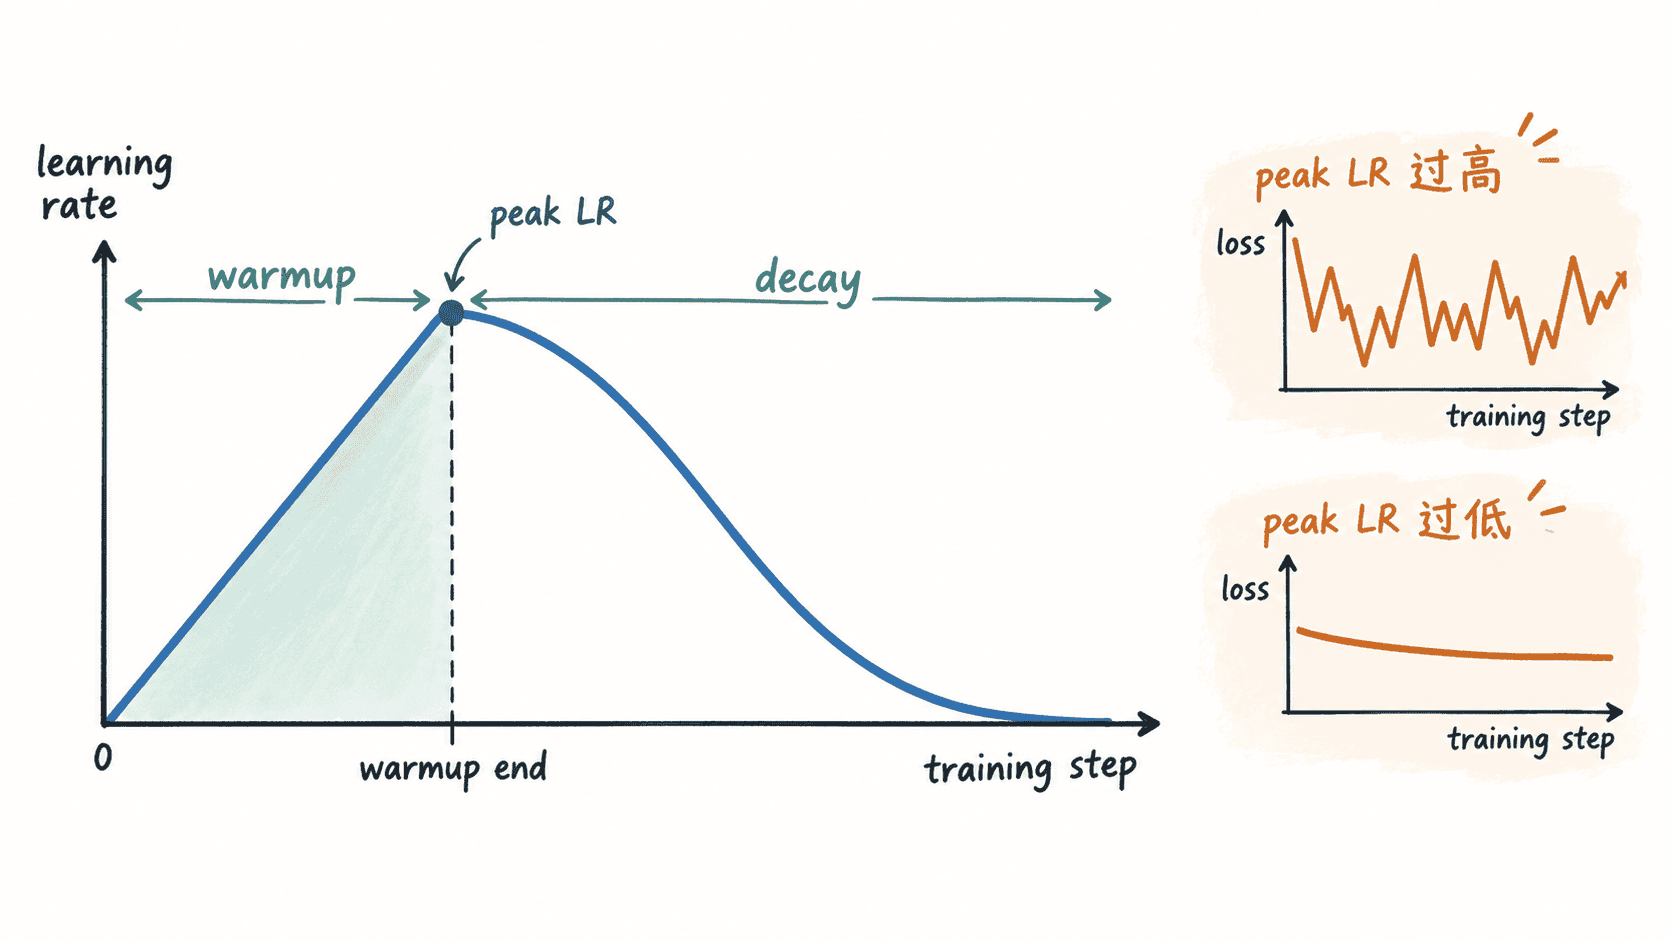
Warmup 不应按固定步数盲配。更稳妥的是按总优化步数设置比例:数据少、总步数短时尤其要避免 warmup 占比过大,否则模型大量时间都没到有效学习率。
用最小训练循环验证调度器
下面示例把一维参数与偏置排除在权重衰减之外。为了在 40 个优化步里清楚看到阶段变化,示例使用 10% warmup 和较高峰值学习率;它只验证优化器与调度器行为,不作为大模型推荐参数。
import math

import torch
from torch import nn
from torch.optim import AdamW
from torch.optim.lr_scheduler import LambdaLR

torch.manual_seed(7)

model = nn.Sequential(
    nn.Linear(16, 32),
    nn.LayerNorm(32),
    nn.GELU(),
    nn.Linear(32, 1),
)

decay_params = []
no_decay_params = []

for name, param in model.named_parameters():
    # bias 和一维参数通常对应偏置或归一化缩放,不施加权重衰减。
    if name.endswith(".bias") or param.ndim == 1:
        no_decay_params.append(param)
    else:
        decay_params.append(param)

peak_lr = 2e-3
total_steps = 40
warmup_steps = 4

optimizer = AdamW(
    [
        {"params": decay_params, "weight_decay": 0.1},
        {"params": no_decay_params, "weight_decay": 0.0},
    ],
    lr=peak_lr,
)

def lr_lambda(step: int) -> float:
    # 前 10% 线性 warmup,之后按半个余弦周期衰减到 0。
    if step < warmup_steps:
        return step / max(1, warmup_steps)

    progress = (step - warmup_steps) / max(1, total_steps - warmup_steps)
    return 0.5 * (1.0 + math.cos(math.pi * progress))

scheduler = LambdaLR(optimizer, lr_lambda)

for step in range(1, total_steps + 1):
    x = torch.randn(8, 16)
    target = x.sum(dim=1, keepdim=True)

    prediction = model(x)
    loss = nn.functional.mse_loss(prediction, target)

    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()
    scheduler.step()

    if step in {1, 4, 22, 40}:
        print(f"step={step:02d} lr={scheduler.get_last_lr()[0]:.6f}")
预期输出:
step=01 lr=0.000500
step=04 lr=0.002000
step=22 lr=0.001000
step=40 lr=0.000000
这里的 2e-3 只是为了让极小模型的曲线更容易观察,不能作为大模型全参数微调的推荐值。真实训练应把同样的计划迁移到更低的峰值学习率上。
从保守区间开始调参
对大模型全参数微调,可以先把峰值学习率搜索在约 1e-6 到 5e-5 的保守范围内,再根据训练规模缩窄。模型越大、可训练数据越少、越担心遗忘,通常越应靠近低端;数据更多、训练更充分时才逐步上探。
Warmup 可先从总优化步数的约 1%~5% 试起;如果训练刚开始明显不稳,再增加到更高比例,而不是先无限降低峰值。weight_decay 常从 0.01~0.1 试验,并继续排除 bias 和归一化参数。以上都是起始搜索区间,不是跨模型通用常数。
判断总优化步数时要看优化器实际更新次数,而不是样本条数。使用梯度累积后,只有累计完成并执行一次 optimizer.step() 才算一个调度步;如果把 micro-batch 次数误当优化步,warmup 和衰减都会过早结束。
用训练症状反推参数
| 训练现象 | 优先检查与调整 |
|---|---|
| loss 很快爆高、频繁尖峰 | 先降低峰值学习率,再检查梯度裁剪和数据异常 |
| 前几百步明显不稳,之后才正常 | 适当增加 warmup 比例,确认调度器按优化步推进 |
| loss 平滑但长期几乎不降 | 在确认数据和梯度正常后,小幅提高峰值学习率 |
| 训练集快速改善,通用能力明显退化 | 降低峰值学习率、减少训练步数,并重新检查数据配比 |
| 后期仍持续大幅震荡 | 使用更平滑的衰减,或把末期学习率降得更低 |
调参时一次只改变一个主变量,并同时记录训练 loss、验证指标、学习率和梯度范数。这样才能区分“优化器参数不合适”与“数据、批大小或训练步数本身有问题”,避免把所有异常都归咎于学习率。