
大模型原理与训练 / 系统课时
切分数据并防止评测泄漏
切分数据并防止评测泄漏
微调数据一旦在训练集和评测集之间泄漏,模型会因为“见过题目”而获得虚假的高分。本篇用实体分组、跨集合近重复检查和污染清理,建立一套可复现的数据切分流程,让验证集与测试集真正衡量泛化能力。
学习目标
- 能按用户、文档或任务实体切分训练、验证和测试集
- 能识别近重复、模板复用和答案污染造成的评测泄漏
- 能在训练前完成跨集合检查并修复泄漏样本
为什么不能直接随机切分
随机按“样本行”切分最危险的地方,是同一来源的高度相关样本可能被拆到不同集合。例如同一用户的多轮问答、同一文档切出的多个片段、同一道题的不同改写,彼此并不独立。模型训练时看到其中一部分,测试时再遇到另一部分,分数会明显偏高。
更稳妥的原则是先确定不可跨集合的实体边界。对话数据常按 user_id 或 conversation_id 分组,文档问答常按 document_id 分组,代码修复或工单数据则按仓库、问题单或任务实体分组。切分的单位应是整个组,而不是组内单条样本。
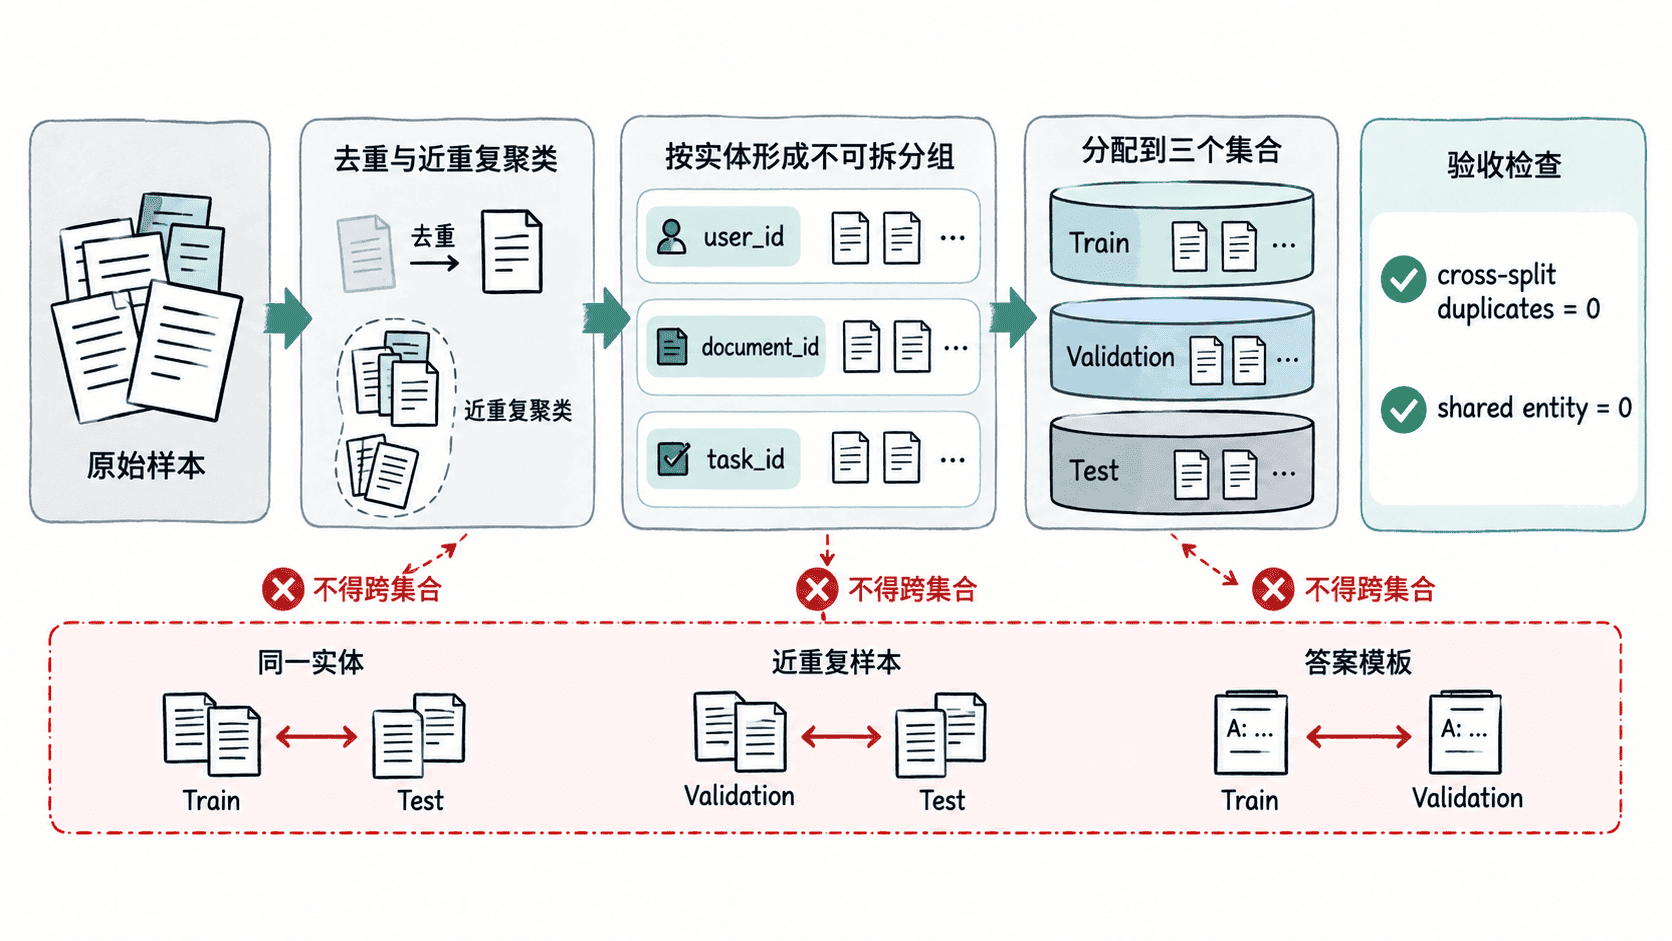
按实体切分并检查近重复
下面的完整 Python 示例故意放入一对跨集合重复问题,用它验证“按用户分组还不够,还要做跨集合内容检查”。示例只使用标准库,结果固定,便于把同样逻辑迁移到真实数据管道。
import re
from difflib import SequenceMatcher

records = [
    {"id": "a1", "user_id": "u1", "text": "解释 Python 列表推导式"},
    {"id": "b1", "user_id": "u2", "text": "什么是 LoRA?"},
    {"id": "c1", "user_id": "u3", "text": "解释 QLoRA"},
    {"id": "d1", "user_id": "u4", "text": "什么是 LoRA?"},
    {"id": "e1", "user_id": "u5", "text": "用两句话解释梯度累积"},
]

# 真实项目应先固定分组清单,再把整个实体组分配到单一集合。
split_by_user = {
    "u1": "train",
    "u2": "train",
    "u3": "validation",
    "u4": "test",
    "u5": "test",
}

def normalize(text: str) -> str:
    return re.sub(r"[\W_]+", "", text.lower())

for row in records:
    row["split"] = split_by_user[row["user_id"]]

counts = {}
for row in records:
    counts[row["split"]] = counts.get(row["split"], 0) + 1

leaks = []
for i, left in enumerate(records):
    for right in records[i + 1:]:
        if left["split"] == right["split"]:
            continue
        score = SequenceMatcher(
            None, normalize(left["text"]), normalize(right["text"])
        ).ratio()
        if score >= 0.95:
            leaks.append(
                f'{left["id"]}({left["split"]}) <-> '
                f'{right["id"]}({right["split"]}), similarity={score:.2f}'
            )

for name in ("train", "validation", "test"):
    print(f"{name}: {counts.get(name, 0)}")
for leak in leaks:
    print("LEAK:", leak)
预期输出:
train: 2
validation: 1
test: 2
LEAK: b1(train) <-> d1(test), similarity=1.00
这段检查证明实体分组只能阻止“同一用户跨集合”,不能自动发现不同用户提交的重复内容。生产数据应把精确去重、近重复聚类和实体分组组合起来,必要时将近重复簇也视作不可拆分的分组约束。
识别模板泄漏与答案污染
近重复只是最直观的一类泄漏。模板泄漏通常表现为训练集和测试集共享固定题干、固定字段顺序或高度稳定的提示词骨架,模型可能只学会模板映射。检查时应把变量槽位归一化后再比较模板,而不是只比较原始文本。
答案污染更隐蔽:训练样本的输入中直接出现标准答案、评分标签或未来信息,或者检索上下文包含测试集答案。此时即使问题文本完全不同,评测仍然失真。应分别审计模型输入、目标答案和外部上下文,确认评测目标没有提前进入训练可见范围。
修复泄漏并验收切分结果
发现泄漏后,不要只删除测试集中的重复样本,否则会悄悄改变评测分布。更稳妥的做法是回到切分前,为重复簇和业务实体建立统一分组约束,再重新划分三套数据;如果某个实体天然横跨多个任务,应按最严格的隔离边界处理。
最终验收至少确认三件事:训练、验证、测试之间没有共享实体;跨集合精确重复和高相似近重复为零;评测输入中不存在目标答案、评分结果或未来信息。保存切分脚本、随机种子和数据版本后,后续 LoRA、QLoRA 与全参数训练才能基于同一套可信评测基准比较。