
大模型原理与训练 / 系统课时
保存加载与切换适配器
保存加载与切换适配器
LoRA 微调结束后,部署时通常不需要复制一整套基座模型。本节用 PEFT 演示如何只保存适配器、重新挂载到同一基座,并在两个适配器之间切换,同时明确哪些文件必须与基座保持一致。
学习目标
- 只保存 LoRA 适配器权重与配置,并识别它与完整模型的区别。
- 将适配器重新加载到同一基座模型并完成一次前向推理。
- 在多个已加载适配器之间切换,并理解切换成立的前提。
适配器不是完整模型
LoRA 保存的是相对基座模型的增量参数,而不是一份可独立推理的完整权重。常见适配器目录至少包含 adapter_config.json 和适配器权重文件;加载时仍要先得到与训练阶段匹配的基座模型,再把增量权重挂载到对应模块。
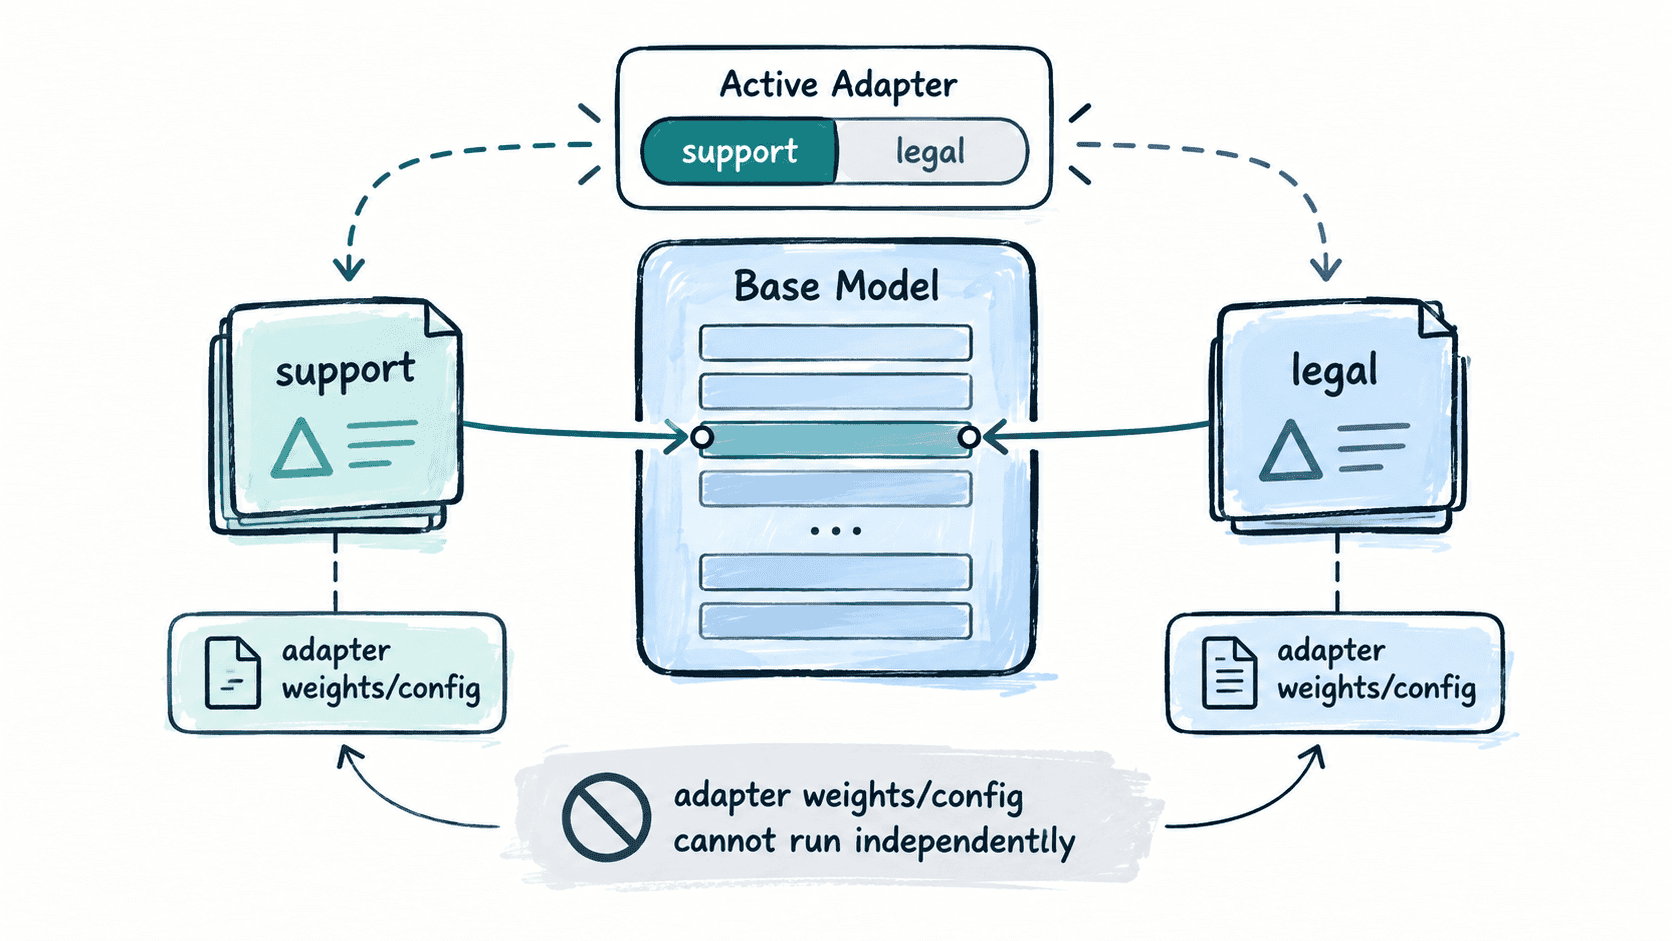
因此,发布适配器时不能只记录一个目录名。至少要保留基座模型标识或本地版本、模型 revision、Tokenizer 版本以及训练时的关键 PEFT 配置;只要基座权重或目标层结构发生变化,同一份适配器就可能无法正确加载,或产生与训练时不同的结果。
保存、加载并切换
下面的脚本完全在本地构造一个很小的 GPT-2 基座,再分别保存两个 LoRA 适配器。它们没有经过训练,只用于验证“保存、重新加载、切换、推理”这条 API 链路;真实项目中直接把两个目录替换成训练完成的领域适配器即可。
from pathlib import Path
import shutil

import torch
from transformers import GPT2Config, GPT2LMHeadModel
from peft import LoraConfig, PeftModel, get_peft_model

torch.manual_seed(7)

base_dir = Path("demo-base")
support_dir = Path("adapter-support")
legal_dir = Path("adapter-legal")
for path in (base_dir, support_dir, legal_dir):
    shutil.rmtree(path, ignore_errors=True)

# 先固定并保存同一份基座,保证两个适配器共享完全相同的底座。
config = GPT2Config(
    vocab_size=64,
    n_positions=32,
    n_embd=32,
    n_layer=1,
    n_head=4,
    bos_token_id=1,
    eos_token_id=2,
)
GPT2LMHeadModel(config).save_pretrained(base_dir)

def save_adapter(target: Path, rank: int) -> None:
    base = GPT2LMHeadModel.from_pretrained(base_dir)
    peft_model = get_peft_model(
        base,
        LoraConfig(
            r=rank,
            lora_alpha=rank * 2,
            target_modules=["c_attn"],
            lora_dropout=0.0,
            bias="none",
            task_type="CAUSAL_LM",
        ),
    )
    peft_model.save_pretrained(target)

save_adapter(support_dir, rank=4)
save_adapter(legal_dir, rank=8)

# 第一个适配器随 PeftModel 创建,第二个再加载到同一个基座实例中。
base = GPT2LMHeadModel.from_pretrained(base_dir)
model = PeftModel.from_pretrained(
    base, support_dir, adapter_name="support", is_trainable=False
)
model.load_adapter(legal_dir, adapter_name="legal", is_trainable=False)
model.eval()

input_ids = torch.tensor([[1, 5, 9, 2]])
for name in ("support", "legal"):
    model.set_adapter(name, inference_mode=True)
    with torch.no_grad():
        logits = model(input_ids=input_ids).logits
    print(f"adapter={name} logits_shape={tuple(logits.shape)}")

print(f"support_has_config={(support_dir / 'adapter_config.json').exists()}")
print(f"legal_has_config={(legal_dir / 'adapter_config.json').exists()}")
预期输出
adapter=support logits_shape=(1, 4, 64)
adapter=legal logits_shape=(1, 4, 64)
support_has_config=True
legal_has_config=True
示例中的两个适配器都是未训练权重,所以不应该用生成文本差异判断领域能力。真正的切换测试应使用同一批固定提示词,在 support 与 legal 间切换后分别生成结果,并确认风格、术语和任务指标符合各自训练目标。
切换时最容易出错的地方
load_adapter 只是把另一个适配器装入当前模型,set_adapter 才决定接下来前向计算使用哪一个。适配器名称必须唯一;推理场景应保持不可训练状态,避免误把线上切换变成参数更新。
多领域部署时,保留一个共享基座并按需加载轻量适配器,通常比复制多份完整模型更省存储;但它也意味着基座成为共同依赖。只要把基座版本、Tokenizer 和适配器版本一起纳入发布清单,运行时切换才是可复现的工程能力。