
大模型原理与训练 / 系统课时
准备 k-bit 可训练模型
准备 k-bit 可训练模型
把基座模型量化成 4bit 后还不能直接开始稳定的 QLoRA 训练。本节按照“加载量化模型 → k-bit 训练准备 → 验证梯度检查点与输入梯度 → 注入 LoRA”的顺序处理模型,并用可执行检查确认只有适配器保持可训练。
学习目标
- 理解
prepare_model_for_kbit_training在量化模型训练前承担的职责 - 按正确顺序启用梯度检查点、准备输入梯度并注入 LoRA
- 检查归一化层精度和可训练参数,确认反向传播链路符合预期
为什么要先做 k-bit 训练准备
4bit 基座权重的目标是节省显存,它们本身通常不作为普通浮点参数直接更新。prepare_model_for_kbit_training 会冻结基座参数,并为低比特训练处理必要的精度与梯度设置;启用梯度检查点时,还要保证冻结基座之后仍有输入进入需要梯度的计算链路。
顺序很重要:先加载量化基座,再做 k-bit 训练准备,最后注入 LoRA。这样可以先稳定基座模型的冻结、精度和梯度检查点状态,再明确地把新加入的 LoRA 参数设置为可训练参数。
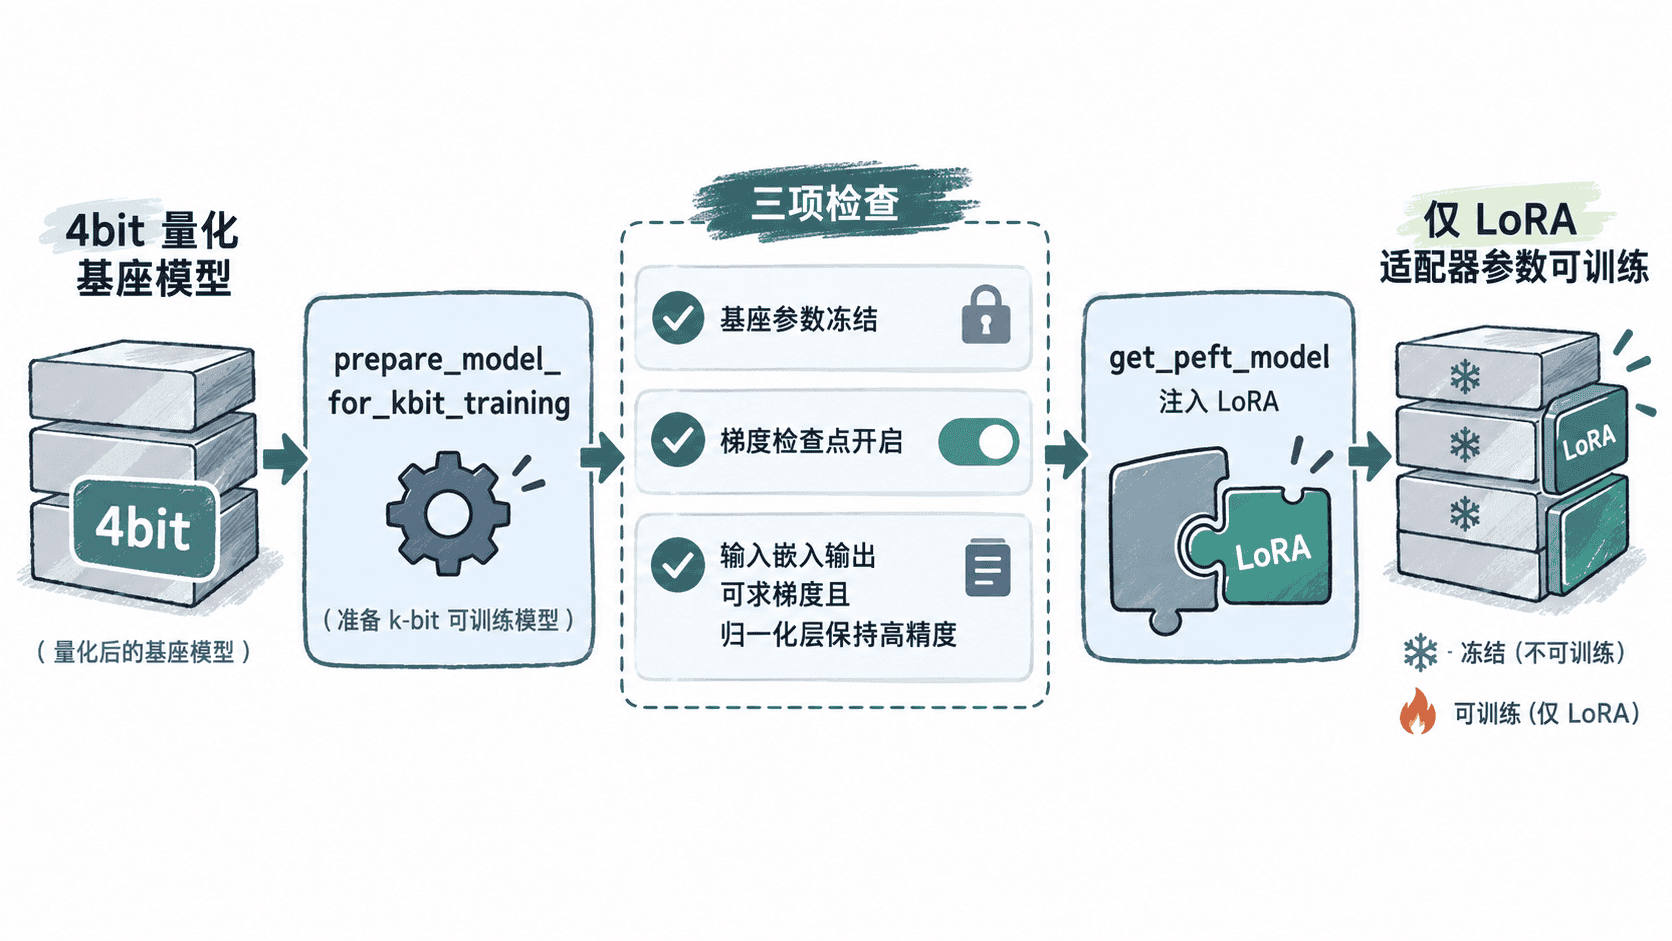
完整准备流程
下面使用公开的小型 OPT 模型演示完整流程,目的是验证 QLoRA 的准备链路。脚本需要 CUDA,以及已安装 torch、transformers、bitsandbytes、accelerate 和 peft。
import torch
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training
from transformers import AutoModelForCausalLM, BitsAndBytesConfig

MODEL_ID = "facebook/opt-125m"

if not torch.cuda.is_available():
    raise RuntimeError("此示例需要可用的 CUDA GPU")

compute_dtype = (
    torch.bfloat16
    if torch.cuda.is_bf16_supported()
    else torch.float16
)

quant_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=True,
)

base_model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    quantization_config=quant_config,
    device_map={"": 0},
    dtype=compute_dtype,
)
base_model.config.use_cache = False

base_model = prepare_model_for_kbit_training(
    base_model,
    use_gradient_checkpointing=True,
)

input_ids = torch.tensor([[2, 3]], device="cuda")
embedding_output = base_model.get_input_embeddings()(input_ids)
norm_dtype = next(
    module.weight.dtype
    for module in base_model.modules()
    if isinstance(module, torch.nn.LayerNorm)
)

print(f"checkpointing={base_model.is_gradient_checkpointing}")
print(f"input_grad={embedding_output.requires_grad}")
print(f"norm_dtype={norm_dtype}")

lora_config = LoraConfig(
    r=8,
    lora_alpha=16,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules="all-linear",
)
model = get_peft_model(base_model, lora_config)

has_trainable_lora = any(
    "lora_" in name and param.requires_grad
    for name, param in model.named_parameters()
)
has_trainable_base = any(
    "lora_" not in name and param.requires_grad
    for name, param in model.named_parameters()
)

print(f"trainable_lora={has_trainable_lora}")
print(f"trainable_base={has_trainable_base}")
预期输出
checkpointing=True
input_grad=True
norm_dtype=torch.float32
trainable_lora=True
trainable_base=False
模型下载进度、显存占用和加载日志会随环境变化;上面五个检查值才是本示例的验收重点。
如何判断准备是否正确
checkpointing=True 说明梯度检查点已启用,它通过在反向传播时重新计算部分前向结果来换取更低的激活显存。input_grad=True 说明嵌入输出能够进入需要梯度的计算链路,这对冻结量化基座后继续使用梯度检查点很关键。
norm_dtype=torch.float32 用来确认归一化相关参数没有跟着低比特权重一起降低精度。最后两项应同时满足:LoRA 参数存在且可训练,非 LoRA 的基座参数保持冻结。若 trainable_base=True,应先停止训练并检查准备与注入顺序。
常见失败的定位顺序
如果开启梯度检查点后反向传播报告张量不需要梯度,先检查嵌入输出的 requires_grad,再确认 prepare_model_for_kbit_training 确实在注入 LoRA 之前执行。若训练参数数量异常,则检查 model.targeted_module_names 或遍历 named_modules(),确认 target_modules 真正命中了预期线性层。
若 loss 很快出现 NaN,同时训练参数边界又正确,再回到计算精度:支持 BF16 的 GPU 优先使用 BF16,不支持时使用 FP16,并确认量化加载、非量化模块和训练参数没有发生意外的 dtype 混用。完成这些检查后,模型才适合继续交给 Trainer、SFTTrainer 或自定义训练循环执行 QLoRA 微调。