
大模型原理与训练 / 系统课时
设置混合精度与梯度累积
设置混合精度与梯度累积
全参数微调最先遇到的通常是显存不足和更新不稳定。本篇用 BF16/FP16 与梯度累积把单卡 micro batch、数据并行副本数和一次优化器更新对应起来,并给出可运行的 PyTorch 示例,验证缩放与更新时机。
学习目标
- 根据 GPU 能力在 BF16 与 FP16 之间做稳定性优先的选择
- 计算 micro batch、梯度累积步数与有效批大小之间的关系
- 正确处理 FP16 梯度缩放、loss 除法和优化器更新时机
先确定混合精度策略
BF16 和 FP16 都能降低激活与部分计算的显存占用,但数值范围不同。BF16 的指数位与 FP32 相同,通常更不容易因为数值范围过窄而溢出或下溢;FP16 精度位更多,但指数范围更小,训练时通常需要动态 loss scaling。
在 PyTorch 中不要只按 GPU 名称猜测,直接用 torch.cuda.is_bf16_supported() 检查运行环境。支持 BF16 时优先尝试 BF16;不支持时再使用 FP16,并开启 GradScaler。若训练仍出现 NaN 或 loss 突然爆炸,再检查学习率、数据异常和梯度裁剪,而不是只在两种精度之间来回切换。
| 模式 | 典型选择 | 梯度缩放 |
|---|---|---|
| BF16 | 硬件原生支持且模型允许 BF16 | 通常不需要 |
| FP16 | 不支持 BF16,但 CUDA 支持半精度训练 | 通常需要动态缩放 |
| FP32 | 调试数值问题或硬件不适合半精度 | 不需要 |
计算一次更新对应多少样本
梯度累积的核心是多次前向与反向传播后再执行一次优化器更新。有效批大小可写成:
其中 B_micro 是每个数据并行进程一次前向处理的样本数,N_accum 是梯度累积步数,N_dp 是数据并行副本数。例如单卡 micro batch=2、累积 4 步时,一次参数更新等价于 8 个样本;若使用 8 个数据并行进程,则是 64 个样本。
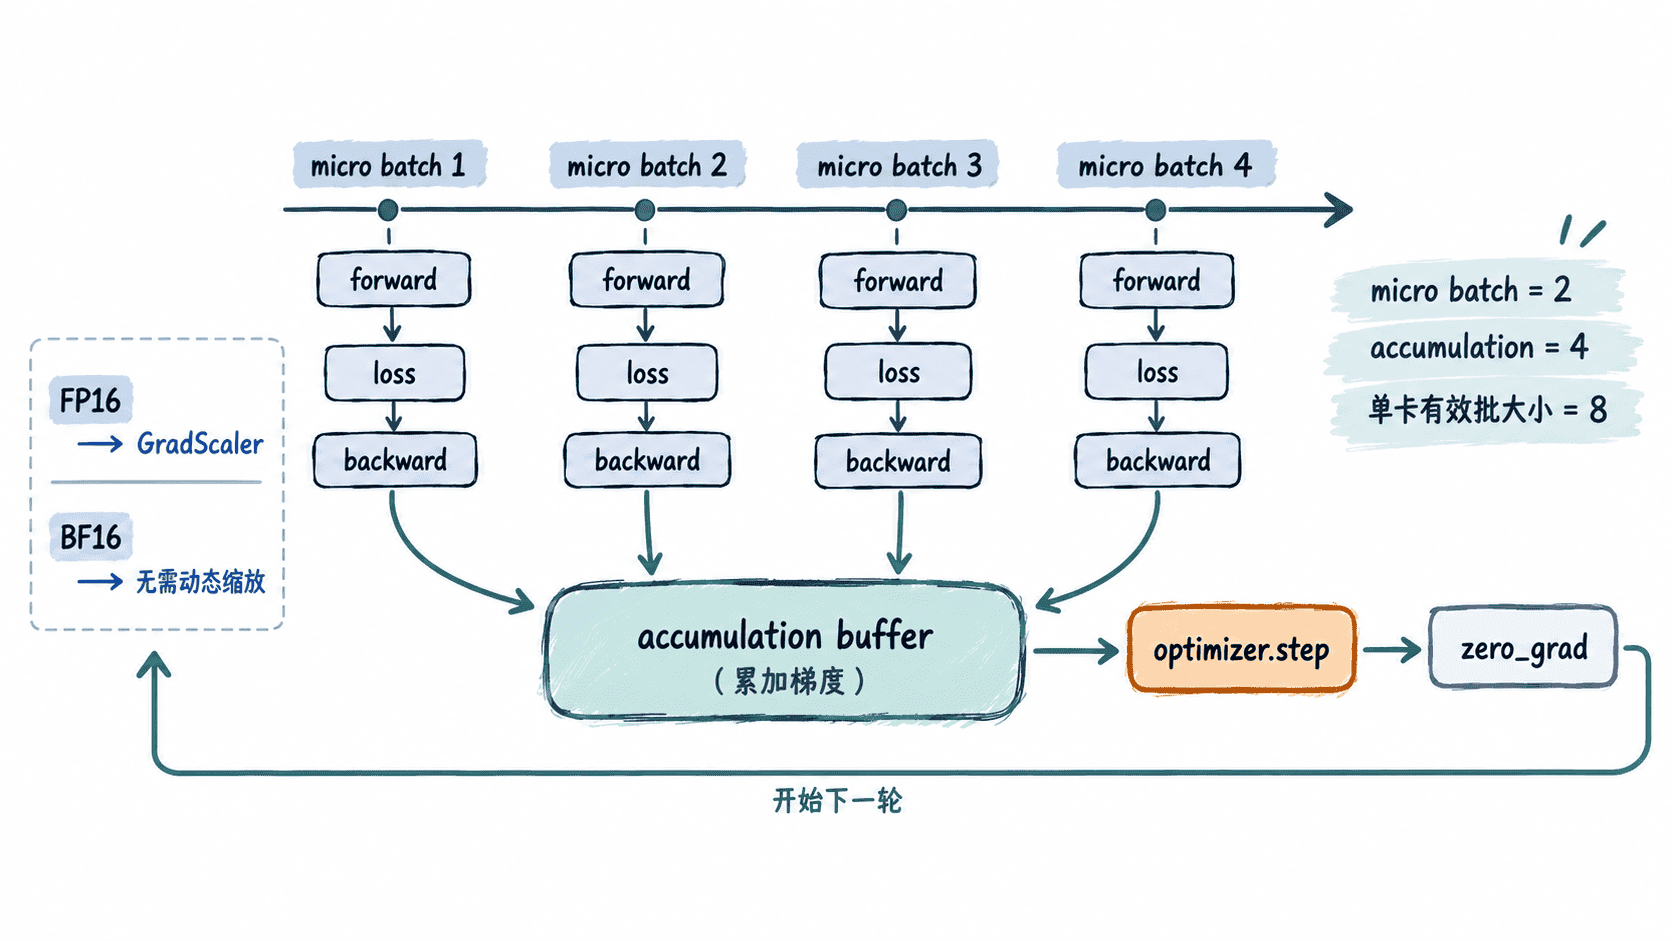
为了让累积后的梯度与“大批次求平均”的尺度一致,通常要在每个 micro step 将 loss 除以 N_accum。如果漏掉这一步,梯度会随累积步数线性放大,等价于偷偷增大学习率。
跑一个最小训练验证
下面的脚本要求可用的 CUDA GPU。它自动选择 BF16 或 FP16,连续处理 8 个 micro batch,每 4 次反向传播执行一次 optimizer.step();FP16 路径使用动态梯度缩放,BF16 路径不启用缩放。
import torch
from torch import nn

if not torch.cuda.is_available():
    raise SystemExit("This example requires a CUDA GPU.")

torch.manual_seed(7)

micro_batch = 2
accum_steps = 4
precision = "bf16" if torch.cuda.is_bf16_supported() else "fp16"
amp_dtype = torch.bfloat16 if precision == "bf16" else torch.float16

model = nn.Sequential(
    nn.Linear(16, 32),
    nn.GELU(),
    nn.Linear(32, 4),
).cuda()

optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
criterion = nn.CrossEntropyLoss()
scaler = torch.amp.GradScaler("cuda", enabled=(precision == "fp16"))

print(f"precision={precision} effective_batch={micro_batch * accum_steps}")

for micro_step in range(8):
    x = torch.randn(micro_batch, 16, device="cuda")
    y = torch.randint(0, 4, (micro_batch,), device="cuda")

    with torch.autocast(device_type="cuda", dtype=amp_dtype):
        logits = model(x)
        loss = criterion(logits, y) / accum_steps

    if scaler.is_enabled():
        scaler.scale(loss).backward()
    else:
        loss.backward()

    if (micro_step + 1) % accum_steps == 0:
        if scaler.is_enabled():
            scaler.step(optimizer)
            scaler.update()
        else:
            optimizer.step()

        optimizer.zero_grad(set_to_none=True)
        update = (micro_step + 1) // accum_steps
        consumed = (micro_step + 1) * micro_batch
        print(f"optimizer_step={update} consumed_samples={consumed}")
预期输出(支持 BF16 的 CUDA GPU):
precision=bf16 effective_batch=8
optimizer_step=1 consumed_samples=8
optimizer_step=2 consumed_samples=16
若 GPU 不支持 BF16,第一行会变为 precision=fp16 effective_batch=8,后两行不变。实际训练中的 loss、显存和吞吐会随硬件与模型不同,本例只验证累积与更新节奏。
映射到大模型训练参数
在 Transformers、Accelerate 或其他训练框架里,对应参数通常仍是“每设备 batch”“梯度累积步数”和“BF16/FP16 开关”。以 8 个数据并行进程、每卡 per_device_train_batch_size=2、gradient_accumulation_steps=4 为例,全局有效批大小是 64。
如果训练框架已经负责混合精度和梯度同步,不要在外层再手动套一层 autocast 或额外 GradScaler,否则容易出现重复缩放或更新顺序错误。验证时应同时观察显存峰值、每秒 token 数、是否出现 overflow/NaN,以及实际每隔多少个 micro step 才发生一次参数更新。
处理不稳定时按顺序排查
出现 NaN、梯度溢出或 loss 长时间不下降时,先确认精度模式与硬件匹配,再检查 loss 是否按累积步数正确缩放,然后核对学习率是否按有效批大小变化过快。FP16 还应确认动态缩放器没有被绕过。
当显存仍不足时,优先减小 micro batch,而不是先改变全局有效批大小;之后通过增加累积步数恢复目标 batch。这样可以把“显存约束”和“优化器统计尺度”分开处理,更容易稳定复现实验。