
大模型原理与训练 / 系统课时
设计领域任务自动评测
设计领域任务自动评测
自动评测的难点不是“算一个分数”,而是让分数真正代表业务成功。本篇把分类、抽取、结构化输出、问答和代码任务分别映射到可重复的判分规则,并把格式错误、模糊匹配与任务正确性拆开处理,避免指标看起来很好却无法反映真实可用性。
学习目标
- 为不同领域任务选择与成功条件一致的自动评测指标。
- 区分内容错误、格式错误和可接受的表面差异。
- 编写可重复运行的评分器,并输出可追踪的总体分数与错误计数。
先从业务成功条件反推指标
评测设计应先问“什么结果才算成功”,再选指标。分类任务通常关心标签是否正确;抽取任务关心实体或字段是否完整;结构化输出不仅要内容正确,还必须能解析并满足字段约束;问答需要处理大小写、标点和有限的表面差异;代码任务则应让单元测试而不是文本相似度决定主要分数。
| 任务 | 推荐主指标 | 需要单独记录的失败 |
|---|---|---|
| 分类 | Accuracy、Macro-F1 | 非法标签 |
| 抽取 | Precision、Recall、F1 | 漏字段、重复字段 |
| 结构化输出 | 解析成功率 + 字段级正确率 | JSON/Schema 格式错误 |
| 短问答 | Exact Match、Token F1、受控模糊匹配 | 答非所问、关键实体错误 |
| 代码 | 单元测试通过率 | 编译失败、超时、运行异常 |
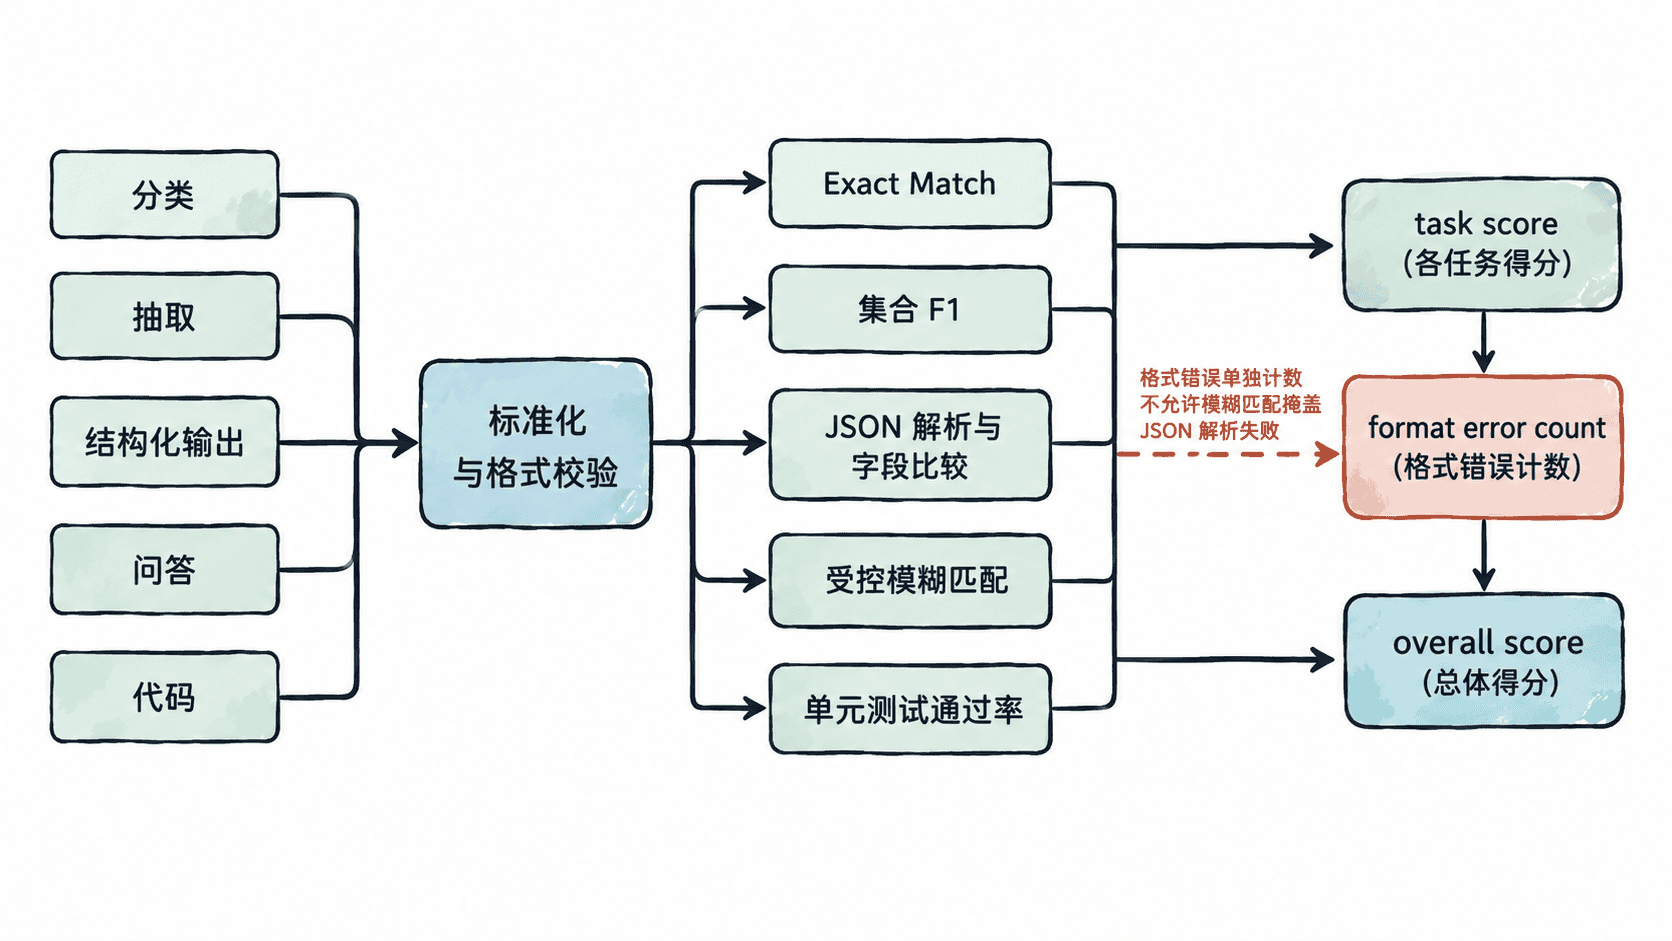
这一步最容易犯的错误,是所有任务都套同一个“相似度”。例如金额、标签和代码结果通常需要严格判定,而自然语言短答可以允许有限的大小写、标点或轻微拼写差异。模糊匹配必须有清晰边界,否则模型输出错误内容也可能因为文本相似而得高分。
编写一个可重复评分器
下面用 Python 标准库实现一个最小评测器。它同时演示分类精确匹配、抽取集合 F1、结构化 JSON 解析、问答受控模糊匹配,以及代码任务的单元测试通过率汇总。结构化输出解析失败会单独累计 format_error,不会被文本相似度“救回来”。
import json
import re
import unicodedata
from difflib import SequenceMatcher

samples = [
    {"type": "classification", "pred": "退款", "gold": "退款"},
    {"type": "extraction", "pred": ["A102", "B7"], "gold": ["B7", "A102"]},
    {"type": "structured", "pred": '{"name":"Ada","age":}', "gold": {"name": "Ada", "age": 36}},
    {"type": "qa", "pred": "Pariss", "gold": "Paris"},
    {"type": "code", "passed_tests": 4, "total_tests": 5},
]

def normalize_text(text):
    text = unicodedata.normalize("NFKC", text).lower()
    return re.sub(r"[\W_]+", "", text, flags=re.UNICODE)

def set_f1(pred, gold):
    pred_set, gold_set = set(pred), set(gold)
    if not pred_set and not gold_set:
        return 1.0
    true_positive = len(pred_set & gold_set)
    precision = true_positive / len(pred_set) if pred_set else 0.0
    recall = true_positive / len(gold_set) if gold_set else 0.0
    return 0.0 if precision + recall == 0 else 2 * precision * recall / (precision + recall)

def score(item):
    task = item["type"]
    if task == "classification":
        return float(normalize_text(item["pred"]) == normalize_text(item["gold"])), False
    if task == "extraction":
        return set_f1(item["pred"], item["gold"]), False
    if task == "structured":
        try:
            parsed = json.loads(item["pred"])
        except json.JSONDecodeError:
            return 0.0, True
        return float(parsed == item["gold"]), False
    if task == "qa":
        pred = normalize_text(item["pred"])
        gold = normalize_text(item["gold"])
        ratio = SequenceMatcher(None, pred, gold).ratio()
        return float(pred == gold or ratio >= 0.90), False
    if task == "code":
        return item["passed_tests"] / item["total_tests"], False
    raise ValueError(f"unsupported task: {task}")

scores = []
format_errors = 0

for item in samples:
    value, format_error = score(item)
    scores.append(value)
    format_errors += int(format_error)
    print(f"{item['type']}: score={value:.3f} format_error={format_error}")

print(f"mean_score={sum(scores) / len(scores):.3f}")
print(f"format_errors={format_errors}")
预期输出
classification: score=1.000 format_error=False
extraction: score=1.000 format_error=False
structured: score=0.000 format_error=True
qa: score=1.000 format_error=False
code: score=0.800 format_error=False
mean_score=0.760
format_errors=1
这个示例故意让结构化输出失败:虽然字符串里能看出模型“想表达什么”,但 JSON 无法解析,业务链路就无法消费,因此应直接记为格式错误。对代码任务也没有比较生成文本,而是把测试通过率作为结果,这更接近真实执行成功条件。
控制模糊匹配的边界
模糊匹配适合处理大小写、标点、全半角、轻微拼写差异或可枚举别名,不适合放宽事实错误。像订单号、金额、类别标签、日期和结构化字段值,通常应采用精确规则或领域容差,而不是通用字符串相似度。
如果一个问答任务允许多个同义答案,优先维护可审计的参考答案集合或规范化规则。例如“纽约市”和“New York City”可以通过别名表归一化;如果需要模型裁判,则应把它作为独立指标,并保存裁判提示词、模型版本和原始判决,避免评测本身不可复现。
让评测结果能指导模型选择
总体平均分只能作为入口。模型选择时至少同时保留每类任务分数、格式错误率和关键失败样例,否则一个任务的高分可能掩盖另一个任务的严重退化。业务上不可接受的失败还可以设为硬门槛,例如结构化解析成功率必须不低于 99.5%,否则无论平均分多高都不进入候选。
评测集也要固定版本,并避免和训练数据泄漏。每次比较检查点时使用同一份样本、同一套标准化规则、同一阈值和同一测试环境;只有这样,分数差异才能解释为模型差异,而不是评测脚本或数据版本变化。