
大模型原理与训练 / 系统课时
排查 OOM 与训练不稳定
排查 OOM 与训练不稳定
显存不足、NaN、梯度爆炸和吞吐下降经常同时出现,但修复顺序不同。本节给出一条从低成本参数到分片训练的定位路径,先确认 OOM 发生在哪个阶段,再在不破坏有效批大小和数值稳定性的前提下逐步收缩显存。
学习目标
- 按序列长度、微批大小、梯度累积、检查点、量化和参数分片定位 OOM
- 区分 NaN、梯度爆炸与吞吐下降的主要信号和根因
- 用 GPU 监控与复跑结果验证修复是否真正生效
先确认 OOM 发生在哪个阶段
同样是 CUDA out of memory,发生阶段不同,优先检查项也不同。加载模型时就失败,通常是权重或分片策略问题;前向或反向阶段失败,更常见的是序列长度、微批和激活占用;优化器 step 才失败,则要额外关注优化器状态和全参数训练的梯度占用。
| 发生位置 | 优先怀疑 | 第一动作 |
|---|---|---|
| 模型加载 | 权重精度、设备映射、参数未分片 | 检查加载 dtype 与分片 |
| 前向计算 | 序列过长、微批过大 | 降低最大序列长度或微批 |
| 反向计算 | 激活、梯度、检查点未启用 | 开启梯度检查点 |
| optimizer step | 优化器状态、全参数训练 | 评估 8-bit optimizer 或参数分片 |
| 评测/生成 | eval batch、生成长度、KV cache | 单独降低评测批量和生成长度 |
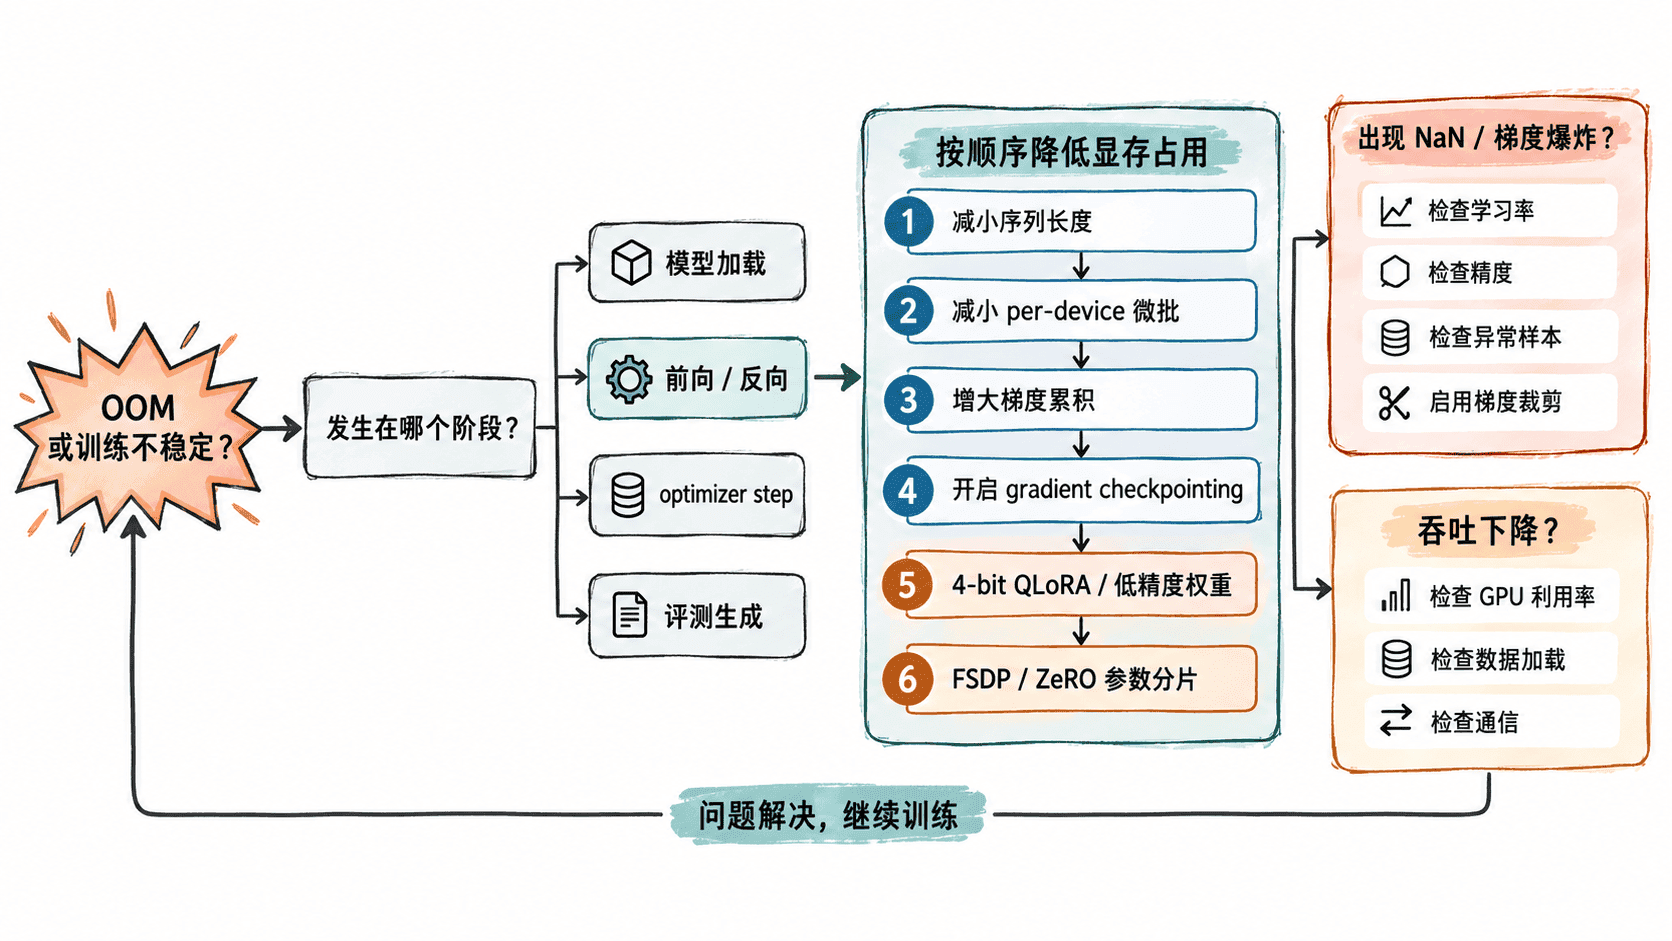
这条顺序的目的不是机械地逐项减参数,而是先改动对训练语义影响最小、最容易验证的变量,再引入计算换显存或通信换显存的方案。
用 GPU 探针确认现状
先记录空闲显存、当前占用和利用率,避免把“机器上还有别的进程”误判为训练配置问题。下面命令可直接运行在安装了 NVIDIA 驱动的训练节点上。
nvidia-smi --query-gpu=index,name,memory.total,memory.used,memory.free,utilization.gpu --format=csv,noheader,nounits预期输出:
0, <GPU_NAME>, <TOTAL_MB>, <USED_MB>, <FREE_MB>, <UTIL_PERCENT>实际型号和数值会不同。若训练还未启动就已经占用了大量显存,应先确认是否存在其他进程;若 OOM 前显存逐步增长且不回落,则还要检查是否把带计算图的 tensor 长期保存在列表、日志对象或缓存中。
按成本从低到高释放显存
先缩短序列长度。Transformer 训练的激活占用会随 token 数显著增加,普通注意力的计算和中间张量还可能呈近似二次增长。数据允许时,把 max_seq_length 从过高值降到真实业务需要的上限,通常比先动优化器更有效。
再降低每张卡的微批大小。有效批大小可近似写成:
其中 是单卡微批, 是梯度累积步数, 是数据并行进程数。若把微批从 4 降到 1,可以提高 来保持相近的有效批大小。梯度累积本身不会降低单个微批的激活显存,它的作用是允许使用更小微批而不必同步缩小有效批。
仍然不足时再启用 gradient checkpointing,用重复计算换取更低的激活保存量。它通常会降低吞吐,因此修复 OOM 后要重新测 step time,而不能只看“终于能跑起来”。
如果是 LoRA/QLoRA 路线,可进一步用 4-bit 量化保存冻结的基座权重,以显著降低权重显存。全参数训练则不能简单把“QLoRA 省显存”直接套用,因为需要更新的参数、梯度和优化器状态仍然占据主要空间。
最后才进入 FSDP 或 ZeRO 等参数分片,把参数、梯度或优化器状态拆到多张卡。分片能突破单卡容量,但会增加通信、配置和恢复复杂度,适合前面几项已经无法满足目标模型规模时使用。
处理 NaN 与梯度爆炸
OOM 解决后如果 loss 变成 NaN,不要继续盲目降 batch。先检查首个出现非有限值的 step,并按以下顺序定位:异常样本或无效 label、学习率过高、低精度溢出、梯度爆炸、损失函数输入范围错误。
在支持 BF16 的硬件上,BF16 通常比 FP16 有更大的指数范围;使用 FP16 时应确认动态 loss scaling 没有持续回退。对于偶发梯度尖峰,可以设置梯度裁剪,但裁剪只能限制结果,不能替代对异常数据和过高学习率的定位。
若 NaN 在开启量化或混合精度后才出现,应单独复跑一个短实验,对比相同 seed、相同数据和相同学习率下的非量化或更高精度配置,确认问题来自数值路径而不是数据本身。
判断吞吐为什么下降
显存优化通常有代价。gradient checkpointing 会增加重算,FSDP/ZeRO 会增加通信,过小微批会降低算子利用率,过大的梯度累积则可能让单位 optimizer step 变慢。吞吐下降时,应同时看 GPU 利用率、数据加载等待和多卡通信,而不是只比较显存峰值。
如果 GPU 利用率长期很低而显存并不紧张,优先检查 DataLoader、CPU 预处理、存储吞吐和同步点;如果多卡规模扩大后每卡利用率下降,重点检查 all-reduce 或分片通信是否成为瓶颈。
用复跑结果验收修复
一次修复至少要同时满足三个条件:峰值显存留有安全余量;loss 与梯度范数保持有限且走势合理;吞吐没有下降到不可接受的程度。每次只改一到两个变量,并记录序列长度、微批、累积步数、检查点、量化和分片配置,才能知道是哪一项真正解决了问题。
排查的核心顺序是:先确认 OOM 阶段,再缩短序列和微批,用梯度累积维持有效批,然后用 checkpointing 以计算换显存,最后才引入量化或分片。数值不稳定和吞吐下降必须作为独立信号验证,不能用“没有 OOM”代替训练健康。