
大模型原理与训练 / 系统课时
理解 4bit 量化训练链路
理解 4bit 量化训练链路
QLoRA 的关键不是“用 4bit 做所有训练计算”,而是把冻结的基座权重以 4bit 保存,在计算时按需反量化,同时只让 LoRA 适配器接收梯度和更新。本篇把存储精度、计算精度与可训练参数拆开,建立一条不会混淆的前向与反向链路。
学习目标
- 说明基座权重、反量化计算与 LoRA 权重分别承担什么职责。
- 判断哪些参数被冻结、哪些张量需要梯度与优化器状态。
- 沿一次前向和反向传播解释 QLoRA 为什么能显著降低参数相关显存。
QLoRA 真正压缩的是基座权重存储
标准 LoRA 已经冻结大模型基座,只训练低秩矩阵;QLoRA 再把冻结基座从 FP16/BF16 等高精度权重压到 4bit 表示。训练时长期驻留显存的是量化后的权重及其量化元数据,而不是一份完整的高精度基座参数。
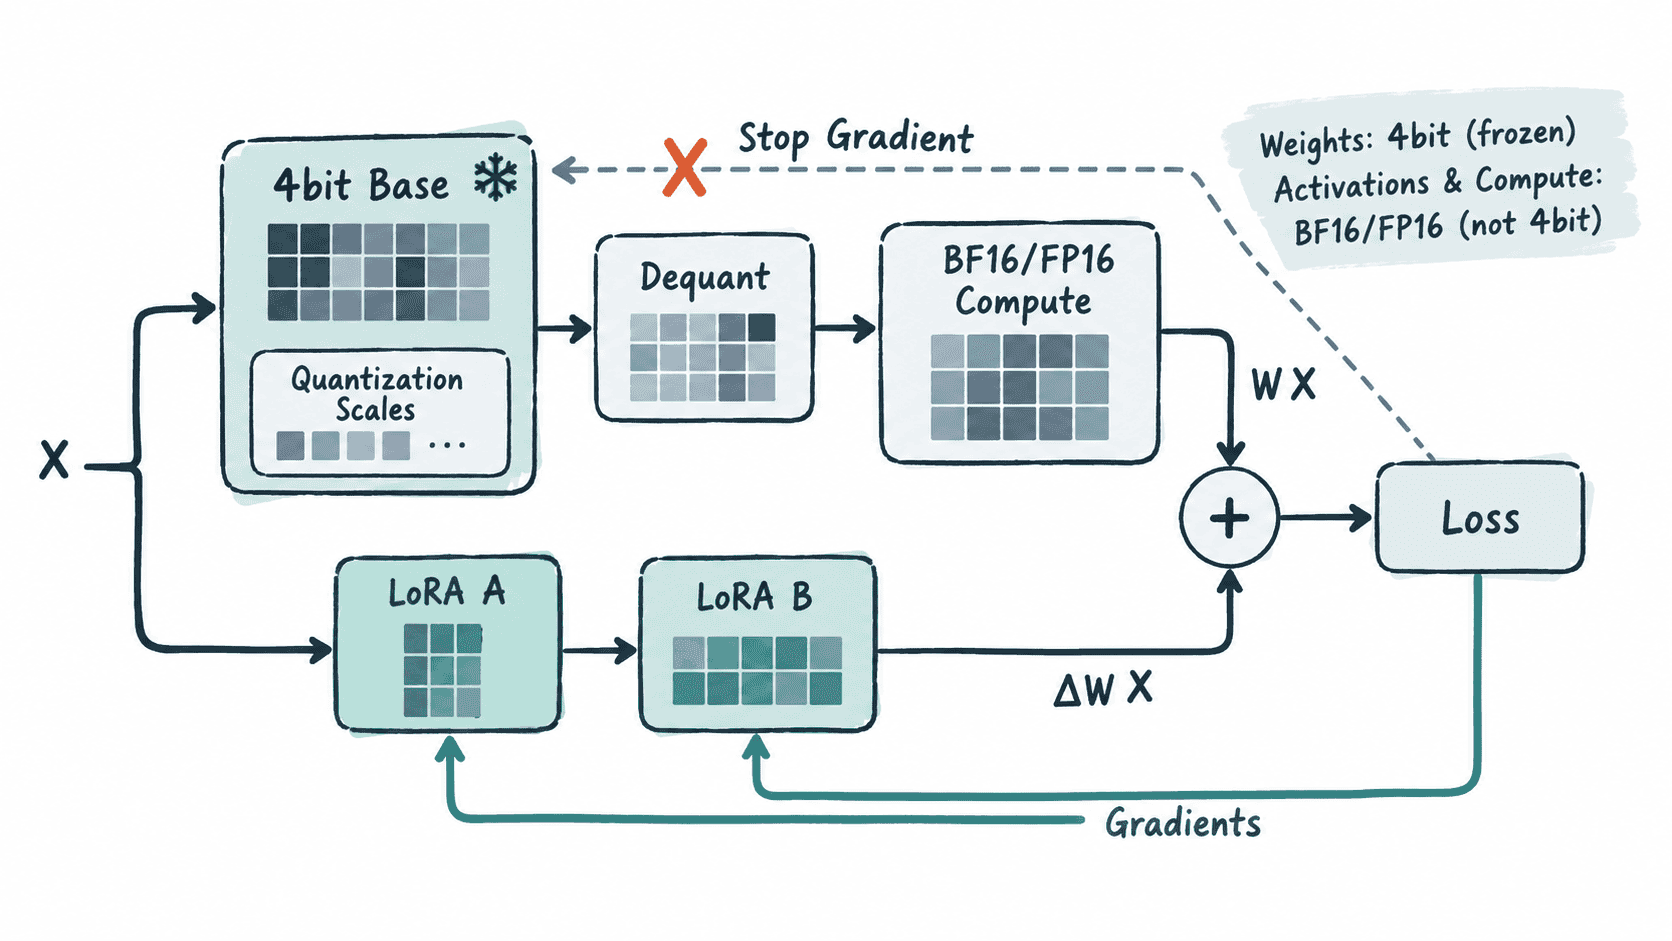
4bit 并不意味着矩阵乘法直接以 4bit 完成。典型实现会在算子内部按块读取量化权重,用对应缩放信息恢复到指定计算类型,再与激活做矩阵乘法。这个恢复过程是按需进行的,不需要长期保存另一份完整的 BF16 基座副本。
前向计算和反向更新走的是两条路径
一次线性层计算可以理解为两条支路相加:基座支路读取量化权重并临时反量化,LoRA 支路用可训练的低秩矩阵计算增量。前向时两条支路都影响输出,因此损失函数仍然“看得到”完整模型能力。
反向传播时,冻结基座不需要保存参数梯度,也不需要为它建立 Adam 的一阶、二阶状态;梯度只用于求出 LoRA 参数的更新量。激活及其反向所需中间量仍可能以 BF16、FP16 或 FP32 存在,所以 QLoRA 主要减少的是参数、参数梯度与优化器状态相关的显存,并不会自动消除长序列带来的激活显存。
用最小实验观察冻结与梯度
下面用一个教学版线性层模拟这条链路。为了便于观察,4bit 码值放在 int8 容器里,并没有做真实的半字节打包;生产实现通常采用分块量化和专用内核,因此这个示例只验证“冻结量化基座、反量化参与前向、梯度只进入 LoRA”的关系。
import torch
from torch import nn

torch.manual_seed(7)

def quantize_4bit_symmetric(weight: torch.Tensor):
    scale = weight.abs().max() / 7
    q = torch.clamp(torch.round(weight / scale), -8, 7).to(torch.int8)
    return q, scale

class TinyQLoRALinear(nn.Module):
    def __init__(self, in_features: int, out_features: int, rank: int):
        super().__init__()
        base = torch.randn(out_features, in_features)
        q_weight, scale = quantize_4bit_symmetric(base)

        # 量化基座注册为 buffer,因此不会进入可训练参数集合。
        self.register_buffer("q_weight", q_weight)
        self.register_buffer("scale", scale)

        # 只有 LoRA 低秩矩阵参与梯度更新。
        self.lora_a = nn.Parameter(torch.randn(rank, in_features) * 0.01)
        self.lora_b = nn.Parameter(torch.randn(out_features, rank) * 0.01)

    def forward(self, x: torch.Tensor):
        base_weight = self.q_weight.to(torch.float32) * self.scale
        lora_weight = self.lora_b @ self.lora_a
        return x @ (base_weight + lora_weight).T

model = TinyQLoRALinear(4, 3, rank=2)
loss = model(torch.ones(2, 4)).square().mean()
loss.backward()

trainable = [name for name, _ in model.named_parameters()]
print(model.q_weight.dtype)
print(trainable)
print(model.lora_a.grad is not None, model.lora_b.grad is not None)
预期输出
torch.int8
['lora_a', 'lora_b']
True True
这里的 int8 只是承载取值范围为 4bit 的教学码值,不能据此估算真实显存;真正的 4bit 内核会使用更紧凑的存储。关键观察是:基座权重没有出现在 named_parameters() 中,而两个 LoRA 矩阵都有梯度。
分清长期驻留与临时计算张量
| 对象 | 常见精度或形式 | 是否训练更新 | 显存含义 |
|---|---|---|---|
| 基座权重 | 4bit 量化存储 | 否 | QLoRA 最主要的参数显存节省来源 |
| 量化缩放等元数据 | 高于 4bit,按块保存 | 否 | 体积较小,但仍有额外开销 |
| 反量化后的计算值 | BF16、FP16 或 FP32 | 否 | 算子计算时临时出现,不等于长期复制整模型 |
| LoRA A/B | 通常 BF16、FP16 或 FP32 | 是 | 需要参数、梯度,通常还需要优化器状态 |
| 激活与反向中间量 | 依训练配置而定 | 不作为参数更新 | 长序列和大 batch 下仍可能成为显存主因 |
因此,看到“4bit QLoRA”时应先问三个问题:4bit 存在哪里、矩阵乘法用什么计算类型、优化器到底管理哪些参数。这三个答案分别对应存储、计算和更新,只有把它们分开,才能正确判断显存占用与数值行为。