
大模型原理与训练 / 系统课时
降低灾难性遗忘与过拟合
降低灾难性遗忘与过拟合
这一节解决两个常见失败:模型在领域数据上越来越会答,却把通用能力忘掉;或者训练 loss 持续下降,但验证集已经转坏。目标是用更小学习率、受控训练轮数、数据混合、双验证集监控和早停,把领域收益限制在可接受的基础能力回退范围内。
学习目标
- 区分过拟合与灾难性遗忘,并用不同指标发现它们
- 通过学习率、轮数和通用回放数据降低能力漂移
- 用领域验证集与通用回归集共同决定是否继续训练
用两类验证信号判断问题
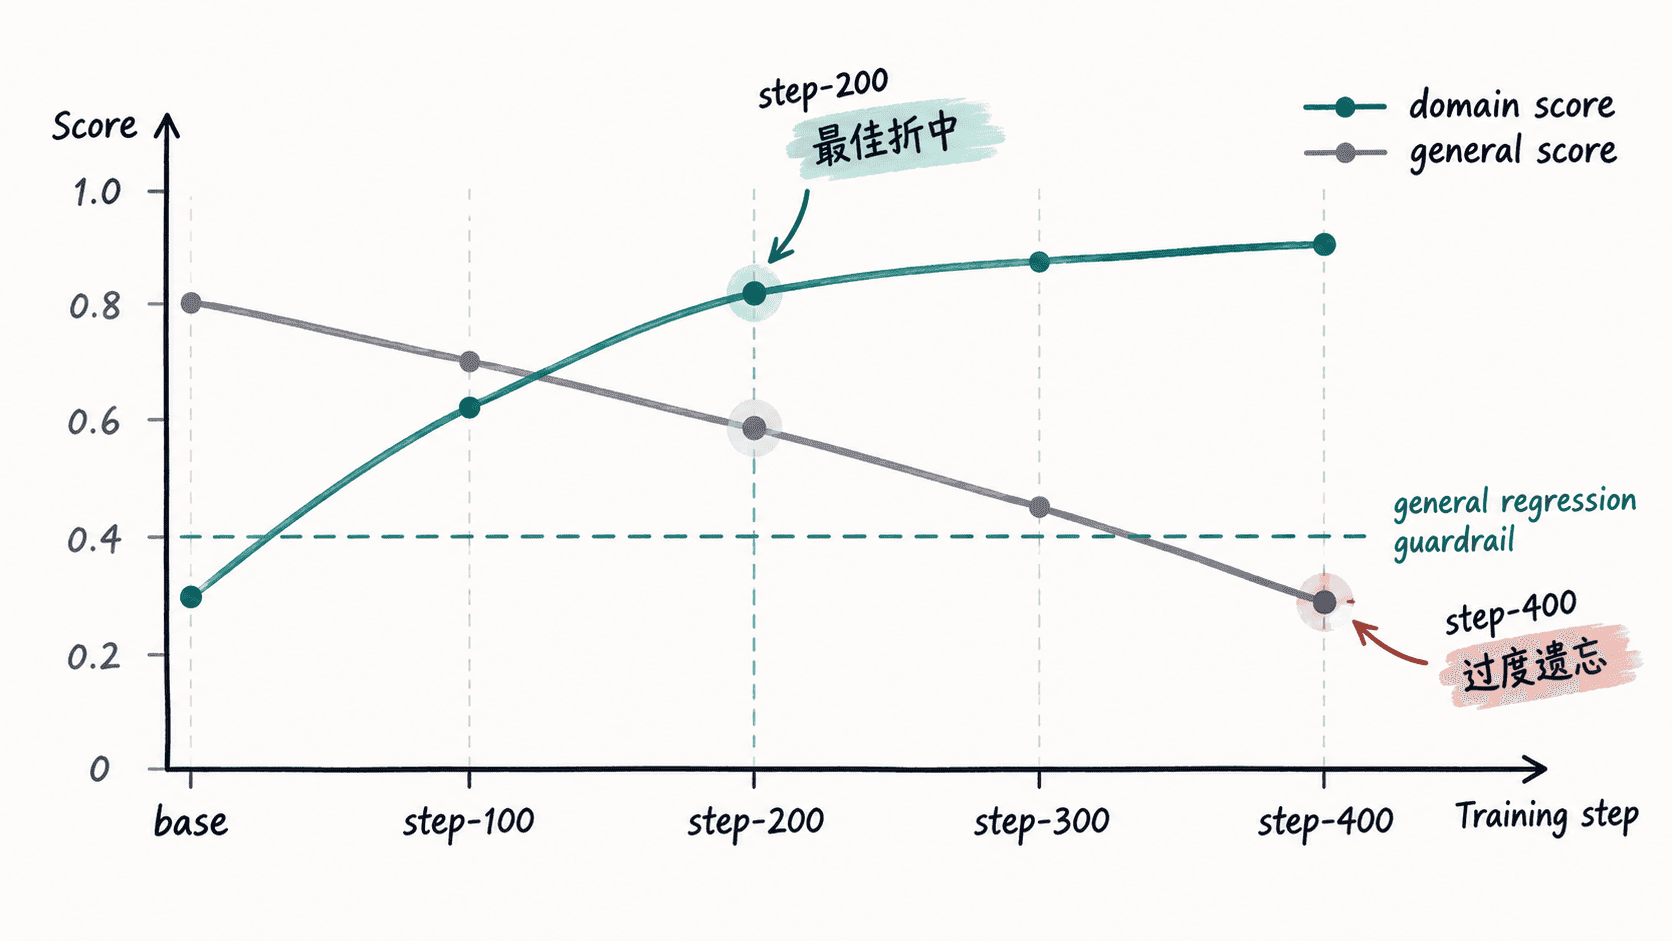
只看训练 loss 无法判断模型是否真的变好。至少保留两组评测:领域验证集检查目标任务是否提升,通用回归集检查基础能力是否明显下降。前者转坏通常指向过拟合;前者提升而后者持续下跌,更像灾难性遗忘。
建议把每个 checkpoint 的结果记录成同一张小表,并始终使用相同样本、解码参数和评分方式。
| checkpoint | domain score | general score | 判断 |
|---|---|---|---|
| base | 72.0 | 81.0 | 基线 |
| step-200 | 78.5 | 80.4 | 可接受 |
| step-400 | 79.1 | 76.8 | 领域继续涨,但遗忘明显 |
这里的数值仅用于说明判断方法,不代表任何模型的真实成绩。真正的阈值应由业务容忍度决定,例如要求领域指标提升的同时,通用回归集下降不超过预先定义的百分点。
先收紧训练强度
全参数微调比 LoRA 更容易让模型整体权重发生漂移,因此学习率通常应更保守,训练轮数也不宜机械拉长。若领域验证集在前几百步已经达到平台期,继续训练只会增加过拟合与遗忘风险。
调整顺序建议保持稳定:先降低学习率,再减少总训练步数或 epoch;若领域数据很窄,再加入通用回放样本。不要同时大幅修改多个变量,否则无法判断是哪项改变带来了改善。
混入通用回放并启用早停
下面是片段示例,依赖一个已经创建好的 model、tokenizer,以及完成相同 token 化处理的 domain_train、general_replay 和 domain_valid。它展示两件事:训练时以 0.8/0.2 的抽样概率混合领域数据与通用回放数据;Trainer 根据领域验证集 eval_loss 在连续多次无改善后提前停止。
from datasets import interleave_datasets
from transformers import EarlyStoppingCallback, Trainer, TrainingArguments

mixed_train = interleave_datasets(
    [domain_train, general_replay],
    probabilities=[0.8, 0.2],
    seed=42,
    stopping_strategy="all_exhausted",
).shuffle(seed=42)

args = TrainingArguments(
    output_dir="<PATH>/full-sft-guarded",
    learning_rate=5e-6,
    num_train_epochs=3,
    per_device_train_batch_size=1,
    gradient_accumulation_steps=16,
    eval_strategy="steps",
    eval_steps=100,
    save_strategy="steps",
    save_steps=100,
    load_best_model_at_end=True,
    metric_for_best_model="eval_loss",
    greater_is_better=False,
    save_total_limit=3,
    report_to="none",
)

trainer = Trainer(
    model=model,
    args=args,
    train_dataset=mixed_train,
    eval_dataset=domain_valid,
    processing_class=tokenizer,
    callbacks=[EarlyStoppingCallback(early_stopping_patience=2)],
)
这段配置生效后,训练会在每 100 步验证一次,并把领域验证集 loss 作为“是否继续”的主要信号;连续两个评估周期无改善时触发早停。probabilities 表示抽样概率,在 all_exhausted 策略下不等同于最终样本数严格 8:2。这个比例不是固定答案,应通过领域收益与通用回归结果共同调整,而不是只追求更低的训练 loss。
把通用回归集设成硬门槛
早停只能阻止领域验证指标继续恶化,却不能自动保护通用能力。因此每个候选 checkpoint 还要跑同一套通用回归样本,并设置硬门槛。例如领域分数至少提升 4 分,同时通用分数下降不得超过 1 分;不满足就回退到更早的 checkpoint,或者降低学习率、增加通用回放比例后重训。
什么时候应该停止继续拟合
出现以下信号时,应优先停止而不是继续堆 epoch:领域验证 loss 连续恶化;领域分数几乎不再提升;通用回归集持续跨过容忍阈值;不同随机种子的结果开始剧烈波动。此时继续训练通常不会带来稳定收益。
降低灾难性遗忘的关键不是某一个参数,而是建立双目标约束:领域能力要提升,通用能力又不能跌出护栏。学习率、训练时长和数据混合负责控制漂移幅度,验证集、回归集与早停负责在漂移失控之前把训练停下来。