
大模型原理与训练 / 系统课时
配置 DeepSpeed ZeRO 分片
配置 DeepSpeed ZeRO 分片
DeepSpeed ZeRO 的配置重点是先决定“分片到哪一层”,再决定是否把状态继续卸载到 CPU 或 NVMe,并用通信 bucket 控制显存与吞吐的交换。本节用 ZeRO-3 跑一个最小训练脚本,保存分片检查点,并验证检查点可以继续被 DeepSpeed 工具识别。
学习目标
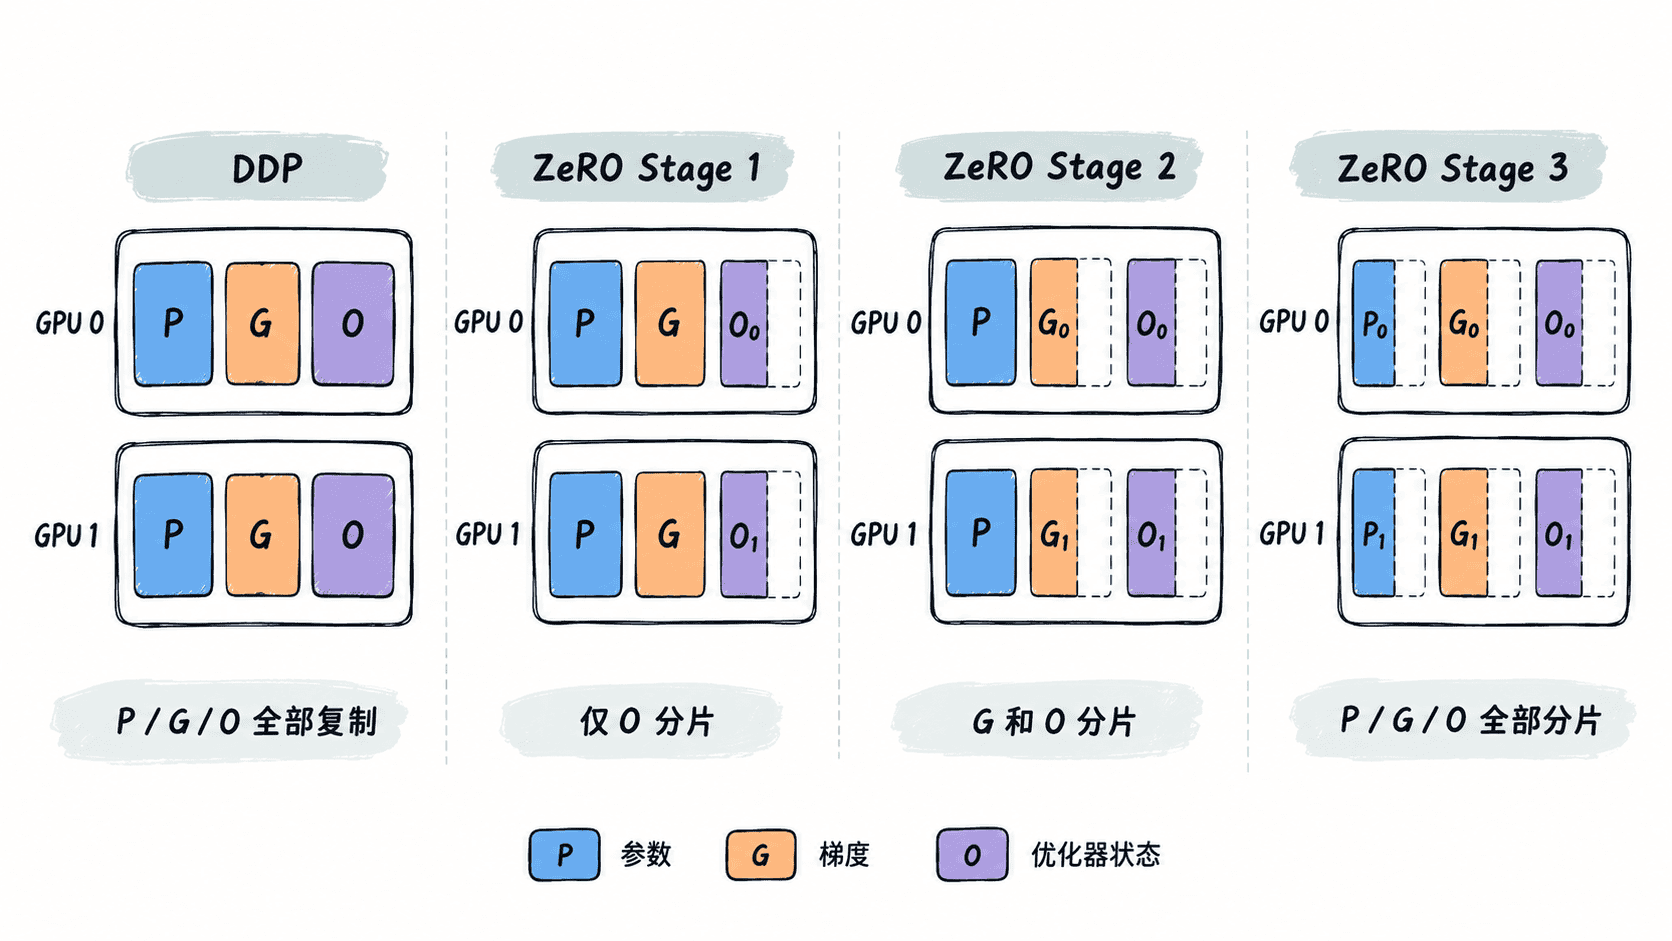
- 能区分 ZeRO Stage 1、2、3 分别切分优化器状态、梯度和参数。
- 能配置 optimizer/parameter offload 与常用通信参数,并判断其性能代价。
- 能保存和检查 ZeRO 分片检查点,理解它与单文件 PyTorch 权重的区别。
先选 ZeRO stage
ZeRO 的 stage 是递进关系:Stage 1 只分片优化器状态;Stage 2 再分片梯度;Stage 3 进一步分片模型参数。stage 越高,单卡常驻显存越低,但参数重建、collective 通信和检查点处理也更复杂。
| 模式 | 主要分片对象 | 典型用途 |
|---|---|---|
| Stage 1 | 优化器状态 | 模型能放下,但 Adam 等状态占显存较多 |
| Stage 2 | 优化器状态、梯度 | 反向阶段显存压力明显 |
| Stage 3 | 优化器状态、梯度、参数 | 参数本身也无法在每张 GPU 保留完整副本 |
编写 ZeRO-3 配置
下面配置启用 Stage 3,并把优化器状态卸载到 CPU。overlap_comm 尝试把通信与反向计算重叠,contiguous_gradients 减少梯度内存碎片,bucket 大小则控制一次通信处理的元素规模。
{
  "train_micro_batch_size_per_gpu": 2,
  "gradient_accumulation_steps": 1,
  "optimizer": {
    "type": "AdamW",
    "params": {
      "lr": 0.001
    }
  },
  "zero_optimization": {
    "stage": 3,
    "contiguous_gradients": true,
    "overlap_comm": true,
    "reduce_bucket_size": 50000000,
    "allgather_bucket_size": 50000000,
    "stage3_prefetch_bucket_size": 50000000,
    "offload_optimizer": {
      "device": "cpu",
      "pin_memory": true
    }
  }
}
这份配置不会单独产生控制台输出。将其保存为 ds_config.json 后,验证方法是由 DeepSpeed 启动训练,并观察初始化日志中 ZeRO stage 为 3,同时训练能完成至少一个 optimizer step。
如果 GPU 显存仍不足,可以在 Stage 3 下增加 offload_param,把参数也卸载到 CPU 或 NVMe;但 PCIe、CPU 内存或 NVMe 带宽会进入关键路径,吞吐往往下降。不要在尚未测量瓶颈前同时开启所有 offload。
运行训练并保存检查点
下面脚本创建一个小型语言模型,完成一次前向、反向和更新。所有 rank 都调用 save_checkpoint(),因为 ZeRO 检查点包含各 rank 的分片,不能只让 rank 0 参与保存。
import torch
import torch.nn as nn
import torch.nn.functional as F
import deepspeed


class TinyLM(nn.Module):
    def __init__(self, vocab_size=512, hidden_size=256):
        super().__init__()
        self.embed = nn.Embedding(vocab_size, hidden_size)
        self.ffn = nn.Sequential(
            nn.Linear(hidden_size, hidden_size * 4),
            nn.GELU(),
            nn.Linear(hidden_size * 4, hidden_size),
        )
        self.lm_head = nn.Linear(hidden_size, vocab_size)

    def forward(self, input_ids):
        x = self.embed(input_ids)
        x = self.ffn(x)
        return self.lm_head(x)


model = TinyLM()
engine, _, _, _ = deepspeed.initialize(
    model=model,
    model_parameters=model.parameters(),
    config="ds_config.json",
)

# 每个 rank 使用不同样本,但都参与同一步数据并行训练。
torch.manual_seed(7 + engine.global_rank)
input_ids = torch.randint(0, 512, (2, 32), device=engine.device)
targets = torch.randint(0, 512, (2, 32), device=engine.device)

logits = engine(input_ids)
loss = F.cross_entropy(logits.reshape(-1, 512), targets.reshape(-1))
engine.backward(loss)
engine.step()

if engine.global_rank == 0:
    print(f"loss={loss.item():.4f}")

# 所有 rank 都必须进入保存调用,避免分布式同步不完整。
engine.save_checkpoint(
    "checkpoints",
    tag="step1",
    client_state={"step": 1},
)

if engine.global_rank == 0:
    print("checkpoint=checkpoints/step1")
预期输出(由下方 DeepSpeed launcher 启动后;初始化日志会更多,loss 为动态值):
loss=<LOSS>
checkpoint=checkpoints/step1
启动两张 GPU:
deepspeed --num_gpus=2 train_zero.py预期输出:
loss=<LOSS>
checkpoint=checkpoints/step1
<LOSS> 会随随机数、GPU 和 DeepSpeed 版本略有不同;关键验收条件是进程无 OOM、完成一步更新并成功写入 step1 检查点。
验证检查点格式
ZeRO-3 保存的是可恢复训练的分片检查点,不应把其中某个 rank 文件误当成完整模型权重。先检查顶层的 latest 指针、对应 tag 目录,以及 DeepSpeed 随检查点提供的权重恢复工具。
python - <<'PY'
from pathlib import Path

root = Path("checkpoints")
print((root / "latest").read_text().strip())
print((root / "step1").is_dir())
print((root / "zero_to_fp32.py").is_file())
PY
预期输出:
step1
True
True
如果最终要脱离 DeepSpeed 发布普通权重,可使用检查点目录中的 zero_to_fp32.py 在 CPU 侧重建完整权重;大模型转换时要预留足够主机内存。训练恢复则应继续使用 ZeRO 分片检查点,而不是先合并再重新切分。
调整 offload 与通信参数
当显存不足但 GPU 算力有余时,先尝试 Stage 3,再根据瓶颈决定是否 offload。optimizer offload 主要转移优化器状态和优化器计算;parameter offload 会进一步降低 GPU 参数驻留,但对主机内存和总线带宽更敏感。
bucket 并不是越小越省事:较小 bucket 可降低单次临时缓冲峰值,却会增加 collective 次数;较大 bucket 通常更利于带宽利用,却可能抬高临时显存。验收时固定 batch、序列长度和精度,同时记录峰值显存、每 step 时间和 checkpoint 保存耗时,才能判断当前 ZeRO 配置是否比 DDP 或较低 stage 更合适。