
大模型原理与训练 / 系统课时
验证合并前后输出一致性
验证合并前后输出一致性
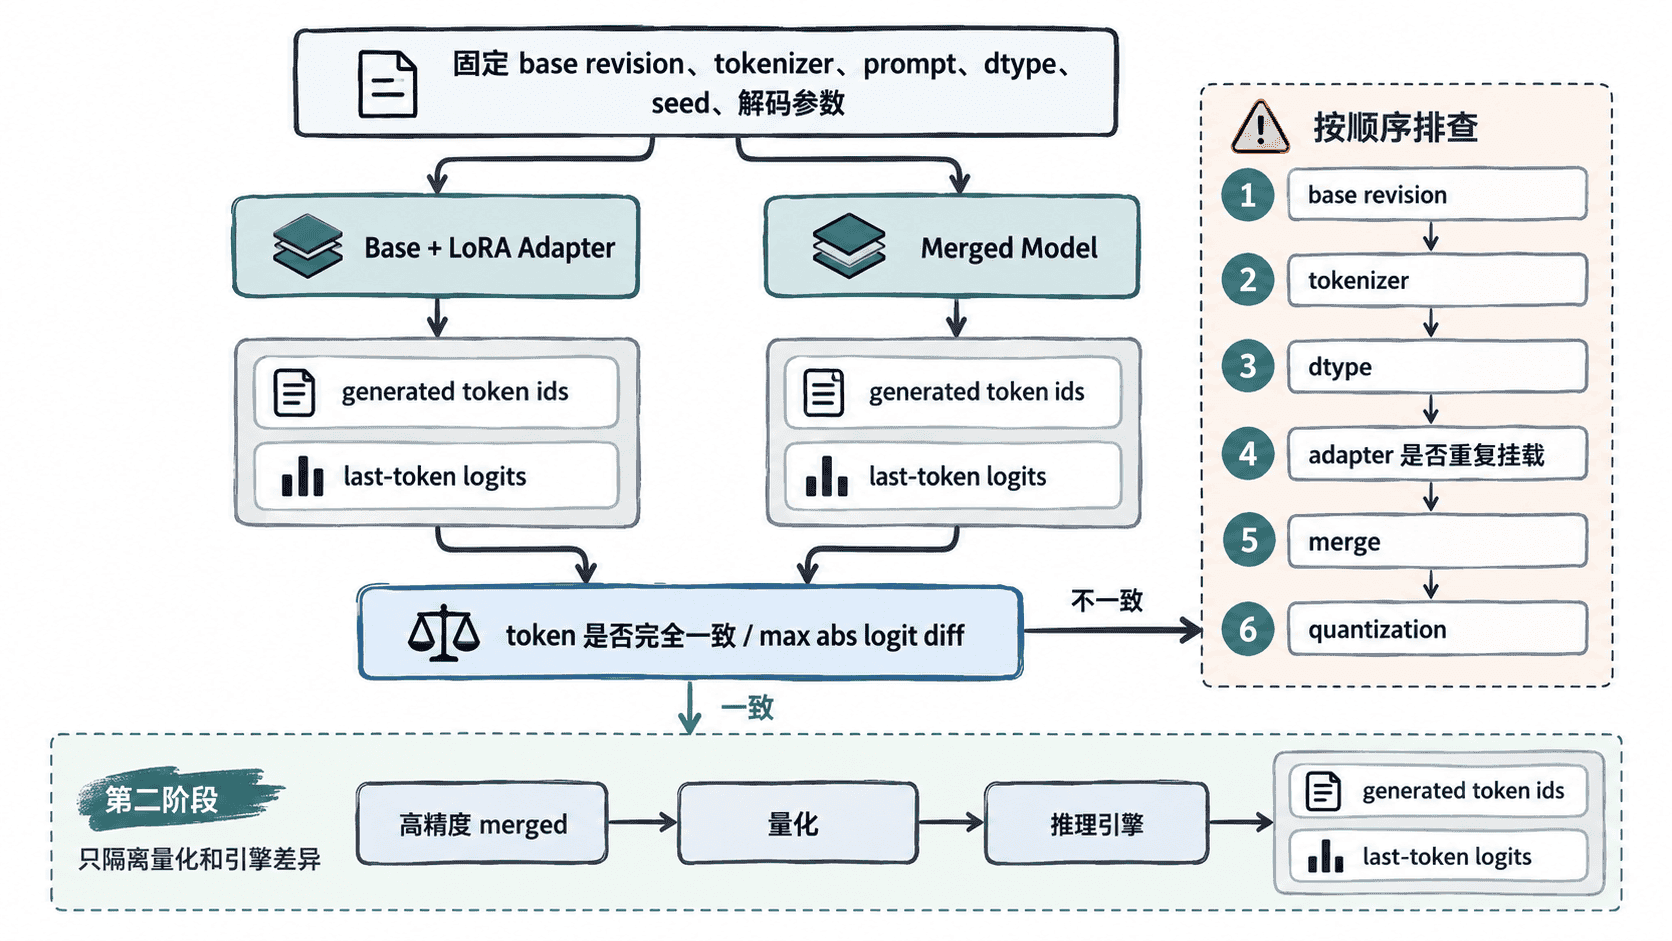
这一节把“看起来能加载”升级成可交付验证:在相同基座、tokenizer、dtype、随机种子和解码参数下,对比 adapter 模式与合并模型的 token 输出和 logits 差异,并用分阶段对照法判断偏差究竟来自权重合并、量化还是推理配置。
学习目标
- 建立可重复的合并前后 A/B 验证基线
- 同时比较生成 token 与数值评分,而不是只看一段文本是否相似
- 按 dtype、量化、基座版本和解码配置定位异常偏差
先把变量锁死
一致性测试最忌讳“一边换模型,一边换环境”。两条分支必须使用同一个基座 revision、同一 tokenizer、同一 prompt、同一 dtype 和同一套生成参数。首次验收建议使用 do_sample=False 的贪心解码,这样输出不依赖随机采样;仍然设置固定 seed,便于后续加入采样测试时保持基线。
如果生产模型还要量化,不要一步把“合并”和“量化”混在一起比较。先做 adapter 与同精度 merged 的对照,只验证 merge;再做 merged 高精度模型与最终量化模型的对照,只验证量化。这样一旦偏差出现,定位范围不会同时落在两个变量上。
运行同条件 A/B 验证
下面脚本先以 adapter 方式推理并保存最后一个位置的 logits,再执行 merge_and_unload()、保存并重新加载合并模型,最后比较生成 token 是否完全一致,以及 logits 的最大绝对差。运行前替换 <ID> 和 <PATH>;为了让测试有意义,两次加载必须使用相同精度。
from pathlib import Path
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
from peft import PeftModel

BASE_MODEL = "<ID>"
BASE_REVISION = "<ID>"
ADAPTER_DIR = "<PATH>"
MERGED_DIR = "<PATH>"
PROMPT = "用一句话解释 LoRA 的核心作用。"

if torch.cuda.is_available():
    DTYPE = torch.bfloat16 if torch.cuda.is_bf16_supported() else torch.float16
else:
    DTYPE = torch.float32

def load_base():
    kwargs = {"torch_dtype": DTYPE}
    if torch.cuda.is_available():
        kwargs["device_map"] = "auto"
    if not Path(BASE_MODEL).exists():
        kwargs["revision"] = BASE_REVISION
    return AutoModelForCausalLM.from_pretrained(BASE_MODEL, **kwargs)

def to_input_device(model, batch):
    device = model.get_input_embeddings().weight.device
    return {name: tensor.to(device) for name, tensor in batch.items()}

def main():
    set_seed(2026)
    tokenizer = AutoTokenizer.from_pretrained(
        BASE_MODEL,
        revision=None if Path(BASE_MODEL).exists() else BASE_REVISION,
    )
    batch = tokenizer(PROMPT, return_tensors="pt")
    generation = {"max_new_tokens": 32, "do_sample": False, "use_cache": True}

    base = load_base()
    adapter_model = PeftModel.from_pretrained(base, ADAPTER_DIR).eval()
    adapter_batch = to_input_device(adapter_model, batch)

    # 同时保留离散 token 与连续 logits,避免只比较表面文本。
    with torch.no_grad():
        adapter_logits = adapter_model(**adapter_batch).logits[:, -1, :].float().cpu()
        adapter_ids = adapter_model.generate(**adapter_batch, **generation).cpu()

    merged = adapter_model.merge_and_unload().eval()
    Path(MERGED_DIR).mkdir(parents=True, exist_ok=True)
    merged.save_pretrained(MERGED_DIR, safe_serialization=True)
    tokenizer.save_pretrained(MERGED_DIR)

    reload_kwargs = {"torch_dtype": DTYPE}
    if torch.cuda.is_available():
        reload_kwargs["device_map"] = "auto"
    reloaded = AutoModelForCausalLM.from_pretrained(
        MERGED_DIR,
        **reload_kwargs,
    ).eval()
    merged_batch = to_input_device(reloaded, batch)

    with torch.no_grad():
        merged_logits = reloaded(**merged_batch).logits[:, -1, :].float().cpu()
        merged_ids = reloaded.generate(**merged_batch, **generation).cpu()

    max_abs_diff = (adapter_logits - merged_logits).abs().max().item()
    print(f"token_ids_equal: {torch.equal(adapter_ids, merged_ids)}")
    print(f"max_abs_logit_diff: {max_abs_diff:.8f}")
    print("adapter_text:", tokenizer.decode(adapter_ids[0], skip_special_tokens=True))
    print("merged_text:", tokenizer.decode(merged_ids[0], skip_special_tokens=True))

if __name__ == "__main__":
    main()
预期输出
token_ids_equal: True
max_abs_logit_diff: <FLOAT>
adapter_text: <GENERATED_TEXT>
merged_text: <GENERATED_TEXT>
<FLOAT> 会随模型、算子实现和精度变化;这里不应伪造固定数值。同环境、同 dtype 的验证通常期待差异很小且贪心 token 完全一致,但最终阈值仍应由你的模型、硬件和推理栈校准,而不是照搬一个通用常数。
出现偏差时按顺序定位
先确认基座 revision。只要 adapter 挂载的基座与合并时使用的基座不是同一提交,后续比较就没有意义。接着确认 tokenizer 与 special token 配置,尤其是 pad、bos、eos 和 chat template 是否一致;这些差异会让“同一句 prompt”实际编码成不同 token 序列。
再检查 dtype。不要拿 bf16 的 adapter 路径去和 fp16 或 int4 的 merged 路径直接做数值阈值比较。若必须比较不同精度,先在同精度下证明 merge 正常,再把精度变化单独作为第二个实验变量。
随后检查 adapter 是否重复应用。常见错误是加载了已经合并的模型后,又在服务启动脚本里再次挂载同一个 LoRA;这会把增量效果叠加两次。另一个常见问题是直接在训练期的 4 bit 包装状态上执行合并,再把量化误差和 merge 误差混成一个问题。
最后检查生成配置。temperature、top_p、top_k、repetition_penalty、max_new_tokens、停止词和 chat template 任何一个不同,都可能让文本分叉。生产使用采样时,应固定多组 seed 分别运行,而不是要求一次随机生成逐 token 完全相同。
建立可交付的验收门槛
交付门槛至少包含两类信号:一类是离散行为,例如固定提示词下贪心 token 是否一致;另一类是连续数值,例如 logits 最大绝对差或任务评分差。若文本一致但数值漂移持续放大,说明模型可能处在“暂时没翻转 token,但数值已经变了”的边缘状态,仍值得追查。
只有在同精度 merge 验证通过之后,才进入量化和目标推理引擎验证。这样最终看到的偏差可以被明确归因到合并、量化或引擎三个阶段中的某一段,交付结论才可复现、可解释,也便于后续回归测试。