
大模型原理与训练 / 系统课时
选择合并或动态挂载适配器
选择合并或动态挂载适配器
这一节解决交付阶段最容易反复返工的选择:LoRA 到底保留为独立适配器,还是先合并进基座模型再发布。判断重点不是“哪种更先进”,而是启动方式、磁盘复制成本、多租户切换频率和推理引擎能力是否匹配,并把基座模型精确版本写进交付记录。
学习目标
- 根据服务形态判断独立 LoRA 与合并权重的适用边界
- 识别启动延迟、存储、多租户切换和引擎支持之间的取舍
- 生成可追溯的合并产物,并记录基座模型精确版本
两种交付形态的本质区别
独立 LoRA 的核心是“一个基座,多份小适配器”。基座权重只保存一次,租户或任务切换时挂载不同 adapter,磁盘和分发成本低;前提是推理引擎原生支持 LoRA、适配器热切换或至少支持稳定的启动时加载。
合并权重则把 LoRA 增量写回基座参数,得到一个普通模型目录。它更适合单模型单服务、下游引擎不理解 PEFT、或希望减少运行时装配步骤的场景。代价是每个适配器都会变成一份接近完整模型大小的产物,多个租户会迅速放大存储和镜像分发成本。
冷启动也不能只看“文件多少”。若基座已经常驻内存,动态挂载小适配器通常更快;若每个实例都是从零启动,合并模型省掉 adapter 装配步骤,但仍然必须加载完整基座权重。启动延迟必须按真实部署方式压测,而不是凭交付格式推断。
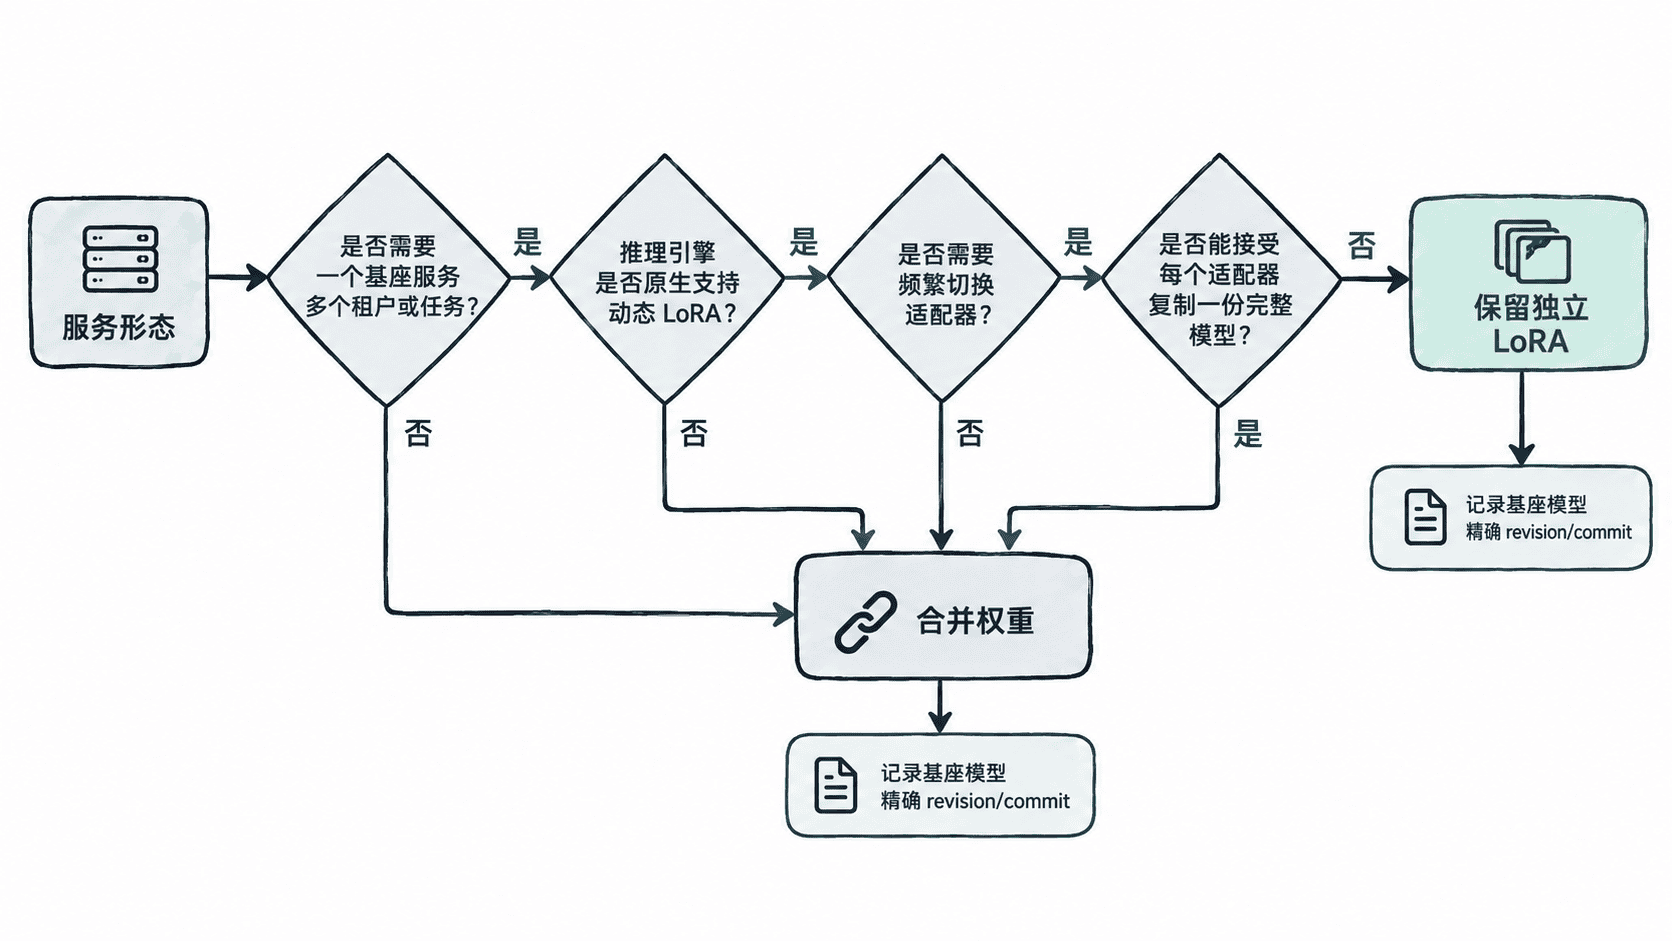
用约束快速做决定
优先保留独立 LoRA 的情况是:一个基座需要服务多个任务;适配器会经常新增、回滚或切换;推理引擎已经验证支持 LoRA;希望 adapter 作为独立版本单元发布。此时交付包至少要记录基座模型标识、精确 revision、adapter 版本和兼容的 tokenizer。
优先合并的情况是:生产只运行一个最终模型;下游引擎不支持 PEFT;需要把产物交给不了解 LoRA 的团队;或希望启动链路只处理标准 Transformers 权重。对 QLoRA 产物不要直接假设“4 bit 训练包装器可以原样合并并交付”,更稳妥的流程通常是用兼容精度重新加载基座、合并 LoRA,再按目标推理栈重新量化并验证。
生成可追溯的合并产物
下面脚本演示用明确的基座 revision 加载模型、合并 adapter,并在输出目录写入交付清单。运行前把 <ID> 与 <PATH> 替换成真实值;若基座来自 Hugging Face Hub,BASE_REVISION 应填写不可变 commit SHA,而不是分支名。
from pathlib import Path
import json
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
from peft import PeftConfig, PeftModel

BASE_MODEL = "<ID>"
BASE_REVISION = "<ID>"
ADAPTER_DIR = "<PATH>"
OUTPUT_DIR = "<PATH>"

def main():
    output = Path(OUTPUT_DIR)
    output.mkdir(parents=True, exist_ok=True)

    # 远程模型固定 revision;本地目录不再额外解析 revision。
    is_local_base = Path(BASE_MODEL).exists()
    dtype = torch.float16 if torch.cuda.is_available() else torch.float32
    load_kwargs = {"torch_dtype": dtype}
    if torch.cuda.is_available():
        load_kwargs["device_map"] = "auto"
    if not is_local_base:
        load_kwargs["revision"] = BASE_REVISION

    peft_config = PeftConfig.from_pretrained(ADAPTER_DIR)
    base = AutoModelForCausalLM.from_pretrained(BASE_MODEL, **load_kwargs)
    model = PeftModel.from_pretrained(base, ADAPTER_DIR)

    # merge_and_unload() 把 LoRA 增量写回基座,并移除运行时 adapter 层。
    merged = model.merge_and_unload()
    merged.save_pretrained(output, safe_serialization=True)

    tokenizer = AutoTokenizer.from_pretrained(
        BASE_MODEL,
        revision=None if is_local_base else BASE_REVISION,
    )
    tokenizer.save_pretrained(output)

    manifest = {
        "base_model": BASE_MODEL,
        "base_revision": BASE_REVISION,
        "adapter_source": ADAPTER_DIR,
        "adapter_declared_base": peft_config.base_model_name_or_path,
        "merge_dtype": str(next(merged.parameters()).dtype),
    }
    (output / "delivery_manifest.json").write_text(
        json.dumps(manifest, ensure_ascii=False, indent=2),
        encoding="utf-8",
    )

    print(f"adapter declares base: {peft_config.base_model_name_or_path}")
    print(f"merged model saved: {output}")
    print(f"manifest saved: {output / 'delivery_manifest.json'}")

if __name__ == "__main__":
    main()
预期输出
adapter declares base: <ID>
merged model saved: <PATH>
manifest saved: <PATH>/delivery_manifest.json
实际模型标识和路径会随环境变化。合并完成后还不能直接宣告可交付,至少要检查输出目录包含模型权重、配置、tokenizer 文件和 delivery_manifest.json,并在目标推理引擎中完成一次加载验证。
交付时保留的最小证据
如果采用动态挂载,发布单元应把“基座”和“adapter”分开版本化,并记录它们的绑定关系;如果采用合并模型,发布单元应保留合并时使用的 adapter 来源与基座 revision。这样既能回答“这个模型由什么生成”,也能在出现回归时重新构造同一份产物。
真正的选择标准可以压缩成一句话:需要共享基座和快速切换时保留独立 LoRA,需要最简单的单模型运行时兼容性时合并;两条路径都必须把基座精确版本当成交付物的一部分。