
大模型原理与训练 / 系统课时
用 Accelerate 管理多卡启动
用 Accelerate 管理多卡启动
把单卡脚本扩到多卡时,真正容易出错的是进程数、设备绑定和数据是否被正确切分。本篇用 Hugging Face Accelerate 统一这些启动细节,让同一份训练脚本既能单卡运行,也能用多进程驱动多张 GPU,并用样本编号验证分片结果。
学习目标
- 用
accelerate config保存多卡运行环境,并理解进程数与设备数的关系 - 用
Accelerator.prepare()让模型、优化器和 DataLoader 进入分布式执行 - 通过每个 rank 实际看到的样本编号检查数据是否被正确分片
先把训练脚本交给 Accelerator 管理
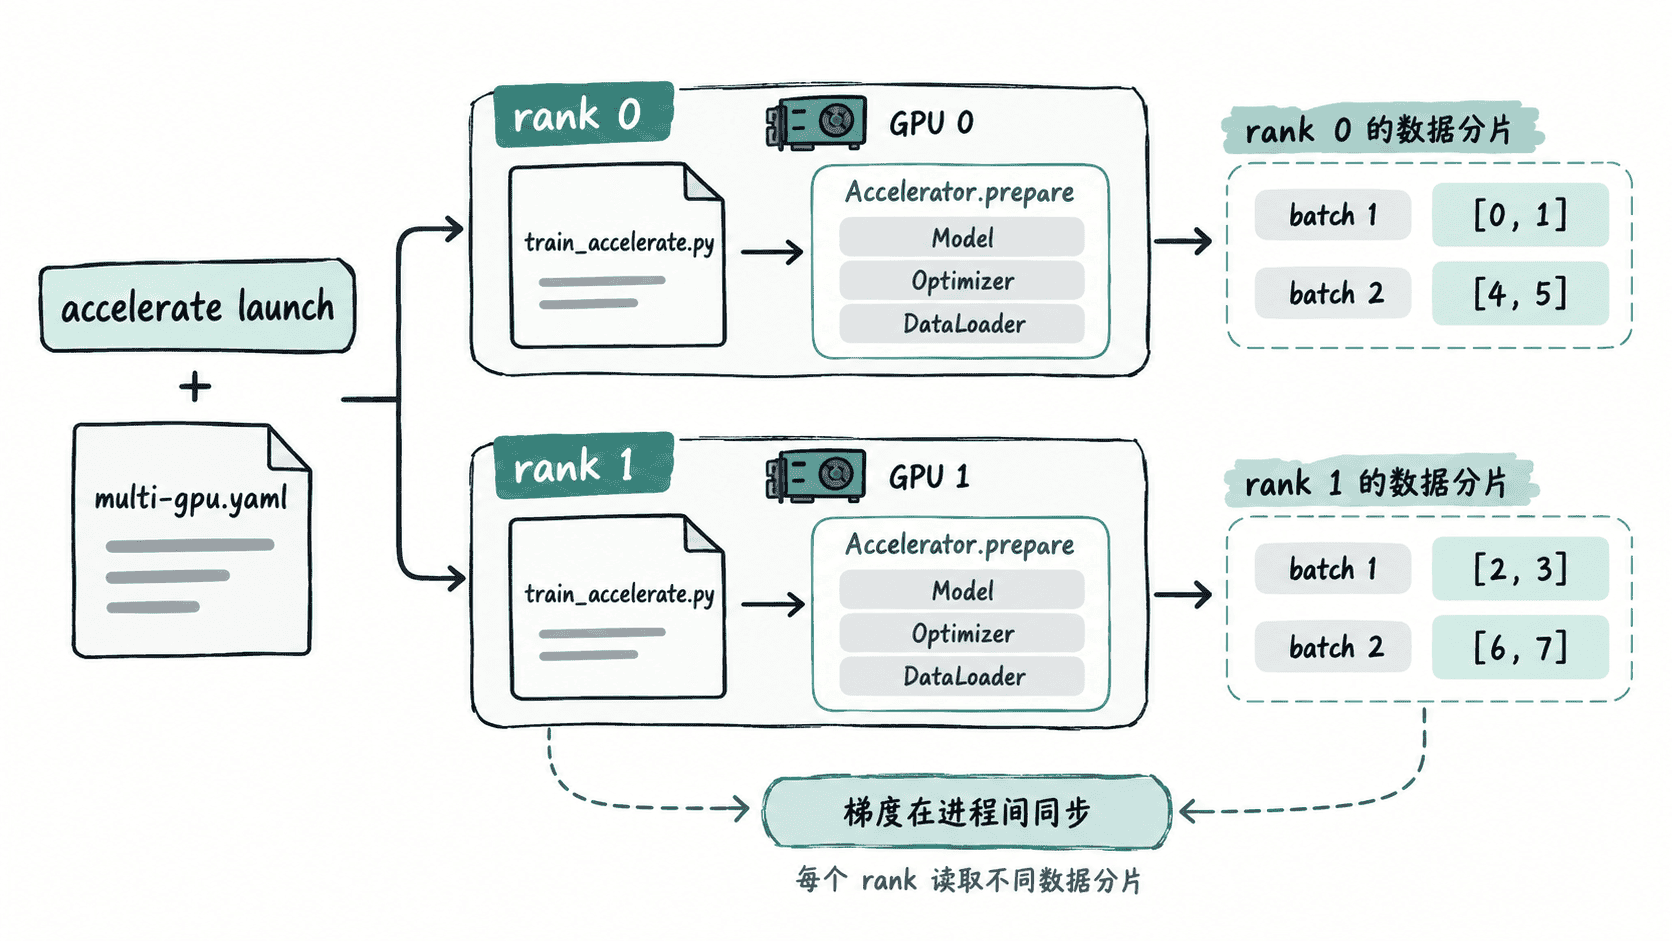
Accelerate 的关键不是重写训练逻辑,而是在原脚本中创建 Accelerator,再把模型、优化器和 DataLoader 交给 prepare()。启动时 accelerate launch 负责创建分布式进程,脚本内部通过 process_index、num_processes 和主进程判断获取当前 rank 信息。([Hugging Face][4])
下面的脚本只训练一个线性层,但保留了多卡训练最重要的结构,并记录每个进程实际处理过的样本编号。
import torch
from accelerate import Accelerator
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

def main():
    torch.manual_seed(0)
    accelerator = Accelerator()

    x = torch.arange(8, dtype=torch.float32).view(-1, 1)
    y = 2 * x + 1
    loader = DataLoader(
        TensorDataset(x, y),
        batch_size=2,
        shuffle=False,
    )

    model = nn.Linear(1, 1)
    optimizer = torch.optim.SGD(model.parameters(), lr=0.01)

    # prepare 会根据当前分布式环境包装模型,并切分 DataLoader。
    model, optimizer, loader = accelerator.prepare(
        model, optimizer, loader
    )

    seen = []
    for batch_x, batch_y in loader:
        seen.extend(int(v) for v in batch_x.squeeze(1).cpu().tolist())

        optimizer.zero_grad()
        prediction = model(batch_x)
        loss = nn.functional.mse_loss(prediction, batch_y)
        accelerator.backward(loss)
        optimizer.step()

    print(
        f"rank={accelerator.process_index} "
        f"world={accelerator.num_processes} seen={seen}",
        flush=True,
    )

    accelerator.wait_for_everyone()
    if accelerator.is_main_process:
        print("training finished", flush=True)

if __name__ == "__main__":
    main()
预期结果
脚本可由 Accelerate launcher 启动;多进程时各 rank 训练不同数据批次,并输出自己实际处理的样本编号。两个 rank 合起来应覆盖全部 8 个样本,终端中两条 rank 日志的先后顺序可能互换。
用 config 固化设备与精度选择
先在目标机器上生成配置文件。accelerate config 会通过交互式问题记录本机运行方式,配置可保存到指定路径;之后 accelerate launch 可以复用该文件,而不必每次重新拼接分布式参数。官方 CLI 也提供 accelerate env 用于检查当前配置。([Hugging Face][5])
accelerate config --config_file <PATH>/multi-gpu.yaml预期结果
完成交互式配置后,在 <PATH>/multi-gpu.yaml 生成 Accelerate 配置文件。对于两张 GPU 的单机实验,交互配置中应让运行类型为多 GPU、进程数为 2,混合精度则按硬件支持选择 bf16、fp16 或 no。<PATH> 是实际保存目录,运行时替换为本机路径。
用 launcher 启动并核对每个 rank
配置完成后,同一份脚本不需要写 torch.multiprocessing 或手工读取 LOCAL_RANK。直接指定配置文件启动即可。Accelerate 的 launcher 会按配置创建相应数量的进程。([Hugging Face][4])
accelerate launch --config_file <PATH>/multi-gpu.yaml train_accelerate.py预期输出
rank=0 world=2 seen=[0, 1, 4, 5]
rank=1 world=2 seen=[2, 3, 6, 7]
training finished
如果出现两个 rank 都读取完整的 [0, 1, 2, 3, 4, 5, 6, 7],首先检查 DataLoader 是否真的传入 accelerator.prepare();如果 world 仍然是 1,则检查配置中的 num_processes、可见 GPU 数量以及启动时是否使用了预期的配置文件。
从单卡切到多卡时只改运行环境
理想的 Accelerate 脚本不应该把“第几张 GPU”硬编码进训练循环。设备放置、分布式模型包装和 DataLoader 切分都交给 Accelerate 后,训练主体仍然保持一次前向、一次反向和一次优化器更新。这样从单卡切到多卡时,主要变化落在配置文件和 launcher,而不是业务训练代码。
还要区分数据分片正确和全局 batch 大小不变。如果单卡时 batch size 为 2,改成两个进程后仍让每个进程各取 2 个样本,那么一次并行计算覆盖的全局 batch 就变成 4。需要保持原有优化语义时,应重新核对每设备 batch、进程数和梯度累积步数,而不是只确认程序能在两张卡上跑起来。