
大模型原理与训练 / 系统课时
跑通监督微调基线任务
跑通监督微调基线任务
正式比较 LoRA、QLoRA 和全参数训练前,先用极小数据与少量训练步数跑通监督微调全链路。本篇用一个轻量 Causal LM 示例完成数据加载、前向与反向、模型保存和推理验证,并记录 loss、速度与峰值显存,作为后续实验的共同基线。
学习目标
- 能用小数据和少量步数验证监督微调训练链路是否完整
- 能保存模型并用同一检查点完成一次推理验证
- 能记录 loss、训练速度和峰值显存作为后续方法对比基线
基线先验证什么
基线任务的目标不是追求效果,而是尽快证明整条链路能工作。最小闭环应覆盖数据能被 tokenizer 读取、模型能够前向计算 loss、反向传播能够更新参数、检查点能够写盘,以及保存后的模型能够完成一次生成。
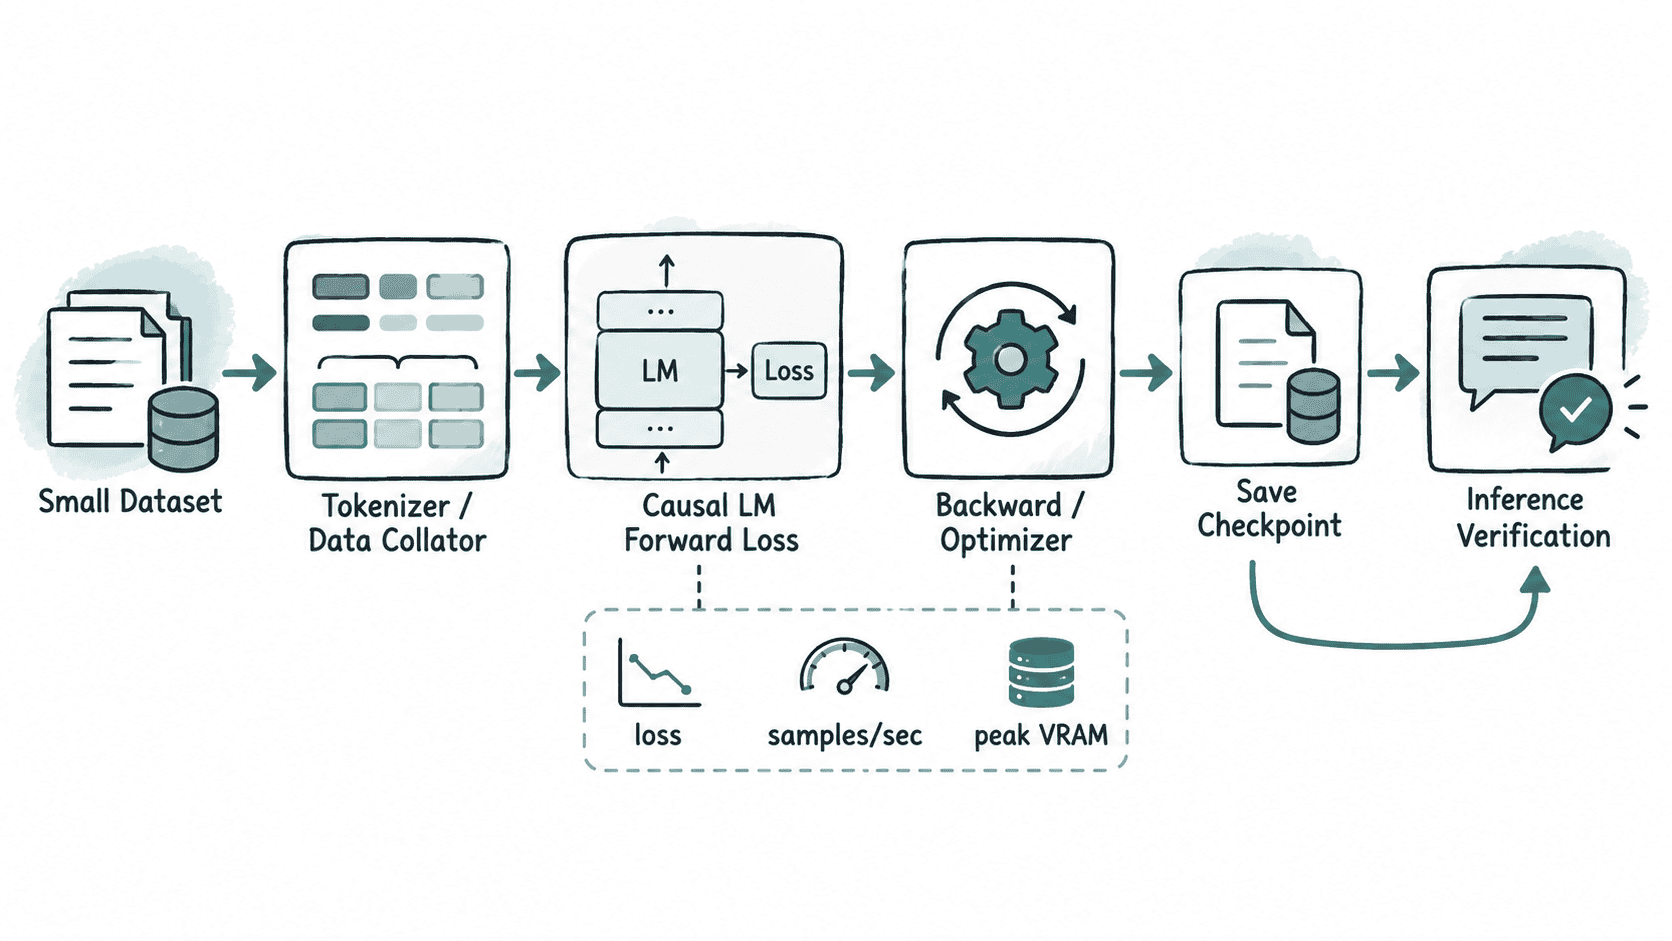
先用足够小的模型和数据排除工程问题,再扩大数据、序列长度和训练步数。若一开始就上真实大模型,显存不足、数据格式错误和保存路径问题会混在一起,定位成本很高。
跑通最小可运行任务
下面示例依赖已安装的 torch、transformers、datasets 和 accelerate。它使用一个轻量公开模型和四条样本训练 5 步,随后保存模型并立即做一次生成。首次运行需要能够下载模型,或将 MODEL_ID 改成本地模型目录。
from pathlib import Path

import torch
from datasets import Dataset
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    DataCollatorForLanguageModeling,
    Trainer,
    TrainingArguments,
)

MODEL_ID = "sshleifer/tiny-gpt2"
OUTPUT_DIR = Path("./sft-baseline")

samples = [
    {"instruction": "Say hello.", "answer": "Hello!"},
    {"instruction": "Name a primary color.", "answer": "Red."},
    {"instruction": "What is 2 + 2?", "answer": "4"},
    {"instruction": "Opposite of hot?", "answer": "Cold."},
]

dataset = Dataset.from_list(samples)
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

def tokenize(batch):
    texts = [
        f"Instruction: {q}\nResponse: {a}"
        for q, a in zip(batch["instruction"], batch["answer"])
    ]
    return tokenizer(texts, truncation=True, max_length=128)

tokenized = dataset.map(
    tokenize,
    batched=True,
    remove_columns=dataset.column_names,
)
collator = DataCollatorForLanguageModeling(tokenizer=tokenizer, mlm=False)
model = AutoModelForCausalLM.from_pretrained(MODEL_ID)

# 训练前先测一次 loss,作为三种微调方法共享的起点。
probe = collator([tokenized[0], tokenized[1]])
with torch.no_grad():
    initial_loss = model(**probe).loss.item()

args = TrainingArguments(
    output_dir=str(OUTPUT_DIR),
    max_steps=5,
    per_device_train_batch_size=2,
    logging_steps=1,
    save_steps=5,
    report_to=[],
)

if torch.cuda.is_available():
    torch.cuda.reset_peak_memory_stats()

trainer = Trainer(
    model=model,
    args=args,
    train_dataset=tokenized,
    data_collator=collator,
)
result = trainer.train()
trainer.save_model()
tokenizer.save_pretrained(OUTPUT_DIR)

prompt = "Instruction: Say hello.\nResponse:"
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
model.eval()
with torch.no_grad():
    output = model.generate(
        **inputs,
        max_new_tokens=12,
        do_sample=False,
        pad_token_id=tokenizer.eos_token_id,
    )

generated_new_tokens = output.shape[1] - inputs["input_ids"].shape[1]
peak_vram_mib = (
    torch.cuda.max_memory_allocated() / 1024 / 1024
    if torch.cuda.is_available()
    else 0.0
)

print(f"initial_loss={initial_loss:.4f}")
print(f"train_loss={result.metrics['train_loss']:.4f}")
print(
    "train_samples_per_second="
    f"{result.metrics.get('train_samples_per_second', 0.0):.2f}"
)
print(f"peak_vram_mib={peak_vram_mib:.0f}")
print(f"saved_to={OUTPUT_DIR}")
print(f"generated_new_tokens={generated_new_tokens}")
print(f"inference_ok={generated_new_tokens > 0}")
预期输出的数值会因硬件、软件版本和随机初始化而变化,形态应类似:
initial_loss=<INITIAL_LOSS>
train_loss=<TRAIN_LOSS>
train_samples_per_second=<SAMPLES_PER_SECOND>
peak_vram_mib=<PEAK_VRAM_MIB>
saved_to=sft-baseline
generated_new_tokens=<GENERATED_TOKENS>
inference_ok=True
这里最重要的不是 <INITIAL_LOSS> 或 <TRAIN_LOSS> 是否足够低,而是训练能结束、指标能产生、目录能保存、推理路径能复用同一模型。CPU 环境下 <PEAK_VRAM_MIB> 为 0,GPU 环境则记录本次进程实际观察到的峰值显存。
记录共同基线
每次后续实验都应沿用同一数据版本、样本格式、最大序列长度和评测提示词,然后只改变微调策略。至少记录初始 loss、最终 loss、训练样本吞吐、峰值显存、总训练步数和保存模型大小,这些指标才能说明 LoRA、QLoRA 与全参数训练的资源差异来自方法本身,而不是实验条件变化。
验收失败时按链路定位
如果 loss 无法产生,先检查 tokenizer 输出和 labels 是否正确;如果反向阶段报显存不足,先缩短 max_length、减小 batch size 或换更小模型;如果训练完成但无法保存,检查输出目录权限和磁盘空间;如果保存成功但推理失败,则优先验证 tokenizer 与模型是否从同一目录加载。
当这条小基线能够稳定重复运行并留下完整指标后,再把训练方式替换成 LoRA、QLoRA 或全参数更新。这样三种方法共享同一条数据与验证链路,后续任何性能差异都更容易归因和复现。