
大模型原理与训练 / 系统课时
用梯度检查点降低显存
用梯度检查点降低显存
全参数微调时,激活值常随层数、批大小和序列长度迅速占满显存。本节用梯度检查点把部分激活改为反向阶段重算,并通过可重复实验比较显存与耗时,再给出与缩短序列、减小批大小之间的选择顺序。
学习目标
- 解释梯度检查点为何能降低激活显存,以及它不会减少哪些显存占用
- 用同一模型测量开启前后的峰值显存与单步耗时
- 在显存不足时判断应优先开启检查点、减小批大小还是缩短序列长度
显存为什么会下降
常规反向传播需要保留前向阶段的中间激活,反向时再用这些激活计算梯度。层数越深、序列越长、批越大,需要同时保存的激活越多。梯度检查点只保存少量边界激活,反向经过某个区段时重新执行该区段的前向计算,因此用额外计算换显存。
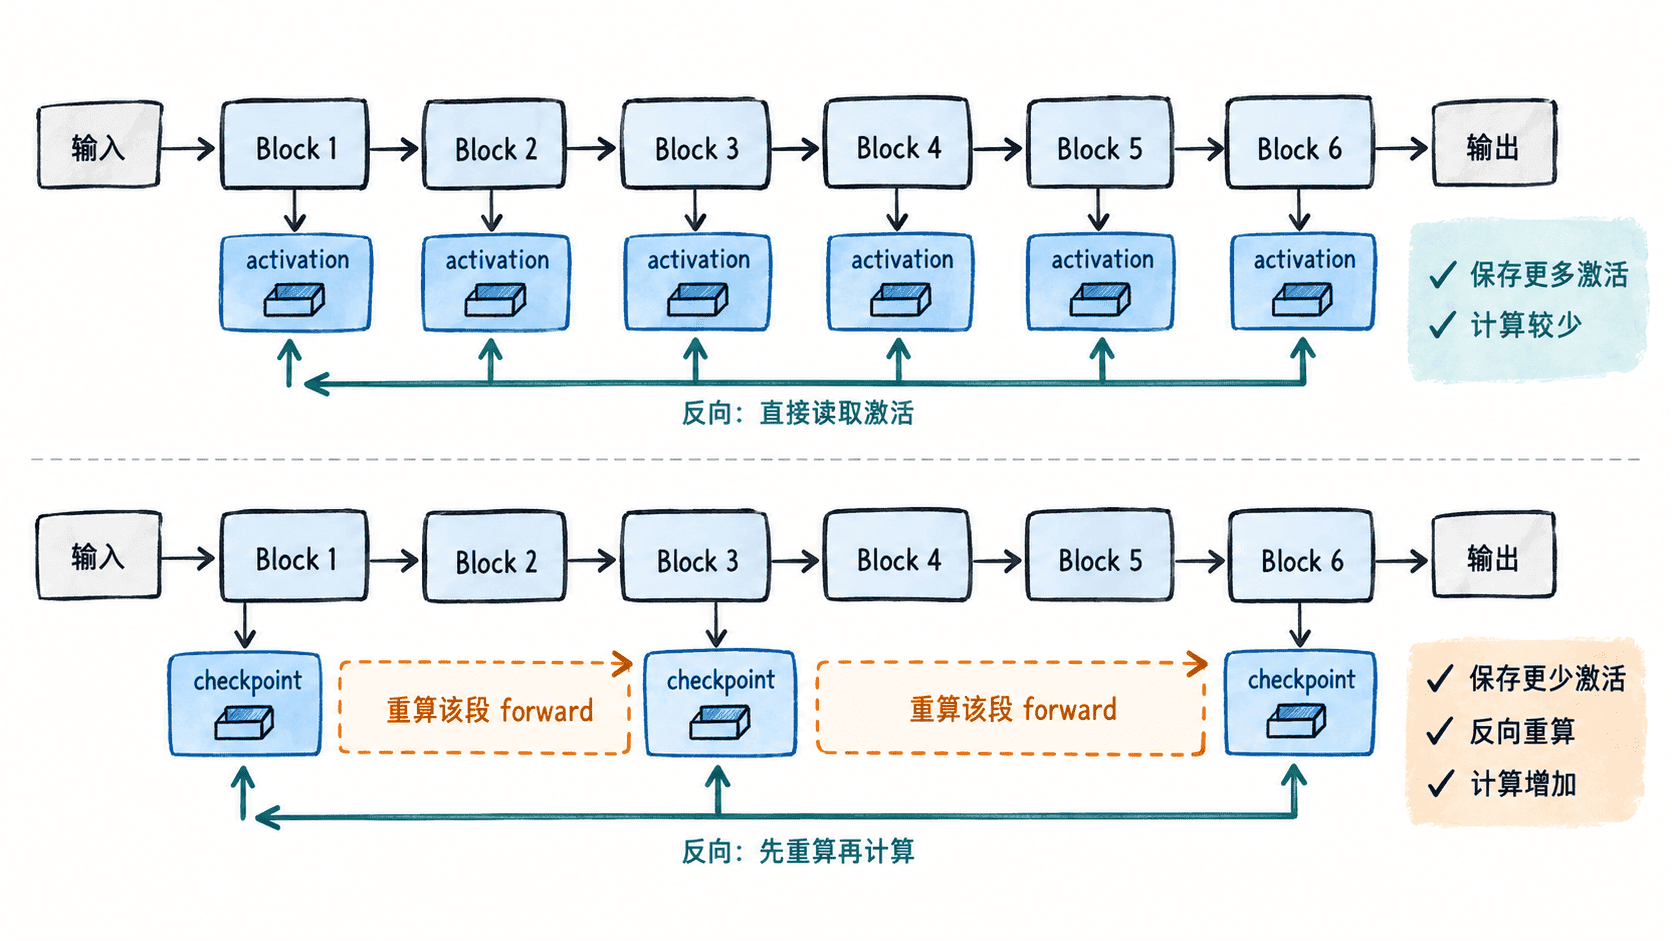
它主要压缩的是激活显存,不会让参数、梯度或 AdamW 的一阶与二阶动量消失。因此如果显存大头来自模型权重、梯度和优化器状态,收益会小于激活占主导的长序列训练。
用可重复实验测交换关系
下面的脚本在同一张 CUDA GPU 上,对完全相同的网络、批大小和序列长度各执行一次前向加反向。torch.utils.checkpoint.checkpoint 使用 use_reentrant=False,只改变激活保存策略,不改变模型参数量。
import time

import torch
from torch import nn
from torch.utils.checkpoint import checkpoint

class Block(nn.Module):
    def __init__(self, hidden: int):
        super().__init__()
        self.norm = nn.LayerNorm(hidden)
        self.ffn = nn.Sequential(
            nn.Linear(hidden, hidden * 4),
            nn.GELU(),
            nn.Linear(hidden * 4, hidden),
        )

    def forward(self, x):
        return x + self.ffn(self.norm(x))

class ToyModel(nn.Module):
    def __init__(self, hidden=512, layers=8):
        super().__init__()
        self.blocks = nn.ModuleList([Block(hidden) for _ in range(layers)])

    def forward(self, x, use_checkpoint: bool):
        for block in self.blocks:
            # 检查点模式只保留边界信息,反向时重算 block.forward。
            x = checkpoint(block, x, use_reentrant=False) if use_checkpoint else block(x)
        return x.square().mean()

def run_once(model, x, use_checkpoint: bool):
    model.zero_grad(set_to_none=True)
    torch.cuda.empty_cache()
    torch.cuda.reset_peak_memory_stats()
    torch.cuda.synchronize()

    started = time.perf_counter()
    loss = model(x, use_checkpoint)
    loss.backward()
    torch.cuda.synchronize()

    elapsed = time.perf_counter() - started
    peak_mib = torch.cuda.max_memory_allocated() / 1024**2
    return peak_mib, elapsed

if not torch.cuda.is_available():
    raise SystemExit("This example requires a CUDA GPU.")

torch.manual_seed(7)
device = torch.device("cuda")
model = ToyModel().to(device)
x = torch.randn(2, 2048, 512, device=device)

baseline = run_once(model, x, use_checkpoint=False)
checked = run_once(model, x, use_checkpoint=True)

# 比较峰值 allocated memory,而不是会受缓存池影响的 reserved memory。
reduction = (1 - checked[0] / baseline[0]) * 100
slowdown = checked[1] / baseline[1]

print(f"without_checkpoint: peak={baseline[0]:.1f} MiB, step={baseline[1]:.3f} s")
print(f"with_checkpoint:    peak={checked[0]:.1f} MiB, step={checked[1]:.3f} s")
print(f"memory_reduction={reduction:.1f}%, slowdown={slowdown:.2f}x")
预期输出:
without_checkpoint: peak=<BASELINE_MIB> MiB, step=<BASELINE_SECONDS> s
with_checkpoint:    peak=<CHECKPOINT_MIB> MiB, step=<CHECKPOINT_SECONDS> s
memory_reduction=<PERCENT>%, slowdown=<RATIO>x
具体数值会随 GPU、PyTorch 版本和内核实现变化;判断是否值得开启,应看自己的峰值显存下降是否换来了可接受的单步变慢,而不是照搬某个固定百分比。
在 Transformers 训练里开启
对支持梯度检查点的 Transformers 模型,核心开关通常是 model.gradient_checkpointing_enable();使用 Trainer 时也可以在训练参数中开启 gradient_checkpointing。Decoder-only 模型若训练时启用了 KV Cache,还应关闭训练阶段的 use_cache,因为缓存面向自回归推理,与检查点重算目标冲突。
# 片段示例:假设 model 已通过 AutoModelForCausalLM.from_pretrained(...) 加载。
model.gradient_checkpointing_enable()

if hasattr(model.config, "use_cache"):
    model.config.use_cache = False
生效验证不应只看配置值,而应在固定 batch、固定序列长度下比较 torch.cuda.max_memory_allocated() 和每步训练时间;如果峰值显存几乎不变,先确认模型实现是否真的支持检查点,再判断显存瓶颈是否其实在参数或优化器状态。
先减什么更合适
| 手段 | 最适合解决的问题 | 主要代价 |
|---|---|---|
| 梯度检查点 | 想保持 batch 和上下文长度,但激活显存过高 | 反向阶段增加重算,训练变慢 |
| 减小 micro-batch | 单步显存超限,但不想截断单条样本上下文 | 吞吐下降,可用梯度累积恢复有效 batch |
| 缩短序列长度 | 长上下文直接推高激活与注意力开销 | 丢失上下文,可能改变任务本身 |
如果 OOM 只差少量显存且必须保留长上下文,优先开启梯度检查点通常最稳妥;如果仍超限,再减小 micro-batch。只有数据本身不依赖长上下文,或注意力计算已经成为主要瓶颈时,才优先缩短序列长度。