
大模型原理与训练 / 系统课时
对比三种微调成本质量
对比三种微调成本质量
LoRA、QLoRA 和全参数训练不能只比较验证分数,也不能只看显存。本节把显存峰值、训练时长、可训练参数、验证指标和人工偏好放进同一套成本—质量框架,先淘汰不满足验收条件的方案,再从剩余方案中选择总代价可接受的模型。
学习目标
- 统一三种微调方案的测量口径与验收门槛
- 将显存、时长和质量指标转换为可比较的成本—质量矩阵
- 用硬门槛、帕累托关系和切片回归做最终选择
先统一比较口径
三种方案只有在相同任务条件下才值得横向比较。应固定基础模型、训练/验证划分、最大序列长度、评测提示词和生成参数,并记录 GPU 型号、卡数、精度、有效批大小与随机种子。若某方案因显存限制必须调整微批大小,也要保留实际配置,不能只比较最终分数。
建议先保留原始测量值,不急着合成为一个分数。
| 方案 | 显存峰值 | 训练时长 | 可训练参数 | 验证指标 | 人工偏好 | 备注 |
|---|---|---|---|---|---|---|
| LoRA | 实测 | 实测 | 适配器参数量 | 实测 | 实测 | 记录 rank、精度等配置 |
| QLoRA | 实测 | 实测 | 适配器参数量 | 实测 | 实测 | 同时记录量化位宽 |
| 全参数训练 | 实测 | 实测 | 全部参数 | 实测 | 实测 | 记录优化器与并行策略 |
先过硬门槛,再谈综合最优
验收条件应先于加权评分。例如部署环境只有固定显存预算,就先淘汰显存峰值超限的方案;业务要求某验证指标不得低于基线,也应先作为质量门槛。安全切片、关键领域回归和训练时间窗口同样可以作为硬条件。
通过硬门槛后,再构造两个方向一致的指标。设归一化后的显存成本为 、训练时长成本为 、验证质量为 、人工偏好为 ,可以定义:
其中各组权重分别求和为 1。权重不是固定答案:显存预算紧时提高 ,迭代速度重要时提高 ;验证指标和人工偏好也应按真实验收目标分配权重。无论是否使用综合分,都应保留原始值供复核。
用脚本生成可比较结果
下面的 Python 示例使用演示数据计算归一化成本、归一化质量和硬门槛结果。数字只用于演示计算方式,不代表三种微调方法的通用性能结论;实际使用时应替换为同一实验条件下的测量值。
runs = {
    "LoRA":  {"vram": 18.2, "hours": 2.8, "val": 0.742, "human": 0.56},
    "QLoRA": {"vram": 11.4, "hours": 3.1, "val": 0.738, "human": 0.55},
    "Full":  {"vram": 41.8, "hours": 7.6, "val": 0.751, "human": 0.58},
}

def normalize(values):
    low, high = min(values), max(values)
    return [(x - low) / (high - low) if high > low else 0.0 for x in values]

names = list(runs)
vram_n = normalize([runs[n]["vram"] for n in names])
hours_n = normalize([runs[n]["hours"] for n in names])
val_n = normalize([runs[n]["val"] for n in names])
human_n = normalize([runs[n]["human"] for n in names])

for i, name in enumerate(names):
    # 成本越低越好,质量越高越好;权重应按实际约束调整。
    cost = 0.6 * vram_n[i] + 0.4 * hours_n[i]
    quality = 0.5 * val_n[i] + 0.5 * human_n[i]
    accepted = (
        runs[name]["vram"] <= 24
        and runs[name]["val"] >= 0.735
        and runs[name]["human"] >= 0.54
    )
    print(f"{name:5s} cost={cost:.3f} quality={quality:.3f} accepted={accepted}")
预期输出
LoRA  cost=0.134 quality=0.321 accepted=True
QLoRA cost=0.025 quality=0.000 accepted=True
Full  cost=1.000 quality=1.000 accepted=False
这里全参数训练虽然演示数据中的质量最高,却因显存门槛被淘汰;QLoRA 的成本最低,但质量也最低。这个例子说明“综合最优”必须先服从硬约束,不能用高质量分抵消不可部署的成本。
建立成本—质量矩阵
把通过门槛的方案画在二维矩阵中最容易判断取舍:横轴放成本指数 ,越向左越便宜;纵轴放质量指数 ,越向上越好。还可以用点大小表示可训练参数比例,但不要再叠加太多维度,否则图会失去解释力。
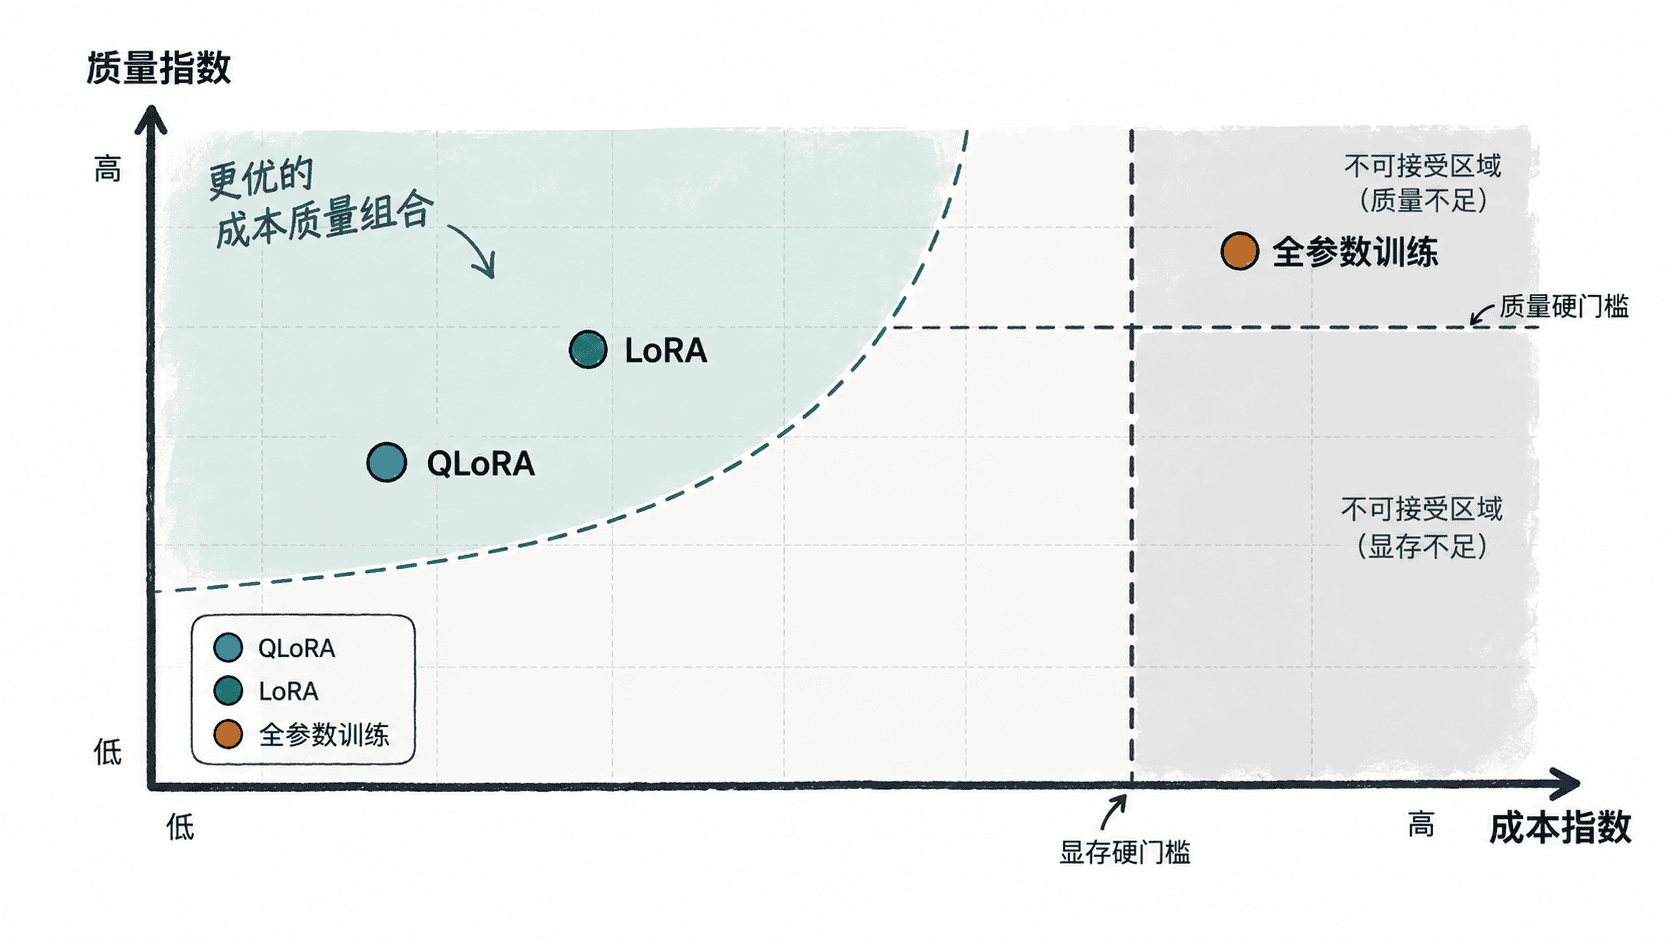
如果一个方案在成本不更高的同时质量不更低,并且至少一项更好,它就支配另一个方案。被支配的点通常没有继续保留的必要;剩下的非支配方案构成帕累托前沿,再根据显存预算、训练窗口和质量要求做选择。
用回归切片完成最终验收
矩阵只负责宏观取舍,最终上线前仍要回到人工偏好与错误切片。某方案即使整体质量指数更高,只要在安全、关键领域或高价值任务上出现不可接受回归,就不能直接进入发布。
实际决策可以按固定顺序执行:先淘汰不满足硬门槛的方案,再删除明显被支配的方案,随后检查关键切片回归,最后在剩余候选中选择满足质量目标且总成本最低的方案。若两个方案差异接近测量噪声,应优先补充重复实验或人工评测,而不是依据小数点后的微小差距做结论。
这样得到的选择不是“哪种微调技术理论上最好”,而是“在当前数据、硬件、验收标准和风险约束下,哪种方案最值得部署”。