
大模型原理与训练 / 系统课时
用 Chat Template 整理对话
用 Chat Template 整理对话
对话微调的关键不是把 role 和文本简单拼接,而是让训练样本严格复用目标模型的聊天协议。本节把结构化消息渲染成训练文本,并逐项检查特殊 token、assistant 起始位置和结尾标记。
学习目标
- 使用 tokenizer 自带的 Chat Template 渲染训练样本。
- 区分训练格式与推理格式中的
add_generation_prompt。 - 检查 assistant 内容位置、结尾标记和特殊 token 是否重复。
训练文本为什么不能手拼
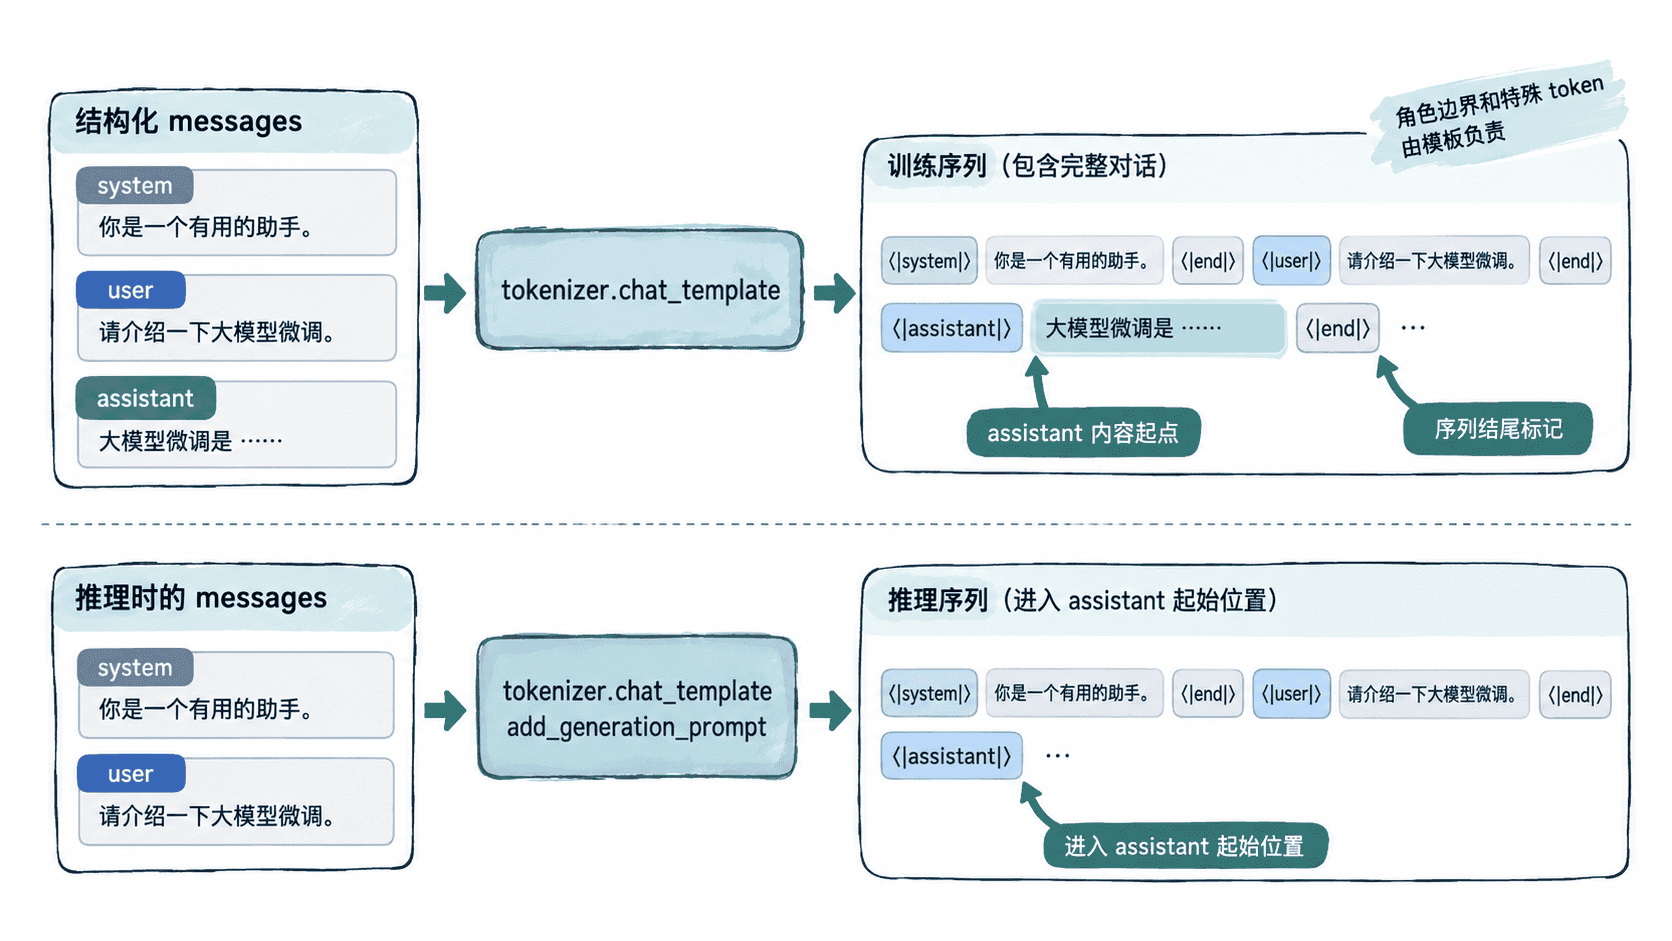
不同指令模型对 system、user、assistant 的角色标记、换行和结束符约定并不相同。手写角色前缀即使肉眼可读,也可能与模型原本的聊天协议不一致,让模型把角色边界当成普通文本学习。
训练数据应保留结构化消息,再交给当前模型 tokenizer 的 chat_template。这样更换基础模型时,格式差异由 tokenizer 负责,而不是散落在数据清洗代码里。
用 tokenizer 渲染训练格式
下面用同一个 tokenizer 同时生成训练文本和推理前缀。训练样本已经包含 assistant 答案,因此使用 add_generation_prompt=False;推理时只有待回答的上下文,才使用 add_generation_prompt=True 让模板补出 assistant 起始位置。
from transformers import AutoTokenizer

MODEL_ID = 'Qwen/Qwen2.5-0.5B-Instruct'
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)

messages = [
    {'role': 'system', 'content': '你是一个回答简洁的技术助手。'},
    {'role': 'user', 'content': '用一句话解释 LoRA。'},
    {
        'role': 'assistant',
        'content': 'LoRA 通过训练低秩增量矩阵来减少需要更新的参数量。',
    },
]

train_text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=False,
)
inference_prefix = tokenizer.apply_chat_template(
    messages[:-1],
    tokenize=False,
    add_generation_prompt=True,
)
train_ids = tokenizer.apply_chat_template(
    messages,
    tokenize=True,
    add_generation_prompt=False,
)

# 模板已经加入所需特殊 token,再编码时不要重复添加。
retokenized_ids = tokenizer(
    train_text,
    add_special_tokens=False,
).input_ids

answer = messages[-1]['content']
print('template_present=', tokenizer.chat_template is not None)
print('training_contains_answer=', answer in train_text)
print('inference_is_prefix=', train_text.startswith(inference_prefix))
print('assistant_content_char=', train_text.find(answer))
print('training_tokens=', len(train_ids))
print('retokenize_matches=', retokenized_ids == train_ids)
print('tail_tokens=', tokenizer.convert_ids_to_tokens(train_ids[-6:]))
预期输出
template_present= True
training_contains_answer= True
inference_is_prefix= True
assistant_content_char= <ID>
training_tokens= <TOKENS>
retokenize_matches= True
tail_tokens= [<TOKEN>, <TOKEN>, <TOKEN>, <TOKEN>, <TOKEN>, <TOKEN>]<ID>、<TOKENS> 和结尾 token 名称会随 tokenizer 版本与模板变化。真正要验证的是布尔检查通过,并确认尾部 token 与当前模型模板定义的 assistant 结束方式一致。
检查三个关键边界
首先看特殊 token 是否只添加一次。如果先用 apply_chat_template(..., tokenize=False) 得到文本,再调用 tokenizer 编码,应设置 add_special_tokens=False;否则某些模型的 BOS、EOS 或角色标记可能被重复加入。
其次看assistant 内容从哪里开始。训练序列应包含 assistant 的角色边界和答案正文;推理序列则应停在模型准备生成 assistant 内容的位置。不要把 add_generation_prompt=True 用在已经包含完整 assistant 答案的训练样本上,否则可能多出新的 assistant 起始标记。
最后看样本如何结束。不要硬编码其他模型的 </s>、<|im_end|> 等字符串,应直接检查当前 tokenizer 渲染出的尾部 token。模型模板升级或更换基础模型后,这一步也应重新执行。
保持训练与推理一致
数据预处理、训练集抽样检查和线上推理应共享同一 tokenizer 与同一 Chat Template。训练阶段输入完整对话并关闭生成提示,推理阶段输入已知上下文并开启生成提示,两者只在是否包含目标答案这一点上不同。
正式训练前应随机抽取几十条样本,打印渲染文本和首尾 token,确认 system、user、assistant 的顺序、assistant 起点与结束标记都正确。只要训练端与推理端保持同一协议,后续 LoRA、QLoRA 或全参数训练就不会因为对话格式漂移额外损失效果。