
大模型原理与训练 / 系统课时
运行全参数监督微调任务
运行全参数监督微调任务
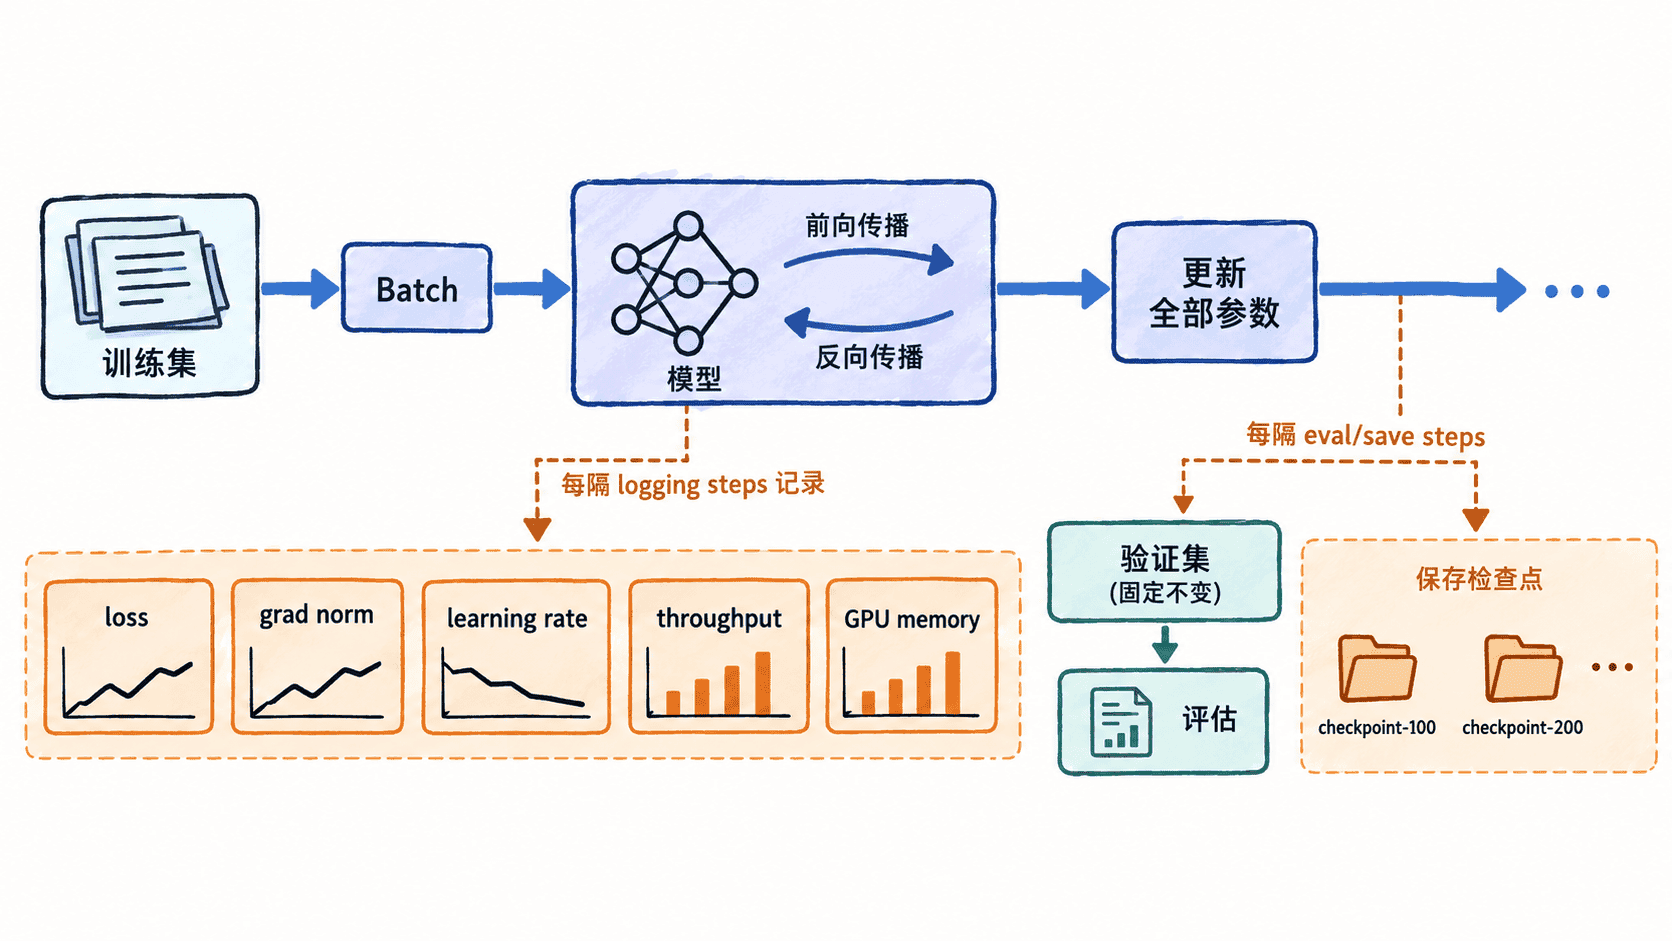
这一节把数据、训练参数、监控指标和检查点保存放进同一条可复现实验链路。你会用统一训练集与验证集启动全参数 SFT,并同时观察 loss、梯度范数、学习率、吞吐和峰值显存,确保后续检查点可以直接比较。
学习目标
- 启动真正更新全部模型参数的监督微调任务
- 用同一组日志指标判断训练是否稳定并识别异常趋势
- 按固定步数保存检查点,并用统一验证集比较不同阶段
固定实验口径
全参数训练最怕“参数变了、评测也变了”。在启动任务前先固定模型版本、训练/验证数据、最大序列长度、随机种子和验证频率。训练数据可使用 JSONL,每行至少包含 prompt 与 response 两个字段;验证集必须与训练集分离,并在整次实验中保持不变。
这里的主示例假设基础模型位于 <PATH>/base-model,数据位于 <PATH>/train.jsonl 与 <PATH>/validation.jsonl。脚本会让所有参数参与梯度更新,并按 100 步保存一次检查点。
启动全参数 SFT
下面脚本使用 transformers.Trainer 完成标准因果语言模型 SFT。示例默认使用支持 BF16 的 GPU;如果硬件不支持 BF16,需要改用适合本机的精度设置。
import os
import torch
from datasets import load_dataset
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    DataCollatorForLanguageModeling,
    Trainer,
    TrainingArguments,
)

MODEL_PATH = "<PATH>/base-model"
TRAIN_FILE = "<PATH>/train.jsonl"
VALID_FILE = "<PATH>/validation.jsonl"
OUTPUT_DIR = "<PATH>/full-sft"

tokenizer = AutoTokenizer.from_pretrained(MODEL_PATH, use_fast=True)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

dataset = load_dataset(
    "json",
    data_files={"train": TRAIN_FILE, "validation": VALID_FILE},
)

def tokenize(batch):
    texts = [
        f"User: {p}\nAssistant: {r}{tokenizer.eos_token}"
        for p, r in zip(batch["prompt"], batch["response"])
    ]
    return tokenizer(
        texts,
        truncation=True,
        max_length=2048,
        padding=False,
    )

tokenized = dataset.map(
    tokenize,
    batched=True,
    remove_columns=dataset["train"].column_names,
)

model = AutoModelForCausalLM.from_pretrained(
    MODEL_PATH,
    torch_dtype=torch.bfloat16,
)
model.config.use_cache = False

trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)
total = sum(p.numel() for p in model.parameters())
assert trainable == total, "存在被冻结的参数,当前不是全参数微调"

args = TrainingArguments(
    output_dir=OUTPUT_DIR,
    num_train_epochs=2,
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=16,
    learning_rate=1e-5,
    warmup_ratio=0.03,
    lr_scheduler_type="cosine",
    logging_steps=10,
    eval_strategy="steps",
    eval_steps=100,
    save_strategy="steps",
    save_steps=100,
    save_total_limit=3,
    max_grad_norm=1.0,
    bf16=True,
    gradient_checkpointing=True,
    report_to="none",
    seed=42,
)

trainer = Trainer(
    model=model,
    args=args,
    train_dataset=tokenized["train"],
    eval_dataset=tokenized["validation"],
    data_collator=DataCollatorForLanguageModeling(tokenizer, mlm=False),
)

train_result = trainer.train()
metrics = train_result.metrics
metrics["peak_gpu_memory_gb"] = round(
    torch.cuda.max_memory_allocated() / 1024**3, 2
)
trainer.log_metrics("train", metrics)
trainer.save_metrics("train", metrics)
预期输出
{'loss': <LOSS>, 'grad_norm': <GRAD_NORM>, 'learning_rate': <LR>, 'epoch': <EPOCH>}
...
***** train metrics *****
  train_loss               = <LOSS>
  train_samples_per_second = <THROUGHPUT>
peak_gpu_memory_gb = <GB><LOSS>、<GRAD_NORM>、<LR>、<EPOCH>、<THROUGHPUT> 与 <GB> 会随模型、数据和硬件变化。真正需要关注的是趋势:loss 应总体下降;梯度范数不应长期爆高或出现非有限值;学习率要符合预设调度;吞吐不应突然塌陷;峰值显存必须留出足够余量。
比较固定步数检查点
保存频率只有在验证口径固定时才有意义。每到一个保存步数,都用同一验证集观察 eval_loss,并同时保留对应的训练日志。不要只挑训练 loss 最低的检查点,因为训练 loss 继续下降时,验证集表现可能已经开始恶化。
可以直接检查输出目录确认检查点是否按预期产生:
ls -1 <PATH>/full-sft | grep '^checkpoint-'预期输出
checkpoint-<STEP>
...
<STEP> 的实际值取决于训练总步数;由于 save_total_limit=3,目录中最多保留三个检查点。如果应保存的步数没有对应目录,先检查 save_strategy、save_steps 和训练是否真正运行到该 step,再讨论模型效果。
发现不稳定时先看哪一项
loss 变成 nan 或突然飙升时,先看梯度范数,再检查学习率是否过高、混合精度是否溢出以及样本中是否存在异常长序列。吞吐持续下降但显存不断上升,则要检查动态长度分布、缓存和数据预处理;显存直接溢出时,应优先减小单卡 batch、启用梯度检查点或缩短序列,而不是随意改变评测口径。
一次可比较的全参数 SFT,不只是“训练能跑完”,而是训练参数、数据切分、日志频率、验证频率和检查点节奏都被固定下来。这样后续选择某个 checkpoint 时,依据来自同一套指标,而不是训练末尾的一次偶然结果。