
大模型原理与训练 / 系统课时
处理多卡保存与断点恢复
处理多卡保存与断点恢复
多卡任务真正可恢复的不是一份模型权重,而是一组彼此同步的训练状态。本篇建立统一检查点边界,用分布式检查点保存模型和优化器,同时保存调度器、采样进度与随机状态,并验证同并行和调整并行后的恢复行为。
学习目标
- 区分模型分片、全局训练状态与每个 Rank 独有的运行时状态。
- 保存模型、优化器、调度器、采样进度和随机数状态。
- 判断同一并行配置下的精确恢复与调整并行度后的弹性恢复有什么差异。
先定义可恢复状态边界
只保存模型参数只能用于继续推理,不能保证训练从原位置继续。一个完整检查点至少要覆盖以下状态:
| 状态 | 典型归属 | 恢复要求 |
|---|---|---|
| 模型参数 | 分片或复制 | 必须恢复 |
| 优化器状态 | 常随参数分片 | 必须恢复,否则动量等历史丢失 |
| 学习率调度器 | 全局一致 | 恢复到相同训练步 |
| 采样器进度 | 与数据顺序相关 | 保存 epoch 与全局样本游标,或保存采样器 state_dict |
| 随机状态 | 每个 Rank 独立 | 同 world size 时按 Rank 恢复 |
| global step | 全局一致 | 用于调度、日志和断点位置判断 |
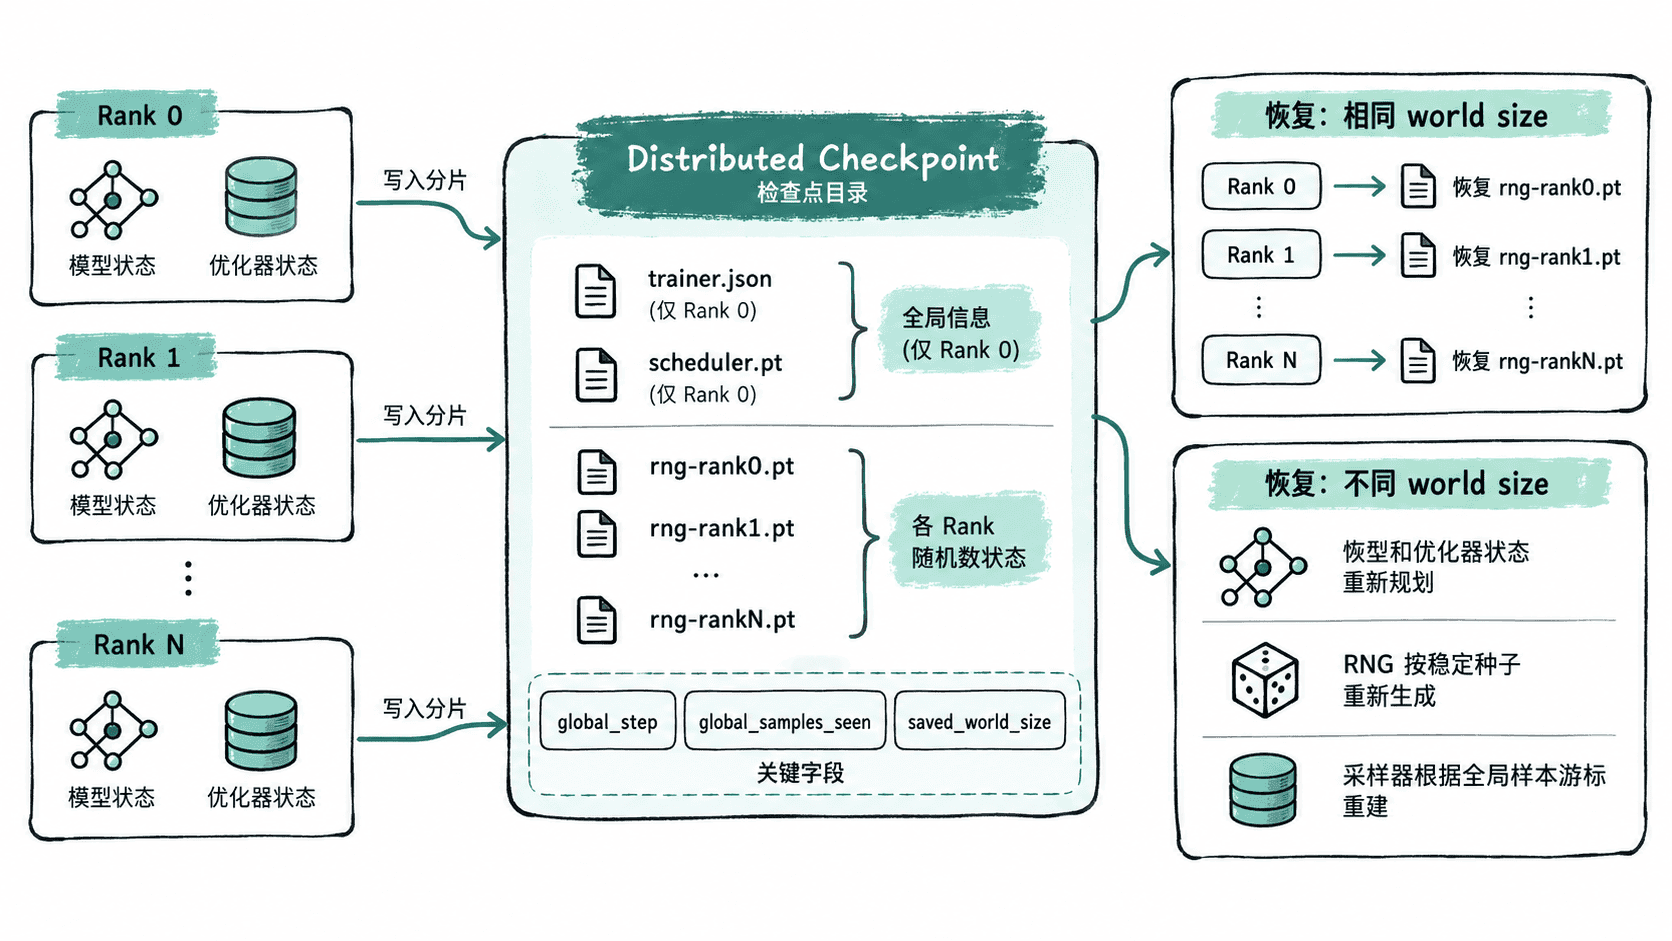
最容易被遗漏的是采样器和随机数状态。world size 不变时,可以恢复每个 Rank 的 RNG,尽量延续原训练轨迹;world size 改变后,旧 Rank 与新 Rank 无法一一对应,应依赖“全局样本游标 + 可重建采样规则”,而不是强行加载旧 Rank 的随机状态。
保存分布式检查点
下面用小模型验证保存协议。示例要求在共享文件系统上运行,并已安装支持 torch.distributed.checkpoint 的 PyTorch。模型虽然很小,但状态边界与大模型训练一致;真实 FSDP 或 DTensor 作业可以继续沿用相同的分布式检查点思路。
# checkpoint_demo.py
import argparse
import json
import os
from pathlib import Path

import torch
import torch.distributed as dist
import torch.distributed.checkpoint as dcp
from torch.distributed.checkpoint.state_dict import get_state_dict, set_state_dict
from torch.nn.parallel import DistributedDataParallel as DDP

parser = argparse.ArgumentParser()
parser.add_argument('mode', choices=['save', 'load'])
parser.add_argument('--dir', default='ckpt')
args = parser.parse_args()

dist.init_process_group('nccl')
rank = dist.get_rank()
world = dist.get_world_size()
local_rank = int(os.environ['LOCAL_RANK'])
torch.cuda.set_device(local_rank)
device = torch.device('cuda', local_rank)
root = Path(args.dir)
root.mkdir(parents=True, exist_ok=True)

model = DDP(torch.nn.Linear(8, 2).to(device), device_ids=[local_rank])
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
scheduler = torch.optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=10)

if args.mode == 'save':
    x = torch.ones(2, 8, device=device)
    loss = model(x).pow(2).mean()
    loss.backward()
    optimizer.step()
    optimizer.zero_grad(set_to_none=True)
    scheduler.step()
else:
    # 先物化 AdamW 状态槽,随后由检查点内容覆盖。
    warmup = model(torch.zeros(2, 8, device=device)).sum()
    warmup.backward()
    optimizer.step()
    optimizer.zero_grad(set_to_none=True)

model_sd, optim_sd = get_state_dict(model, optimizer)
state = {'model': model_sd, 'optimizer': optim_sd}

if args.mode == 'save':
    dcp.save(state, checkpoint_id=str(root / 'dcp'))
    torch.save(
        {'cpu_rng': torch.get_rng_state(), 'cuda_rng': torch.cuda.get_rng_state(device)},
        root / f'rng-rank{rank}.pt',
    )
    if rank == 0:
        meta = {
            'global_step': 1,
            'epoch': 0,
            'global_samples_seen': 2 * world,
            'base_seed': 2026,
            'saved_world_size': world,
        }
        (root / 'trainer.json').write_text(json.dumps(meta), encoding='utf-8')
        torch.save(scheduler.state_dict(), root / 'scheduler.pt')
        print(f'saved step=1 world_size={world}')
else:
    dcp.load(state, checkpoint_id=str(root / 'dcp'))
    set_state_dict(
        model,
        optimizer,
        model_state_dict=state['model'],
        optim_state_dict=state['optimizer'],
    )
    meta = json.loads((root / 'trainer.json').read_text(encoding='utf-8'))
    scheduler.load_state_dict(
        torch.load(root / 'scheduler.pt', map_location='cpu', weights_only=True)
    )
    same_world = meta['saved_world_size'] == world
    if same_world:
        runtime = torch.load(
            root / f'rng-rank{rank}.pt', map_location='cpu', weights_only=True
        )
        torch.set_rng_state(runtime['cpu_rng'])
        torch.cuda.set_rng_state(runtime['cuda_rng'], device=device)
    else:
        seed = meta['base_seed'] + meta['global_step'] * 1000 + rank
        torch.manual_seed(seed)
        torch.cuda.manual_seed(seed)
    if rank == 0:
        rng_mode = 'restored' if same_world else 'reseeded'
        step = meta['global_step']
        saved_world = meta['saved_world_size']
        print(
            f'resumed step={step} saved_world_size={saved_world} '
            f'current_world_size={world} rng={rng_mode}'
        )

dist.barrier()
dist.destroy_process_group()
先用两张 GPU 保存,再改成一张 GPU 恢复:
torchrun --standalone --nproc_per_node=2 checkpoint_demo.py save --dir ckpt
torchrun --standalone --nproc_per_node=1 checkpoint_demo.py load --dir ckpt
预期输出中会出现下面两行;PyTorch 自身可能额外打印分布式日志。
saved step=1 world_size=2
resumed step=1 saved_world_size=2 current_world_size=1 rng=reseeded
示例把采样器状态压缩成 epoch 与 global_samples_seen 两个跨 world size 字段。真实数据管线如果使用可状态化采样器,应把它的 state_dict 一并保存;如果只记录“当前 Rank 已消费多少样本”,改变 world size 后通常无法无歧义续接。
区分精确恢复与弹性恢复
同一 world size 下,模型、优化器、调度器、采样进度和各 Rank RNG 都可以按原映射恢复,目标是让后续数据顺序和随机操作尽量延续原轨迹。仍要注意 CUDA 算子本身是否完全确定性,否则数值也可能产生微小分叉。
world size 改变后,模型和优化器的分布式状态可以由支持重分片的检查点机制重新规划,但旧 Rank 的 RNG 文件不能直接映射给新的 Rank 集合。此时应恢复全局步数和采样游标,再按稳定种子规则重建随机流。这样能够继续训练,却不应宣称后续每个 batch 与原计划完全一致。
用两种并行配置做验收
恢复后至少检查三件事:global_step 是否延续、学习率是否与保存点一致、第一批数据是否从预期游标开始。world size 不变时,再验证同一 Rank 的 RNG 已恢复;world size 改变时,则验证采样器没有重复消费或跳过整段数据。
对于长任务,正式训练前应先跑几十步并保存检查点,分别用原 world size 和新 world size 做一次恢复演练。能加载权重不等于能继续训练,只有优化器、调度器、数据位置和随机状态都通过验证,断点恢复才算完整。