
大模型应用开发 / 系统课时
构建最小 RAG 应用
构建最小 RAG 应用
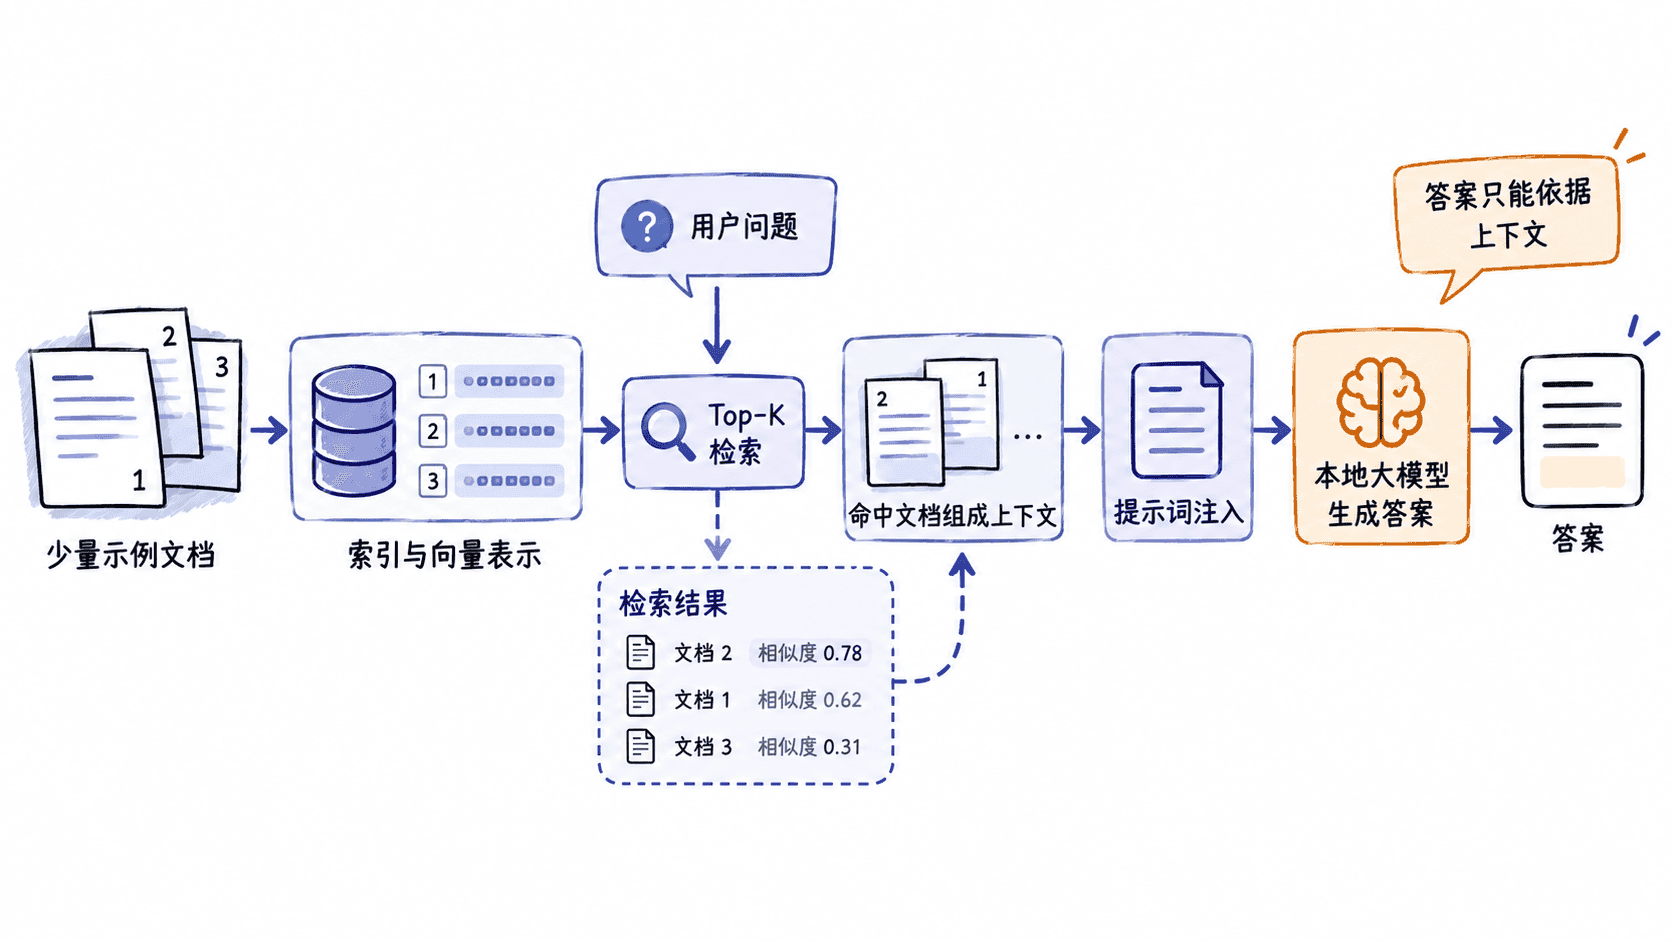
这一节用少量内置文档搭出一个可运行的 RAG 闭环:先建立轻量检索索引,再选出相关文档,把命中的正文注入提示词,最后调用本地大模型生成答案,并能看到每一步的结果。
学习目标
- 用最少组件完成“索引、检索、上下文注入、生成”四个环节
- 看懂检索结果如何进入最终提示词
- 能运行示例并判断 RAG 闭环是否真正生效
先确定最小闭环
最小 RAG 不需要先引入向量数据库。为了把流程看清,本例用 Python 标准库把文档转成词元计数向量,以余弦相似度做检索,再通过本机 Ollama 的 HTTP 接口生成答案。生产环境可以把检索层替换成嵌入模型和向量库,但四段式闭环不变。
运行完整示例
先确保本机 Ollama 服务已经运行,并把环境变量 OLLAMA_MODEL 设置为本机已下载的模型名。下面代码不依赖第三方 Python 包,保存为 minimal_rag.py 后即可执行。
python
import json
import math
import os
import re
from collections import Counter
from urllib import request

DOCS = [
    {"id": "doc-1", "title": "重置密码", "text": "用户可以在登录页点击忘记密码,通过邮箱验证码重置密码。"},
    {"id": "doc-2", "title": "退款规则", "text": "订单支付后七天内且未使用服务时,可以申请原路退款。"},
    {"id": "doc-3", "title": "发票说明", "text": "订单完成后可以在订单详情页申请电子发票。"},
]

def tokens(text):
    # 中文按单字、英文按单词切分,足够支撑这个最小检索实验。
    return re.findall(r"[\u4e00-\u9fff]|[a-z0-9_]+", text.lower())

def cosine(a, b):
    keys = a.keys() | b.keys()
    dot = sum(a[k] * b[k] for k in keys)
    na = math.sqrt(sum(v * v for v in a.values()))
    nb = math.sqrt(sum(v * v for v in b.values()))
    return dot / (na * nb) if na and nb else 0.0

INDEX = [(doc, Counter(tokens(doc["title"] + doc["text"]))) for doc in DOCS]

def retrieve(query, top_k=2):
    qv = Counter(tokens(query))
    ranked = [(cosine(qv, vec), doc) for doc, vec in INDEX]
    return sorted(ranked, key=lambda item: item[0], reverse=True)[:top_k]

def generate(question, hits):
    # 只把命中的正文交给模型,避免把整个知识库直接塞进提示词。
    context = "\n".join(f"[{doc['id']}] {doc['text']}" for _, doc in hits)
    prompt = (
        "请只根据以下上下文回答问题;上下文没有答案就说不知道。\n"
        f"上下文:\n{context}\n\n问题:{question}\n答案:"
    )
    body = json.dumps({
        "model": os.environ["OLLAMA_MODEL"],
        "prompt": prompt,
        "stream": False
    }).encode("utf-8")
    req = request.Request(
        "http://127.0.0.1:11434/api/generate",
        data=body,
        headers={"Content-Type": "application/json"},
    )
    with request.urlopen(req, timeout=60) as resp:
        return json.loads(resp.read().decode("utf-8"))["response"].strip()

if __name__ == "__main__":
    question = "订单支付后多久还能退款?"
    hits = retrieve(question)
    print("检索结果:")
    for score, doc in hits:
        print(doc["id"], f"{score:.3f}", doc["title"])
    print("答案:")
    print(generate(question, hits))
预期输出如下;相似度和模型措辞会随实现与模型变化,因此用动态占位符表示。
text
检索结果:
doc-2 <VALUE> 退款规则
doc-3 <VALUE> 发票说明
答案:
<VALUE>
只要第一名命中 doc-2,且答案表达“支付后七天内、未使用服务时可申请原路退款”,就说明检索与生成已经连通。若模型返回其他内容,应先打印实际注入的上下文,再判断问题出在检索还是生成。
检查每一段是否真的生效
索引阶段的产物是 INDEX,检索阶段的产物是按相似度排序的 hits,上下文注入发生在 generate() 中,生成阶段则是本地模型返回 response。调试时不要只看最终答案,否则很难区分“检索没命中”和“模型没有按上下文回答”。
什么时候算完成
这个最小应用通过三个条件即可验收:问题能够命中预期文档;提示词只包含 Top-K 命中文档而不是整个知识库;最终答案能够从命中上下文中找到依据。满足这三点后,你已经拥有一个可继续替换分块、嵌入、向量库和生成模型的 RAG 骨架。
按自己的节奏,确认真正理解。