
大模型应用开发 / 系统课时
组装检索上下文
组装检索上下文
检索命中并不等于可以直接塞进提示词。本节把候选片段整理成可供模型稳定阅读的上下文:先按相关性选取,再去重并恢复文档结构,同时保留来源,最终得到有顺序、少重复、可追溯的证据集合。
学习目标
- 能把相关性排序、去重、结构重排拆成独立步骤
- 能为每个上下文片段保留最小但足够的来源信息
- 能验证最终上下文是否既相关又保持原文逻辑
为什么不能直接拼接检索结果
向量检索通常按相似度返回片段,但这个顺序只表示“与问题有多像”,不保证文档叙事顺序正确。相邻片段还可能内容重叠,多个文档也可能复制了相同段落。如果直接拼接,模型会看到重复证据、前后颠倒的步骤,甚至无法判断答案来自哪里。
更稳妥的做法是把“选哪些片段”和“以什么顺序呈现”分开:先依据相关性挑出候选,再去重,最后依据文档及章节位置恢复阅读顺序。来源标识应与片段一起进入上下文,便于模型引用,也方便应用层记录证据。
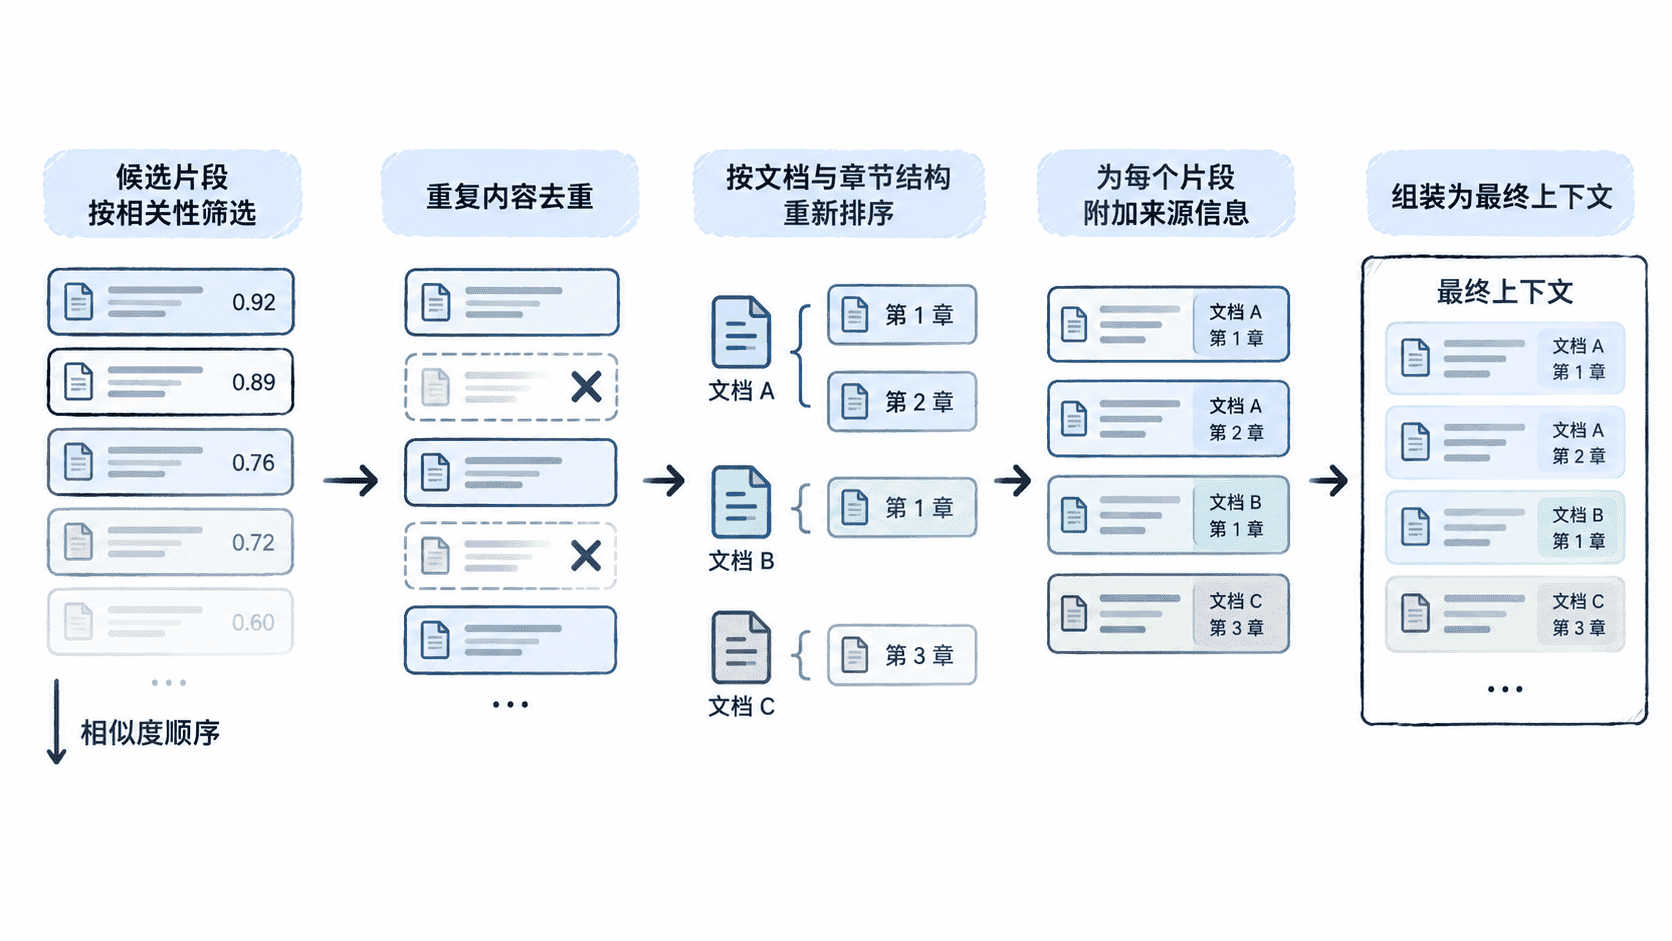
用两阶段排序组装上下文
下面的示例先按 score 选择最相关片段,再按 doc_order 与 section_order 恢复结构。去重键使用规范化后的正文,而不是片段 ID,因此复制得到的重复内容也能被过滤。
fragments = [
    {"id": "a1", "doc_order": 1, "section_order": 2, "score": 0.91,
     "text": "先创建索引,再启动检索服务。", "source": "guide.md#部署"},
    {"id": "a2", "doc_order": 1, "section_order": 1, "score": 0.88,
     "text": "部署前需要准备向量模型和文档数据。", "source": "guide.md#准备"},
    {"id": "b1", "doc_order": 2, "section_order": 1, "score": 0.84,
     "text": "端口被占用时应更换监听端口。", "source": "faq.md#启动失败"},
    {"id": "dup", "doc_order": 3, "section_order": 1, "score": 0.80,
     "text": "先创建索引,再启动检索服务。", "source": "copy.md#复制内容"},
]

def normalize(text):
    return " ".join(text.split())

def assemble_context(items, top_k=4):
    ranked = sorted(items, key=lambda x: x["score"], reverse=True)[:top_k]
    seen = set()
    unique = []
    for item in ranked:
        key = normalize(item["text"])
        if key in seen:
            continue
        seen.add(key)
        unique.append(item)

    ordered = sorted(unique, key=lambda x: (x["doc_order"], x["section_order"]))
    blocks = [
        f"[source={x['source']} score={x['score']:.2f}]\n{x['text']}"
        for x in ordered
    ]
    return "\n\n".join(blocks)

print(assemble_context(fragments))
预期输出
[source=guide.md#准备 score=0.88]
部署前需要准备向量模型和文档数据。

[source=guide.md#部署 score=0.91]
先创建索引,再启动检索服务。

[source=faq.md#启动失败 score=0.84]
端口被占用时应更换监听端口。
输出中 dup 被去除,而同一文档里的“准备”重新排在“部署”之前。这说明相关性决定是否进入上下文,文档结构决定进入后怎样排列,两者职责不同。
保留恰到好处的来源信息
来源信息至少要能定位原始证据,例如文件名、文档 ID、章节锚点或页面号。不要把整份元数据对象原样塞入上下文;大量更新时间、内部路径和无关标签会消耗令牌,却很少改善答案质量。
如果应用要求引用,推荐让每个片段携带稳定来源标识,并在提示词中明确要求“只引用已提供的来源标识”。检索分数可以保留给调试或排序,但不应让模型把高分自动解释为事实可信度。
检查上下文是否可用
交给模型前,至少检查三件事:是否存在近似重复片段,是否出现同一文档内部顺序颠倒,以及每个片段是否都能追溯来源。对于跨文档问题,可以保留“文档之间按相关性、文档内部按结构”的规则,这通常比全局强行恢复原始顺序更稳健。
最终上下文的目标不是“尽可能多”,而是让模型按合理顺序读到足够证据。只要相关片段已覆盖问题、重复被去除且来源可追溯,就应把剩余令牌留给问题说明和答案生成。