
大模型应用开发 / 系统课时
写入知识向量
写入知识向量
这一节解决“向量生成出来后如何可靠落库”的问题:把片段文本、向量和元数据组成稳定记录,按批次执行幂等写入,并对临时失败做有限重试。完成后,即使任务重复执行,也不会不断制造重复数据,失败批次也能被单独补偿。
学习目标
- 设计可重复执行的向量记录 ID 与元数据结构
- 使用批量 upsert 避免重复写入并支持内容更新
- 区分整批失败与逐条失败,建立可恢复的写入路径
先确定一条记录必须包含什么
知识向量至少需要四类信息:稳定主键、原始文本、向量本身和可过滤的元数据。主键用于幂等写入,文本用于把检索结果交给生成模型,元数据则承载 doc_id、片段序号、来源、版本、权限标签等检索过滤条件。
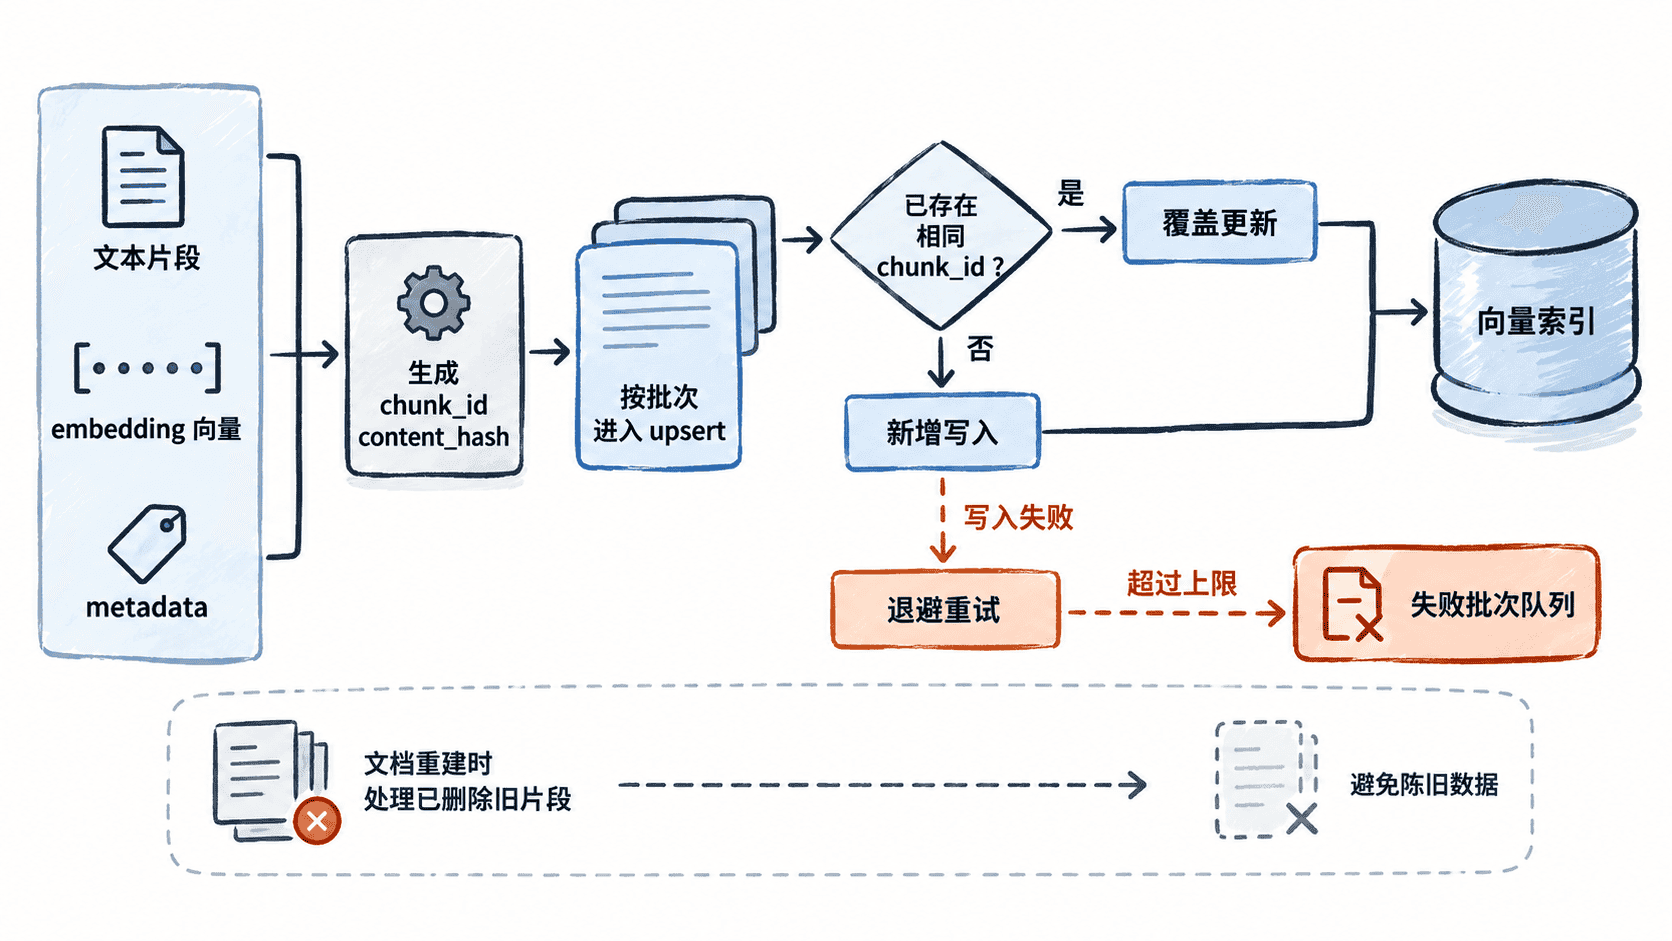
稳定 ID 最常见的做法是 doc_id + chunk_no。这样同一文档重新切分后,相同位置可直接覆盖;同时把内容哈希放进元数据,便于判断内容是否真的变化。若切分策略会大幅改变片段编号,则应增加索引版本并在重建完成后清理旧版本。
用批量 upsert 保证重复执行不增量膨胀
下面用内存索引模拟向量数据库的 upsert 语义。第一次写入会故意触发一次临时错误;第二次把同样的三条记录再写一遍,唯一记录数仍然是 3,说明重复任务不会把数据扩成 6 条。
import hashlib
import time
from dataclasses import dataclass

@dataclass
class VectorRecord:
    id: str
    text: str
    vector: list[float]
    metadata: dict[str, str]

class DemoVectorIndex:
    def __init__(self):
        self.store = {}
        self.fail_once = True

    def upsert(self, records):
        # 模拟一次可重试的临时写入失败。
        if self.fail_once:
            self.fail_once = False
            raise RuntimeError("temporary write failure")
        for record in records:
            self.store[record.id] = record

def content_hash(text):
    return hashlib.sha256(text.encode("utf-8")).hexdigest()[:12]

def write_batches(index, records, batch_size=2, max_retries=3):
    for start in range(0, len(records), batch_size):
        batch = records[start:start + batch_size]
        for attempt in range(1, max_retries + 1):
            try:
                index.upsert(batch)
                break
            except RuntimeError:
                if attempt == max_retries:
                    raise
                time.sleep(0.05 * (2 ** (attempt - 1)))

records = [
    VectorRecord(
        id="doc-1:0",
        text="退款申请需要订单号。",
        vector=[0.10, 0.20, 0.30],
        metadata={"doc_id": "doc-1", "chunk_no": "0", "content_hash": content_hash("退款申请需要订单号。")},
    ),
    VectorRecord(
        id="doc-1:1",
        text="审核通过后原路退款。",
        vector=[0.40, 0.50, 0.60],
        metadata={"doc_id": "doc-1", "chunk_no": "1", "content_hash": content_hash("审核通过后原路退款。")},
    ),
    VectorRecord(
        id="doc-2:0",
        text="发票可在订单页申请。",
        vector=[0.70, 0.80, 0.90],
        metadata={"doc_id": "doc-2", "chunk_no": "0", "content_hash": content_hash("发票可在订单页申请。")},
    ),
]

index = DemoVectorIndex()
write_batches(index, records)
print(f"first_write_unique={len(index.store)}")

write_batches(index, records)
print(f"second_write_unique={len(index.store)}")
print(f"ids={','.join(sorted(index.store))}")
预期输出
first_write_unique=3
second_write_unique=3
ids=doc-1:0,doc-1:1,doc-2:0
真实向量数据库通常也提供 upsert 或“主键冲突时更新”的等价能力。接入具体 SDK 时,把 DemoVectorIndex.upsert() 替换成供应商的批量写接口即可,同时保留稳定 ID、分批、重试和失败记录这四层控制。
重复数据与陈旧数据不是一回事
幂等 upsert 解决的是“同一记录重复写入”。它不会自动删除“这次已经不存在的旧片段”。例如文档原来有 10 个片段,新版本只有 8 个,如果只 upsert 新的 8 条,旧的 doc-1:8 与 doc-1:9 仍可能被检索到。
可靠做法通常有两种:按 doc_id 先删除旧片段再写新版本,或给每次构建加入 index_version,新版本全部写完并验收后再切换查询过滤条件,最后异步清理旧版本。后者更适合不能接受索引短暂空窗的生产系统。
写入失败要按接口语义处理
如果数据库以事务方式提交整批数据,那么失败通常意味着整批都没有生效,可以直接重试该批。如果接口支持部分成功,则必须读取返回的失败 ID,只补写失败记录;否则会重复消耗带宽,还可能掩盖单条数据的固定错误。
写入完成后的验收至少检查三件事:唯一记录数是否符合预期、随机抽样的文本与元数据是否能按 ID 读回、使用一条已知查询是否能检索到正确片段。只有“写接口返回成功”还不足以证明知识索引已经可用。