
大模型应用开发 / 系统课时
RAG 核心处理链路
RAG 核心处理链路
一个可工作的 RAG 应用不只是“接一个向量数据库”。它需要先把原始资料加工成可检索的数据,再在用户提问时完成检索、上下文构建和答案生成。掌握整条链路后,才能判断问题究竟出在数据、检索还是生成阶段。
学习目标
- 说清数据导入、切分、向量化、检索、上下文构建和生成的先后关系
- 区分离线知识准备与在线问答两个阶段
- 根据最终回答问题定位最可能出现故障的处理环节
一条 RAG 链路包含两个阶段
RAG 通常可以分成知识准备和在线问答两个阶段。知识准备阶段处理相对稳定的原始资料,把它们转换成适合搜索的知识单元;在线问答阶段则从用户问题出发,实时寻找相关内容并生成答案。
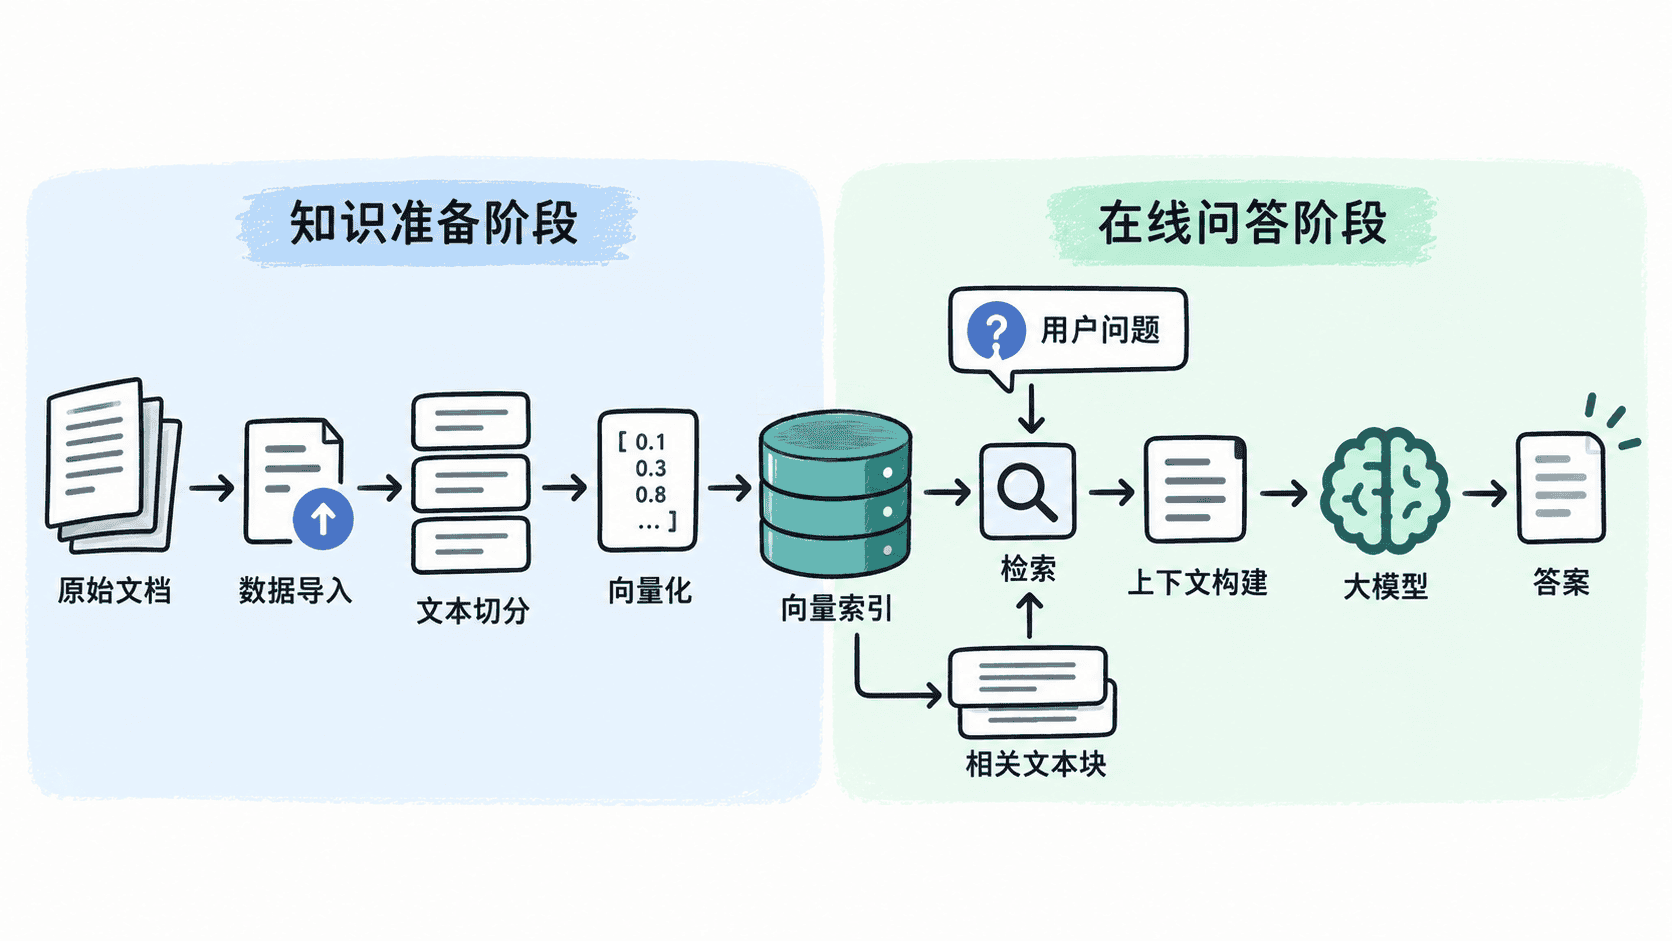
离线与在线阶段并不是两个互不相关的系统。向量索引是它们之间的重要连接点:前一阶段把可检索的数据写进去,后一阶段根据用户问题从中取出相关内容。
知识准备先把资料变成可检索单元
数据导入负责取得原始知识,例如 Markdown、PDF、网页文本或数据库导出的记录。仅把整个文件保存起来还不够,因为一个文件可能包含几十页内容,而用户的问题通常只对应其中很小一部分。
文本切分会把长文档拆成较小的文本块。切得过大,检索结果会混入大量无关内容;切得过小,又可能破坏完整语义。实际应用通常还会为文本块保留来源、标题、文档标识等元数据,方便过滤和答案溯源。
随后系统对文本块执行向量化,把文本映射成可用于相似度搜索的向量表示,并将向量、原文及必要元数据写入索引。到这里,知识准备阶段才算形成了能够被在线查询的检索数据。
在线问答从问题找到证据
用户提出问题后,系统首先需要按照与知识库兼容的方式表示查询,并从索引中检索相关文本块。检索的目标不是立即生成答案,而是找出最可能包含答案依据的证据。
取得候选文本后,系统进入上下文构建阶段。这里会把用户问题、检索到的文本以及必要的回答约束组织成模型输入。例如可以要求模型仅依据给定资料回答,资料不足时明确说明无法确定,并保留文档来源供后续引用。
最后才是答案生成。大模型阅读问题和检索上下文,完成信息归纳与自然语言表达。因此,生成模型看到的并不是整个知识库,而是当前请求检索出来的一小部分内容。
回答出错时沿链路向前定位
RAG 的最终错误经常不是生成模型单独造成的。排查时应先判断正确证据有没有进入模型上下文,再继续向前检查。
如果知识库里根本没有目标资料,应检查数据导入;资料存在但关键信息被截断,应检查文本切分;相关文本存在却始终搜不到,应检查向量化和检索;已经检索到正确文本但没有进入模型输入,应检查上下文构建;证据完整进入上下文后仍然答错,才重点检查提示约束与生成模型行为。
这条链路的关键不是记住六个名词,而是理解每一步的输入和输出:原始资料经过加工成为可搜索知识,用户问题经过检索取得证据,证据再进入模型形成答案。只要能够沿数据流逐段检查,就能为后续开发和调试建立清晰的定位路径。