
大模型应用开发 / 系统课时
定位链路问题
定位链路问题
RAG 出错时,不要只看最终回答。把查询、候选片段、重排序结果和最终提示词按同一次请求保存下来,就能判断错误发生在召回、排序、上下文组装还是生成阶段,并把“感觉不对”变成可复现的证据。
学习目标
- 为一次 RAG 请求建立可追踪的链路记录
- 根据各阶段产物判断错误发生位置
- 用最小日志保留足够证据,同时避免记录敏感内容
先把一次请求拆成可检查阶段
定位链路问题的关键不是增加更多日志,而是给同一次请求保留一组能前后对照的中间结果。最小链路通常包含原始查询、检索候选、重排序结果、最终提示词,以及最终回答。
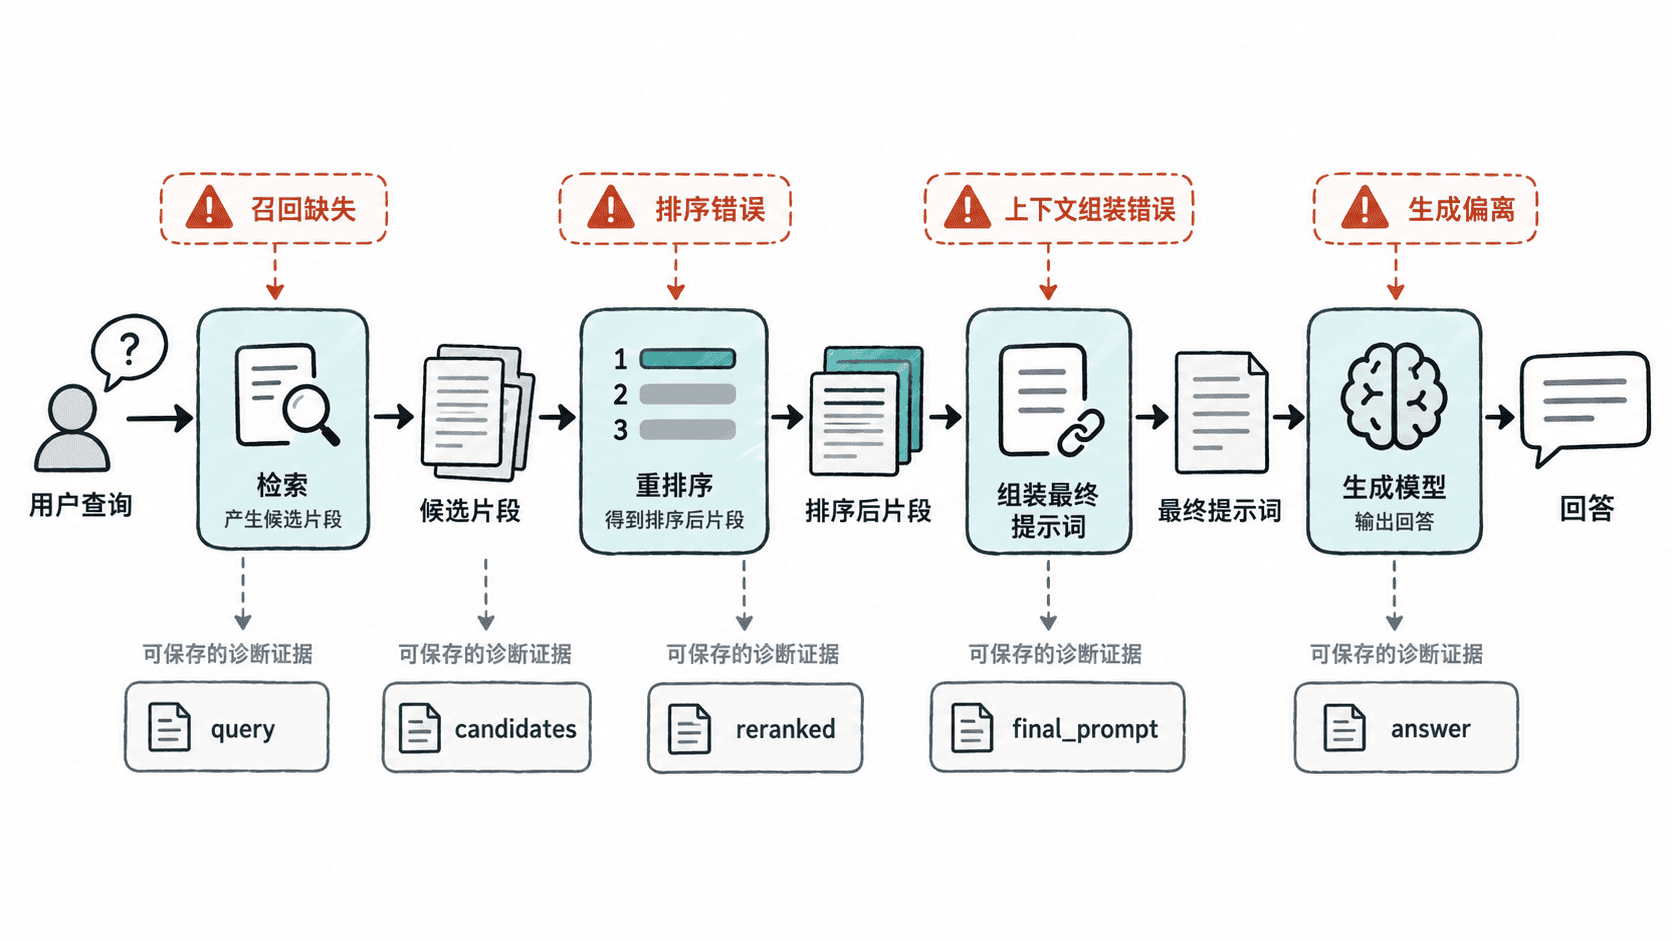
如果查询本身就被改写错了,后面的结果再好也无意义;如果正确证据已经进入候选,但在重排序后消失,应检查排序模型或阈值;如果正确片段进入提示词而答案仍错误,问题才更可能落在提示词约束或生成阶段。
保存最小可追踪记录
下面的示例用标准库把一次请求的关键阶段写入 JSONL。实际项目中可把 trace_id 贯穿检索、重排序和生成调用,便于跨服务关联。
python
import json
from datetime import datetime, timezone

# 同一次请求的所有阶段共享 trace_id,便于前后对照。
trace = {
    "trace_id": "req-001",
    "time": datetime.now(timezone.utc).isoformat(),
    "query": "退款到账需要多久?",
    "candidates": [
        {"id": "doc-a", "score": 0.82, "text": "退款审核通过后通常原路退回。"},
        {"id": "doc-b", "score": 0.76, "text": "银行卡退款一般需要 3 到 7 个工作日。"},
    ],
    "reranked": [
        {"id": "doc-b", "score": 0.91},
        {"id": "doc-a", "score": 0.63},
    ],
    "final_prompt": "仅依据资料回答:银行卡退款一般需要 3 到 7 个工作日。",
    "answer": "银行卡退款一般需要 3 到 7 个工作日。",
}

# JSONL 便于逐请求追加,也方便后续按 trace_id 检索和重放。
with open("rag_trace.jsonl", "a", encoding="utf-8") as file:
    file.write(json.dumps(trace, ensure_ascii=False) + "\n")

print(trace["trace_id"])
print(len(trace["candidates"]), len(trace["reranked"]))
print(trace["answer"])
预期输出
text
req-001
2 2
银行卡退款一般需要 3 到 7 个工作日。
时间字段会随实际运行变化。生产环境还应对用户输入、文档正文和提示词中的敏感信息做脱敏或摘要化保存,而不是无条件记录原文。
按证据顺序定位故障
建议按“从前到后”的顺序检查,而不是先修改提示词。
| 看到的证据 | 更可能的问题 | 优先检查 |
|---|---|---|
| 候选中没有正确片段 | 检索召回不足 | 查询改写、切分、向量或关键词检索、过滤条件 |
| 候选有正确片段,重排序后消失 | 排序阶段误判 | 重排序模型、阈值、输入截断 |
| 重排序正确,提示词缺少关键片段 | 上下文组装错误 | top-k 截断、去重、模板拼接、长度预算 |
| 提示词已有充分证据,回答仍偏离 | 生成阶段问题 | 指令约束、引用要求、模型能力、温度 |
特别注意“正确片段存在”与“正确片段被模型看到”不是一回事。调试时必须检查最终提示词或等价的上下文快照,否则很容易把组装错误误判成模型幻觉。
让日志能用于复现
一次有效的诊断记录至少要能回答三个问题:这次请求输入了什么、每个阶段选择了什么、最终模型真正看到了什么。除 trace_id 外,还应记录检索配置版本、重排序配置版本和提示词模板版本;这样参数调整后,旧问题仍能按原条件重放。
当每个阶段都有可对照证据后,RAG 排障就不再是“反复改提示词试试看”,而是根据链路中第一个出现偏差的位置修复对应组件。
按自己的节奏,确认真正理解。