
大模型应用开发 / 系统课时
批量生成向量
批量生成向量
这一节解决“文档一多就生成不稳”的问题:把文本切成受控批次,限制并发,对临时失败重试,并用缓存避免重复调用。完成后,你会得到一个可复用的批处理骨架,既能保护外部 Embedding API,也能保持结果顺序与可恢复性。
学习目标
- 根据服务端限制设计批量大小与并发上限
- 为 429、超时和 5xx 等临时失败加入有边界的重试
- 用稳定缓存键避免相同文本重复生成向量
先把吞吐拆成四个控制点
批量生成向量不是“开更多线程就更快”。真正需要同时控制的是单批输入量、并发请求数、失败后的重试节奏和缓存命中率。批次过大容易触发请求大小或 token 上限,并发过高会撞上 QPS 限流;无脑重试则会把短暂抖动放大成重试风暴。
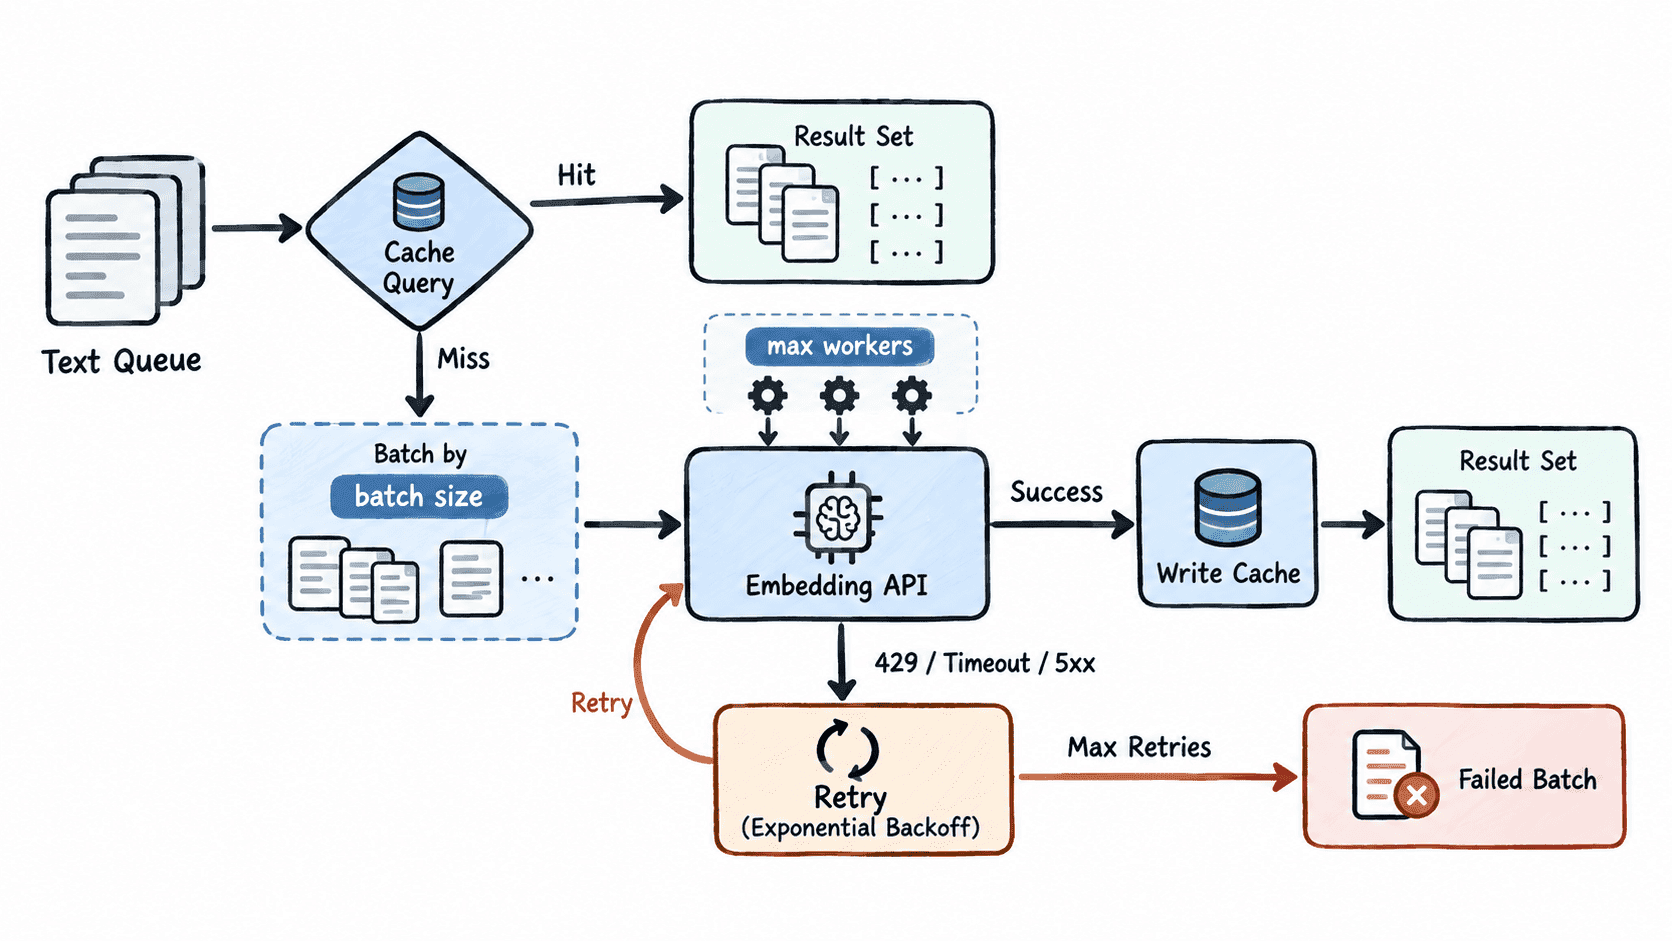
缓存键至少应包含模型标识、文本内容和会影响向量结果的预处理版本。只用原文做键会留下隐患:更换模型或归一化规则后,旧缓存仍可能被错误复用。
用一个可运行骨架控制批量、并发和重试
下面的示例使用标准库模拟 Embedding 服务。retry 所在批次第一次会故意失败,用来验证重试;第二次整体运行会直接命中缓存,不再增加 API 调用次数。替换 DemoEmbeddingClient.embed() 即可接入真实 SDK。
import hashlib
import threading
import time
from concurrent.futures import ThreadPoolExecutor, as_completed

class DemoEmbeddingClient:
    def __init__(self):
        self.calls = 0
        self.attempts = {}
        self.lock = threading.Lock()

    def embed(self, texts):
        key = "|".join(texts)
        with self.lock:
            self.calls += 1
            self.attempts[key] = self.attempts.get(key, 0) + 1
            attempt = self.attempts[key]

        # 模拟一个可重试的临时故障。
        if "retry" in texts and attempt == 1:
            raise RuntimeError("temporary 503")

        vectors = []
        for text in texts:
            digest = hashlib.sha256(text.encode("utf-8")).digest()
            vectors.append([round(b / 255, 4) for b in digest[:4]])
        return vectors

def make_cache_key(model, text):
    raw = f"{model}\0{text}".encode("utf-8")
    return hashlib.sha256(raw).hexdigest()

def embed_batch_with_retry(client, batch, max_retries=3):
    texts = [text for _, text in batch]
    for attempt in range(1, max_retries + 1):
        try:
            vectors = client.embed(texts)
            return [(index, vector) for (index, _), vector in zip(batch, vectors)]
        except RuntimeError:
            if attempt == max_retries:
                raise
            time.sleep(0.05 * (2 ** (attempt - 1)))

def batch_embed(client, texts, model="demo-v1", batch_size=2, max_workers=2):
    results = [None] * len(texts)
    pending = []

    for index, text in enumerate(texts):
        key = make_cache_key(model, text)
        if key in CACHE:
            results[index] = CACHE[key]
        else:
            pending.append((index, text))

    batches = [pending[i:i + batch_size] for i in range(0, len(pending), batch_size)]
    with ThreadPoolExecutor(max_workers=max_workers) as pool:
        futures = [pool.submit(embed_batch_with_retry, client, batch) for batch in batches]
        for future in as_completed(futures):
            for index, vector in future.result():
                results[index] = vector
                CACHE[make_cache_key(model, texts[index])] = vector

    return results

CACHE = {}
client = DemoEmbeddingClient()
texts = ["RAG", "chunk", "retry", "cache"]

first = batch_embed(client, texts)
print(f"first_run_vectors={len(first)} api_calls={client.calls}")

second = batch_embed(client, texts)
print(f"second_run_vectors={len(second)} api_calls={client.calls}")
print(f"order_preserved={len(second) == len(texts) and all(v is not None for v in second)}")
预期输出
first_run_vectors=4 api_calls=3
second_run_vectors=4 api_calls=3
order_preserved=True
第一次运行实际有两个批次,其中一个失败后重试,因此调用三次;第二次四条文本都命中缓存,所以调用次数保持不变。真实服务若返回 429、超时或 5xx,可重试;参数非法、模型不存在等确定性错误应立即失败,不要消耗重试额度。
把批量大小和并发当成独立旋钮
batch_size 决定单个请求装多少条输入,max_workers 决定同时有多少请求在飞。调优时先确认服务端的单请求 token、条目数和请求体大小限制,再逐步提高并发,观察限流率、P95 延迟与吞吐量,而不是只看平均速度。
让失败可以续跑
生产任务应把每个片段绑定稳定的 chunk_id,并记录状态、重试次数和最后错误。整批失败时只重试该批;接口若返回逐条失败信息,则只重试失败子集。超过上限后进入失败队列,任务继续处理其他批次,最后再集中补偿。
缓存也不要只存在进程内。长任务或离线索引构建更适合使用持久化 KV、数据库或对象存储保存“缓存键 → 向量”,这样进程重启后仍能继续复用。最终目标不是把失败隐藏掉,而是让每个片段都能明确处于“已完成、待重试或永久失败”之一。