
大模型应用开发 / 系统课时
改写用户查询
改写用户查询
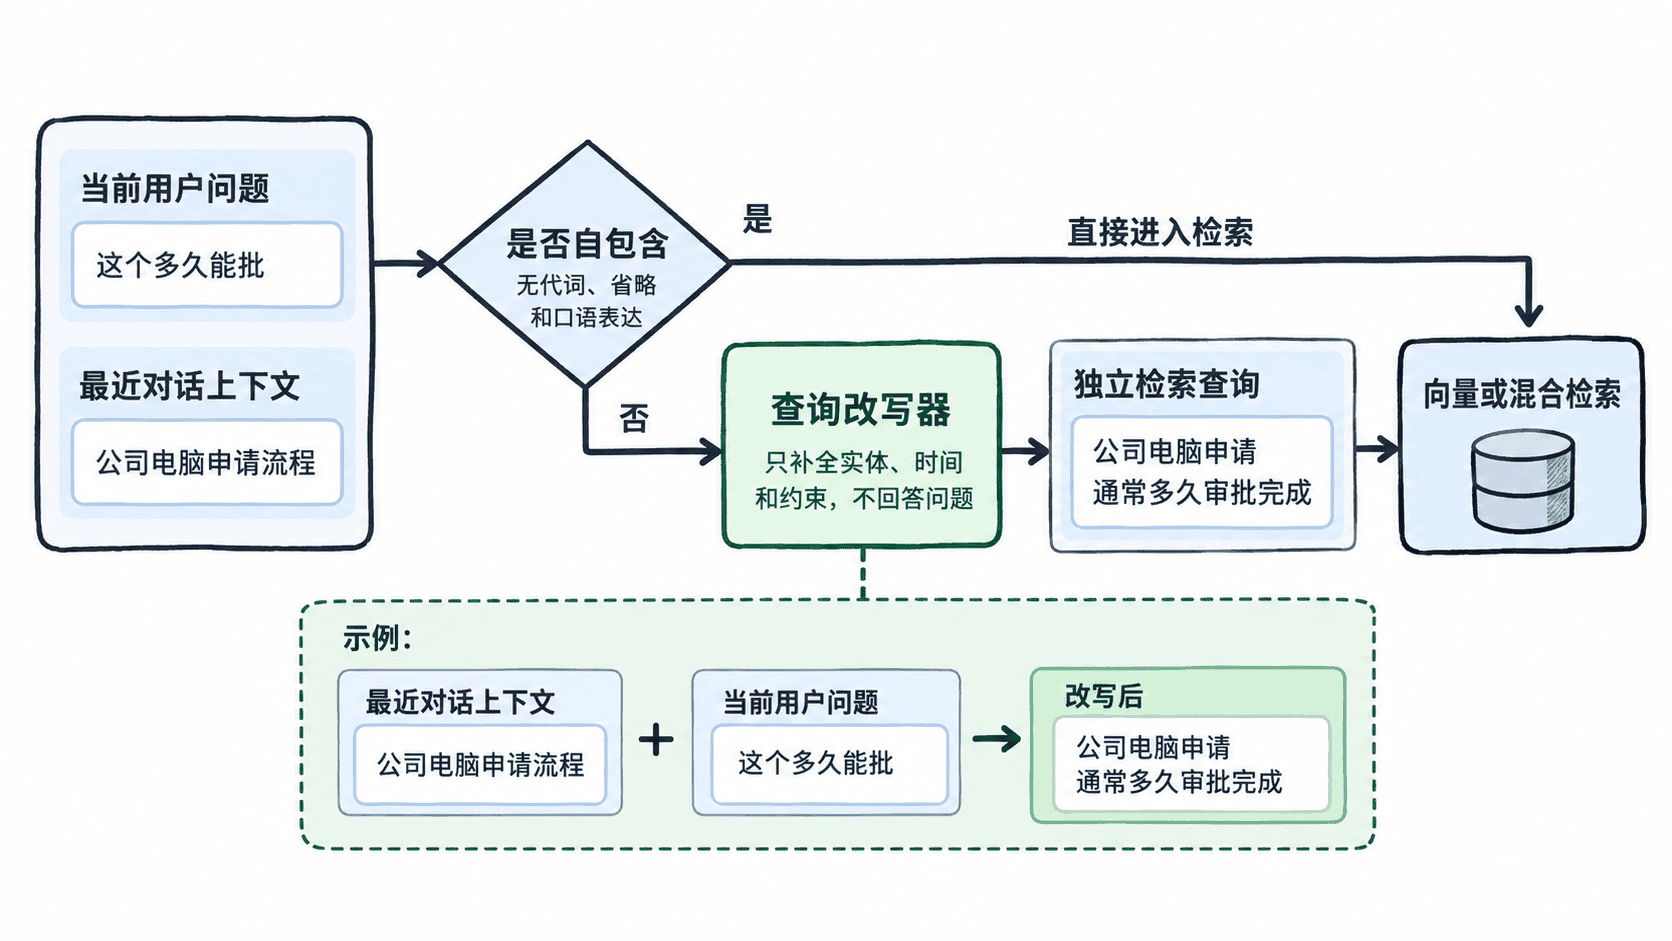
用户常用口语、省略和代词提问,例如“这个还能用吗”“那退款呢”。这些表达对人类有上下文,对检索器却信息不足。查询改写要结合最近对话补全实体和意图,同时保留原问题约束,生成可独立检索的查询文本。
学习目标
- 能识别口语、省略和上下文指代造成的检索信息缺失
- 能把当前问题与必要对话上下文改写成自包含查询
- 能避免在改写阶段擅自补充事实、答案或不存在的限制条件
判断什么时候需要改写
并非每个问题都要改写。像“PostgreSQL 逻辑复制支持哪些对象”已经足够独立,直接检索通常更稳定;而“它支持 DDL 吗”中的“它”依赖前文,就需要先解析指代。
适合改写的信号主要有三类:出现“它、这个、刚才那个”等代词;省略了关键实体,如“退款要多久”;带有明显口语表达,如“那个入职之后公司电脑咋申请”。改写后的文本应补齐检索所需实体,但不要替用户改变问题。
用可控规则建立最小版本
生产系统通常使用语言模型完成复杂改写,但先用确定性规则建立最小版本,有助于理解输入输出边界。下面的示例只处理明确指代,并保留原始意图“审批耗时”。
def rewrite_query(history_topic: str, user_query: str) -> str:
    normalized = user_query.strip()
    pronouns = ("这个", "它", "那个")

    if any(word in normalized for word in pronouns):
        normalized = normalized.replace("这个", history_topic)
        normalized = normalized.replace("它", history_topic)
        normalized = normalized.replace("那个", history_topic)

    if "多久能批" in normalized:
        normalized = normalized.replace("多久能批", "通常多久审批完成")

    return normalized

topic = "公司电脑申请"
query = "这个多久能批"
print(rewrite_query(topic, query))
预期输出
公司电脑申请通常多久审批完成关键不在替换规则本身,而在于改写后的查询已经能够脱离对话独立理解。实际使用模型时也应坚持同一边界:只重写检索表达,不生成答案,不凭空增加“30 天内”“必须主管审批”等未出现在上下文中的事实。
设计模型改写提示
模型改写器通常接收“当前问题 + 少量最近对话 + 明确约束”。提示中应要求只输出一条检索查询,并明确三条规则:保留原始意图;只补充上下文中已经出现的信息;如果当前问题本身完整,则尽量保持原样。
对话历史不要无限拼接。只保留与当前问题相关的最近若干轮,否则旧话题容易把实体带错。可以先做主题相关性筛选,再把筛出的上下文交给改写器;改写结果也可与原查询并行检索,为召回质量下降时保留回退路径。
验证改写没有偏离原意
验证时至少准备三类样例:无需改写的完整问题、依赖前文代词的问题、包含时间或权限约束的问题。检查改写后是否仍保留“本季度”“仅限研发部”“退款”等关键限制词。
线上可以同时记录原查询和改写查询的检索命中情况,对比首条相关结果、召回文档数和最终引用命中率。如果改写频繁引入错误实体,应缩短上下文窗口或提高“不得补充未知事实”的约束。稳定的查询改写不会替用户回答问题,而是把依赖上下文的表达转换为检索系统可直接理解的查询。