
大模型应用开发 / 系统课时
管理知识更新
管理知识更新
知识库不会一次导入后就永远不变。本节用内容指纹、更新时间和失效标记建立一条可重复执行的增量更新流程,让新增、修改、未变化和已删除文档都能被稳定识别,并避免每次全量重建向量索引。
学习目标
- 用内容指纹判断文档内容是否真正发生变化
- 区分新增、更新、跳过和失效四种处理动作
- 设计可重复执行且不会产生重复片段的增量导入流程
给文档建立稳定身份
增量更新的前提不是“看文件名有没有变”,而是给每份知识一个稳定的 document_id。它应来自业务主键、固定路径或外部系统 ID,而不是每次导入时随机生成。只有身份稳定,系统才能把本次数据与上次索引状态逐一对照。
每条索引状态至少保存三类信息:document_id 用于定位对象,content_hash 表示参与切分前的规范化内容,updated_at 记录来源系统声称的更新时间。更新时间适合快速筛选候选项,内容指纹负责最终确认内容是否真的变化。
判定一次增量同步
一次同步可以把来源文档与索引状态分成四类:来源新增但索引不存在时执行新增;身份相同但指纹变化时执行更新;身份和指纹都一致时跳过;索引中存在但本次来源已不存在时执行失效。
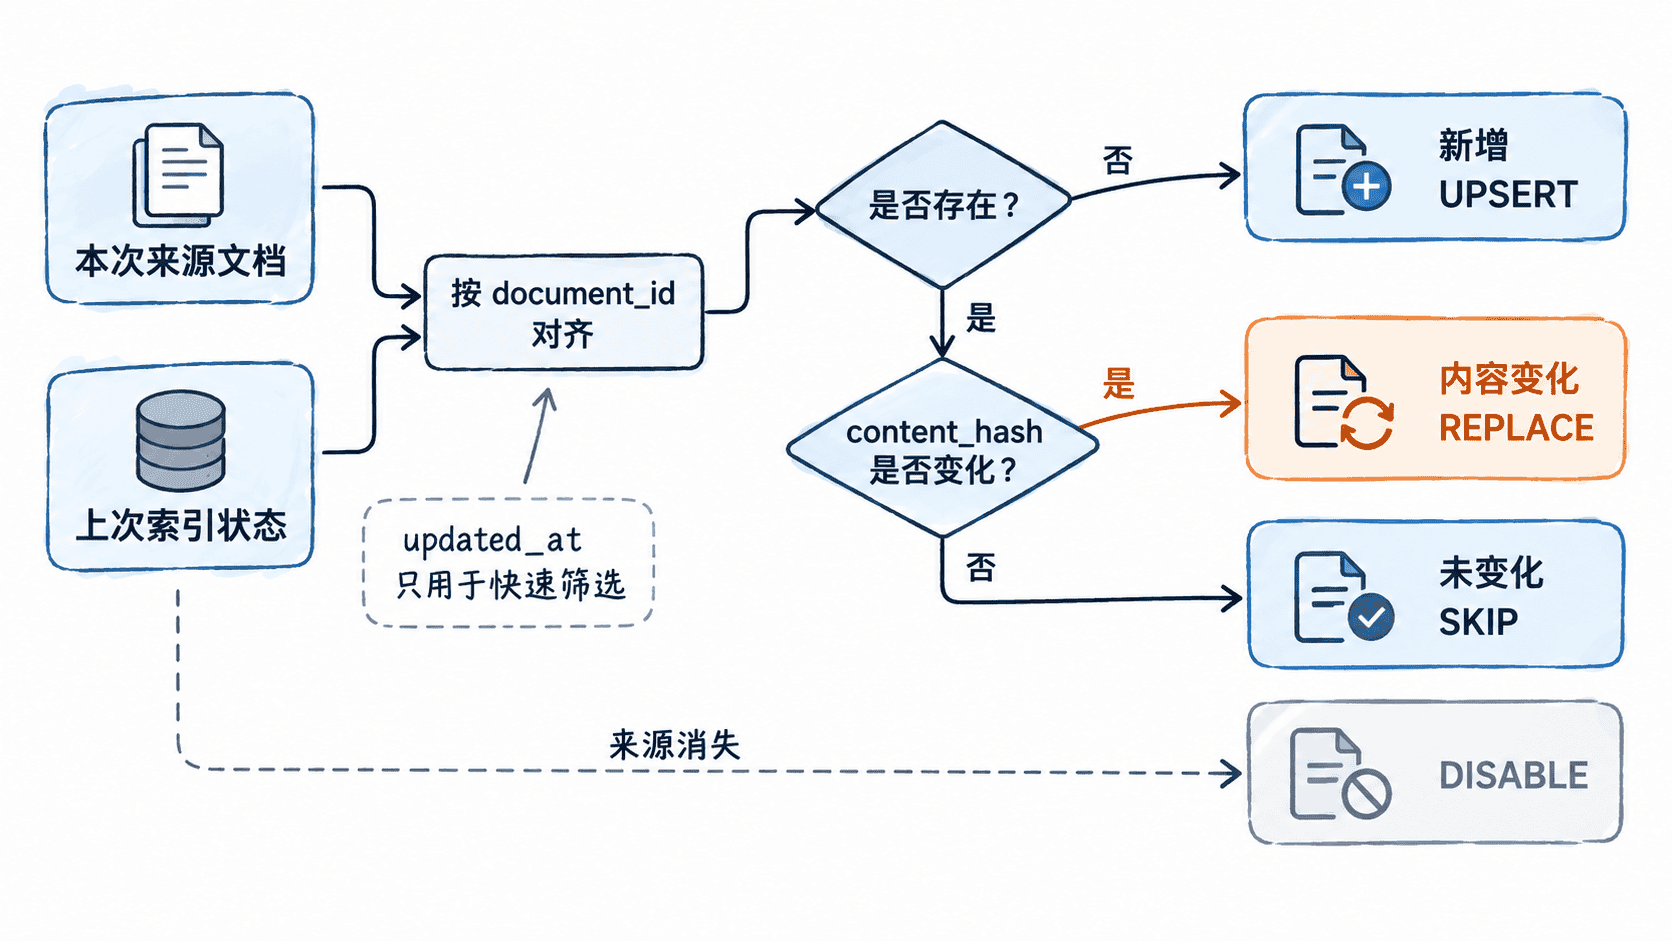
下面的最小示例只模拟“判断动作”,实际系统可把 UPSERT 接到切分、向量化和写入,把 DISABLE 接到软删除或索引失效。
import hashlib

def fingerprint(text: str) -> str:
    normalized = " ".join(text.split())
    return hashlib.sha256(normalized.encode("utf-8")).hexdigest()

indexed = {
    "doc-1": fingerprint("RAG combines retrieval and generation."),
    "doc-2": fingerprint("Old deployment guide."),
    "doc-3": fingerprint("Deprecated FAQ."),
}

current = {
    "doc-1": "RAG combines retrieval and generation.",
    "doc-2": "New deployment guide.",
}

for doc_id, content in current.items():
    new_hash = fingerprint(content)
    if doc_id not in indexed:
        action = "UPSERT"
    elif indexed[doc_id] != new_hash:
        action = "REPLACE"
    else:
        action = "SKIP"
    print(doc_id, action)

for doc_id in indexed.keys() - current.keys():
    print(doc_id, "DISABLE")
预期输出
doc-1 SKIP
doc-2 REPLACE
doc-3 DISABLE
SKIP 不应继续做切分和向量化,因为这些步骤通常最耗时;REPLACE 则应先生成新片段,再以 document_id 为范围替换旧片段。实际执行顺序可以不同,但最终状态必须满足“同一文档只保留当前有效版本”。
处理更新时避免重复片段
更新文档时最常见的问题是只追加新片段,却没有清理旧片段。这样一次召回可能同时命中新旧内容,模型会收到互相冲突的上下文。更稳妥的做法是让每个 chunk 都带上父级 document_id,并在一次更新中按父文档整体替换。
如果向量数据库支持事务或原子批处理,可以在同一批次完成“写入新片段 + 删除旧片段”;不支持时,可先写入带新版本号的片段,确认成功后再把旧版本标记为不可检索。这样即使中途失败,也不会把知识库置于半更新状态。
让删除变成可恢复的失效
来源文档消失时,直接物理删除虽然简单,但排错成本高。生产系统通常先把文档和其片段标记为 active=false,检索时过滤失效数据;确认来源确实删除且保留期结束后,再做物理清理。
最终应把一次同步设计成幂等操作:同一批数据重复运行,结果不产生额外副作用。只要稳定保存文档身份、内容指纹和有效状态,RAG 知识库就能从“全量重建”升级为可追踪、可恢复的增量维护流程。