
大模型应用开发 / 系统课时
采集网页内容
采集网页内容
本节实现一个最小网页采集器:请求页面后移除导航、广告、脚本等噪声,提取正文并过滤明显重复内容,同时保存页面 URL 与标题。最终得到的结构可以直接交给后续文本切分与索引流程。
学习目标
- 把网页采集拆成请求、清洗、正文提取和元数据保存几个明确阶段。
- 过滤导航、广告、脚本和重复区域,避免模板噪声进入向量索引。
- 保留
source与title,让召回结果能够返回原网页。
网页采集不只是下载 HTML
网页对 RAG 有价值的是正文语义和可追溯来源,而不是完整 DOM。若把菜单、页脚、推荐位和广告一起送进向量库,不同页面会反复包含相同模板文本,召回结果容易被站点导航词和公共区域污染。
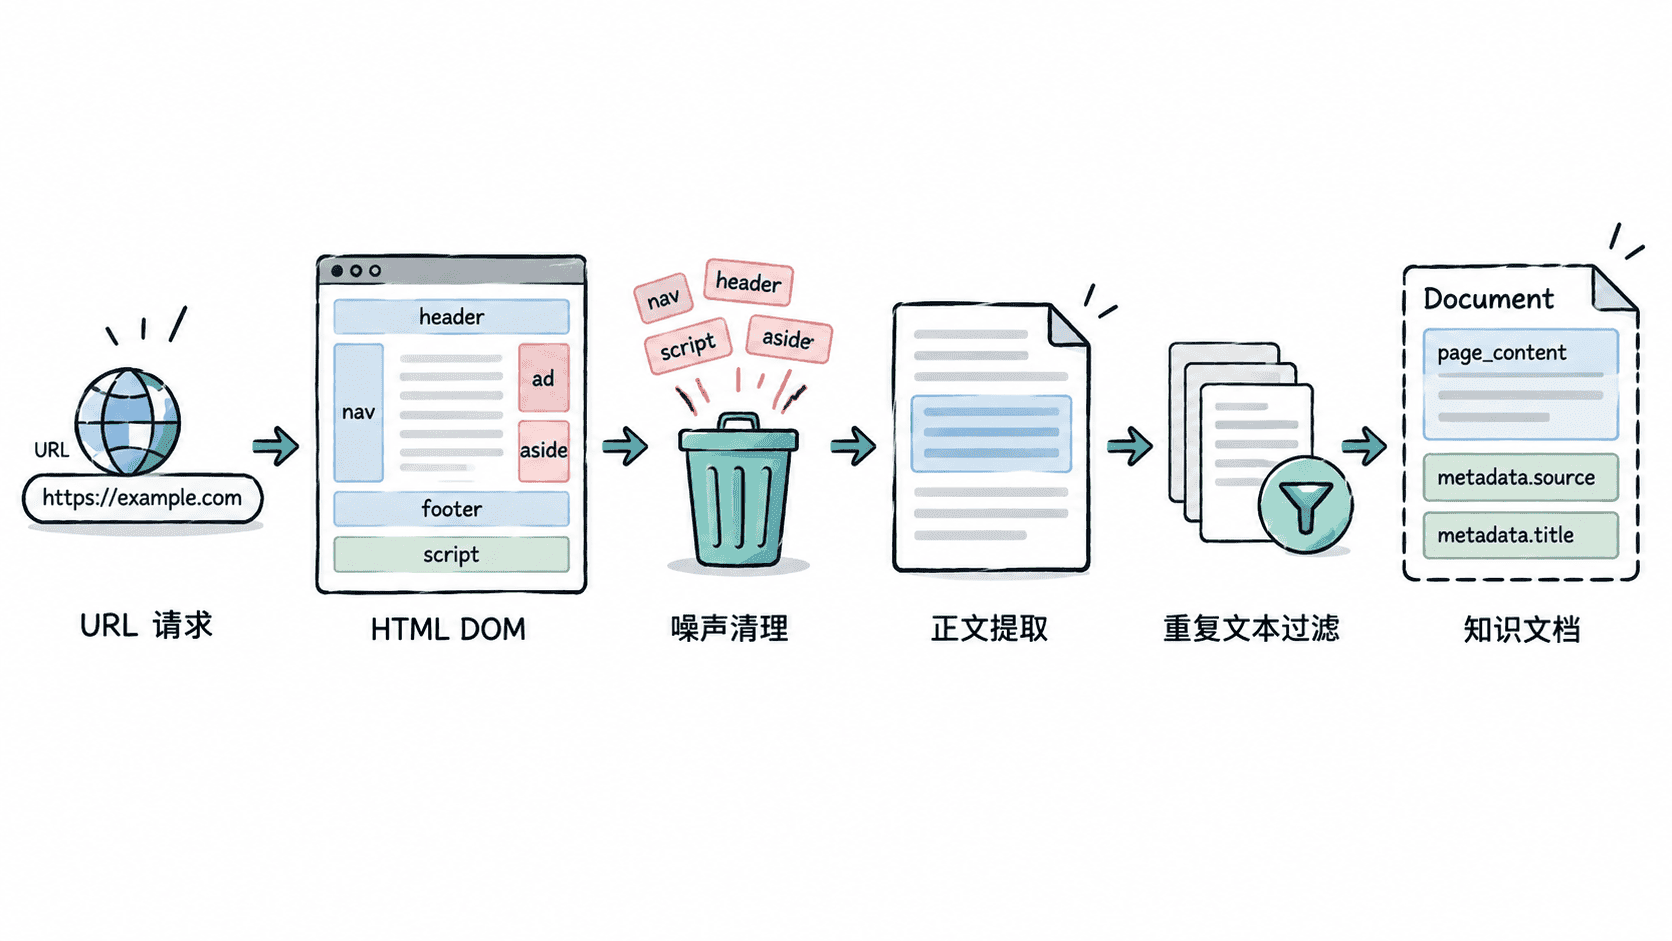
一个可靠的最小流程是先检查 HTTP 响应,再删除明确的非正文节点,优先选择 article 或 main,随后过滤完全重复的文本片段,最后保存正文和来源元数据。下面示例使用 requests 与 beautifulsoup4。
import json
import re
import sys

import requests
from bs4 import BeautifulSoup


def fetch_page(url: str):
    response = requests.get(
        url,
        timeout=10,
        headers={"User-Agent": "RAG-Study-Bot/1.0"},
    )
    response.raise_for_status()

    soup = BeautifulSoup(response.text, "html.parser")

    # 先利用 DOM 结构删除明显模板区域,避免转成纯文本后难以区分。
    selector = (
        "script, style, nav, header, footer, aside, form, noscript, "
        ".advertisement, .ads"
    )
    for node in soup.select(selector):
        node.decompose()

    title = soup.title.get_text(" ", strip=True) if soup.title else ""
    main = soup.find("article") or soup.find("main") or soup.body or soup

    # 过滤完全相同的文本片段,同时保持首次出现的阅读顺序。
    seen = set()
    parts = []
    for raw in main.stripped_strings:
        text = re.sub(r"\s+", " ", raw).strip()
        if text and text not in seen:
            seen.add(text)
            parts.append(text)

    return {
        "page_content": " ".join(parts),
        "metadata": {
            "source": response.url,
            "title": title,
        },
    }


url = sys.argv[1] if len(sys.argv) > 1 else "https://example.com"
doc = fetch_page(url)
print(json.dumps(doc["metadata"], ensure_ascii=False))
print(doc["page_content"][:120])预期结果:脚本输出最终访问地址、页面标题和清洗后的正文开头。若页面发生重定向,source 保存的是请求完成后的最终地址;正文内容会随目标页面变化。
{"source": "<VALUE>", "title": "<VALUE>"}
<VALUE>
清理顺序决定噪声是否留下
先删除 script、style、nav、header、footer、aside 等节点,再从 article 或 main 提取文本,比“先把整页转换为纯文本,再按关键词删除”更可靠。DOM 结构一旦丢失,导航与正文已经混在一起,很难准确恢复边界。
广告、推荐阅读和浮动组件没有统一标签。对于固定站点,可以补充经过验证的 CSS 选择器;面对多个站点,则应把清理规则做成站点级配置,并持续抽样检查,避免选择器过宽而误删正文。
处理重复内容与动态页面
重复通常来自两类情况:同一页面内部出现模板化重复文本,以及多个 URL 指向相同或近似正文。前者可以在解析阶段过滤,后者更适合在入库前根据规范化 URL 或正文哈希去重,否则相同内容会占据多个向量位置,放大单一来源的召回权重。
如果目标站点主要依靠 JavaScript 渲染,requests 得到的初始 HTML 可能没有正文。此时可以改用浏览器自动化或站点提供的正式 API,但输出仍应归一化为相同的 page_content 与 metadata 结构,让切分、向量化和检索层不依赖具体采集技术。
最后随机抽查页面正文是否完整、导航是否消失、标题是否正确、source 是否能够定位原页面。把这四项作为入库门槛,比只检查 HTTP 请求是否成功更能保证网页知识的可检索质量。