
大模型应用开发 / 系统课时
生成多个检索查询
生成多个检索查询
单个检索查询往往只能覆盖复杂问题的一种表达。本节把一个问题拆成多个语义互补的查询,分别召回候选文档,再按文档标识合并去重,最终得到覆盖更广且不重复的 RAG 检索结果。
学习目标
- 能判断哪些复杂问题适合生成多个检索查询
- 能实现多路召回并按文档标识去重
- 能控制查询数量、重复度和结果融合方式
复杂问题为什么要拆成多个查询
用户问题可能同时包含对象、条件和目标,例如既问“怎样提升 RAG 召回”,又隐含“查询改写”和“结果融合”。如果只生成一个向量,检索器容易偏向其中一种表达,遗漏使用不同术语描述的文档。
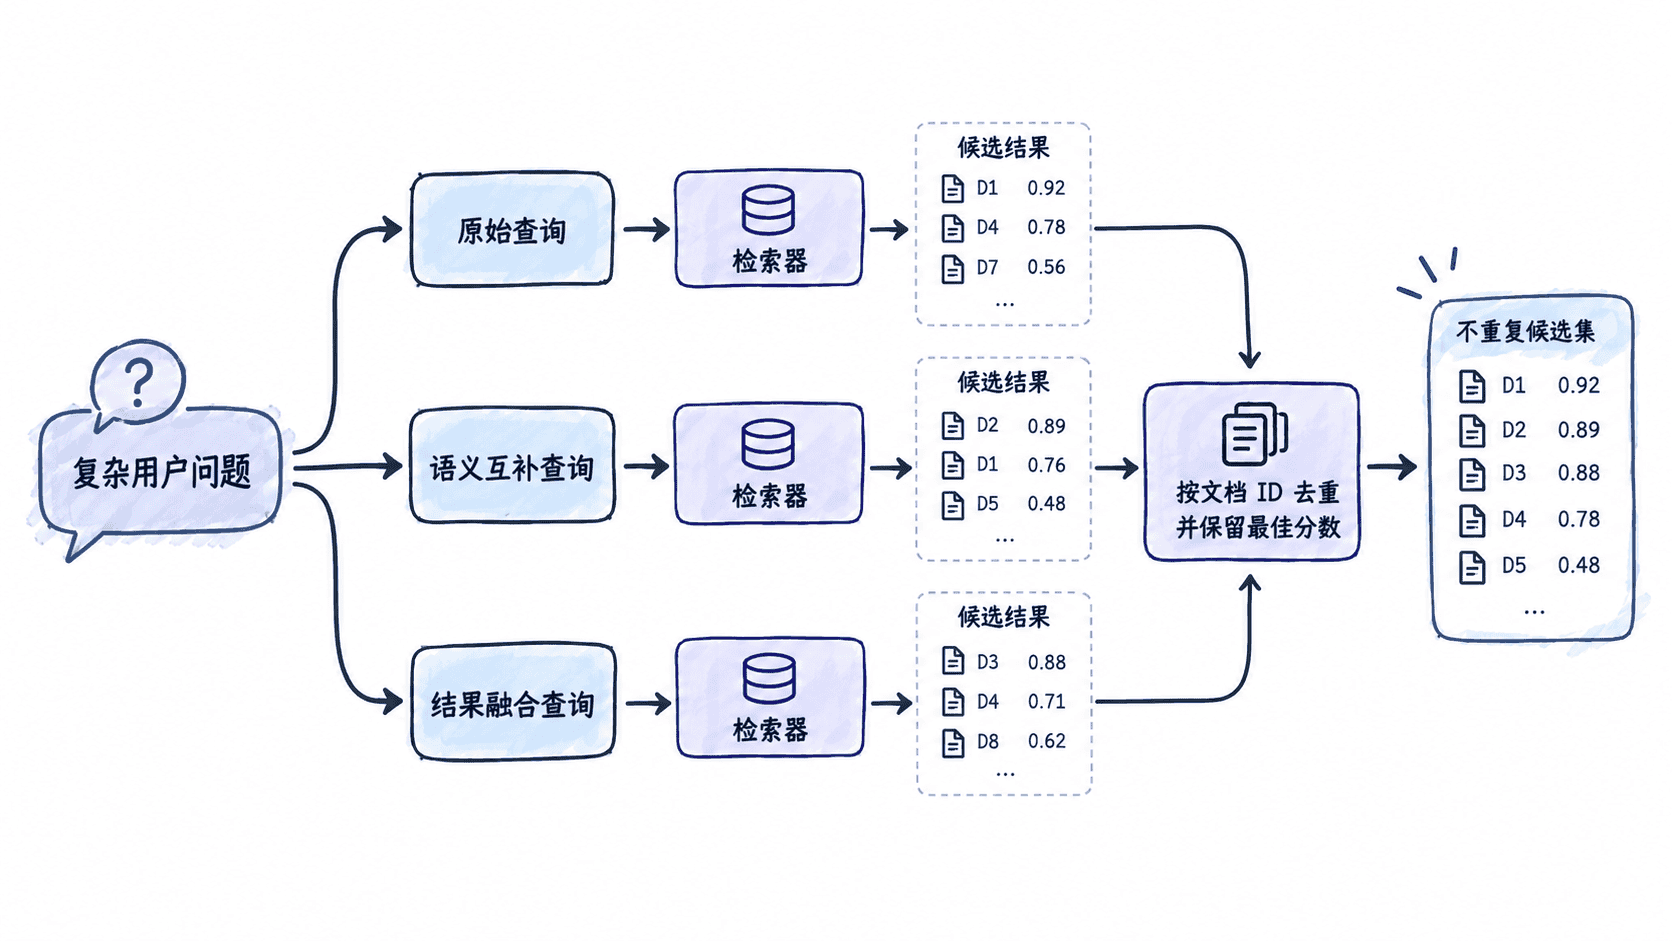
多查询检索的关键不是生成大量同义句,而是让各查询承担不同检索角度。通常应保留原问题,再补充少量互补查询;这样既不会丢掉用户的显式限制,又能扩大词汇和语义覆盖。各路召回后必须统一去重,否则同一文档会因多次命中挤占上下文窗口。
实现多查询召回与融合
下面用纯 Python 演示完整链路。为了让示例无需外部模型即可运行,generate_queries 使用固定的互补改写;生产环境可以把这一函数替换为模型调用,而后面的并行检索、去重和排序逻辑保持不变。示例使用字符集合重叠作为简化相似度,只用于说明控制流,不代表真实向量检索质量。
DOCS = [
    {"id": "d1", "text": "RAG 检索质量取决于查询表达、召回范围和重排序策略"},
    {"id": "d2", "text": "多查询检索会把一个复杂问题改写成多个语义互补的检索查询"},
    {"id": "d3", "text": "结果融合时应按文档标识去重,并保留每个文档的最佳相关度"},
    {"id": "d4", "text": "父子文档检索使用小片段匹配,再返回更大的父文档上下文"},
]

def chars(text):
    ignored = set(",。!?、:;()() ")
    return {ch.lower() for ch in text if ch.strip() and ch not in ignored}

def similarity(query, text):
    q = chars(query)
    return len(q & chars(text)) / max(len(q), 1)

def generate_queries(question):
    # 保留原问题,再补充两个承担不同检索角度的查询。
    return [
        question,
        "多查询改写如何获得语义互补结果",
        "多路检索结果怎样合并去重",
    ]

def search(query, top_k=2):
    ranked = sorted(
        ({"id": doc["id"], "score": similarity(query, doc["text"])} for doc in DOCS),
        key=lambda item: item["score"],
        reverse=True,
    )
    return ranked[:top_k]

def merge_hits(hit_groups):
    best = {}
    for hits in hit_groups:
        for hit in hits:
            old = best.get(hit["id"])
            # 同一文档被多路命中时,只保留它的最高相关度。
            if old is None or hit["score"] > old["score"]:
                best[hit["id"]] = hit
    return sorted(best.values(), key=lambda item: item["score"], reverse=True)

question = "RAG 复杂问题如何提升检索召回"
queries = generate_queries(question)
merged = merge_hits([search(query) for query in queries])

print("queries:")
for query in queries:
    print("-", query)
print("merged:")
for hit in merged:
    print(hit["id"], f'{hit["score"]:.2f}')
预期输出
queries:
- RAG 复杂问题如何提升检索召回
- 多查询改写如何获得语义互补结果
- 多路检索结果怎样合并去重
merged:
d2 0.60
d3 0.50
d1 0.47
三路检索都可能命中 d2,但融合后只保留一次;d1、d3 则分别补足“召回质量”和“结果去重”两个角度。真实系统中通常把 search 换成向量库或混合检索接口,并让每条查询并发执行,以降低额外查询带来的延迟。
控制查询数量与融合策略
查询越多并不一定越好。优先让生成器输出少量互补查询,并限制每路 top_k;如果新查询只是原问题的同义改写,增加的往往是重复召回和调用成本,而不是有效覆盖。生成查询时还应保留产品名、版本号、时间范围等不可丢失的约束。
当各路结果来自同一种检索器且分数尺度一致时,可以像示例一样按文档 ID 保留最高分;如果结果来自向量检索、关键词检索等不同评分体系,更适合按名次做融合,再进入统一重排序阶段。
多查询检索最适合意图较复杂、术语表达不稳定或单路召回经常漏文档的问题;对于明确的 ID 查询、精确关键词查询或本来就很短的事实问题,直接检索通常更快也更稳定。