
大模型应用开发 / 系统课时
优化响应性能
优化响应性能
RAG 响应慢通常不是单点问题,而是检索、重排、模型生成和并发排队共同叠加。本课把优化顺序收敛为“先测量、再减少重复工作、再并发、最后做模型分级”,并给出一个可运行的最小示例验证缓存、并发控制与模型路由。
学习目标
- 能按检索、生成和排队三个阶段定位主要耗时
- 能用缓存、并发控制和批处理减少重复等待
- 能根据请求复杂度选择不同模型档位
先拆分延迟预算
先记录端到端耗时,再分别统计检索、重排和模型生成耗时。若不先拆分,直接加缓存或提高并发可能只是在移动瓶颈。优化时优先处理占比最高且可重复消除的阶段,例如重复查询的检索结果、固定系统提示词和可复用的嵌入结果。
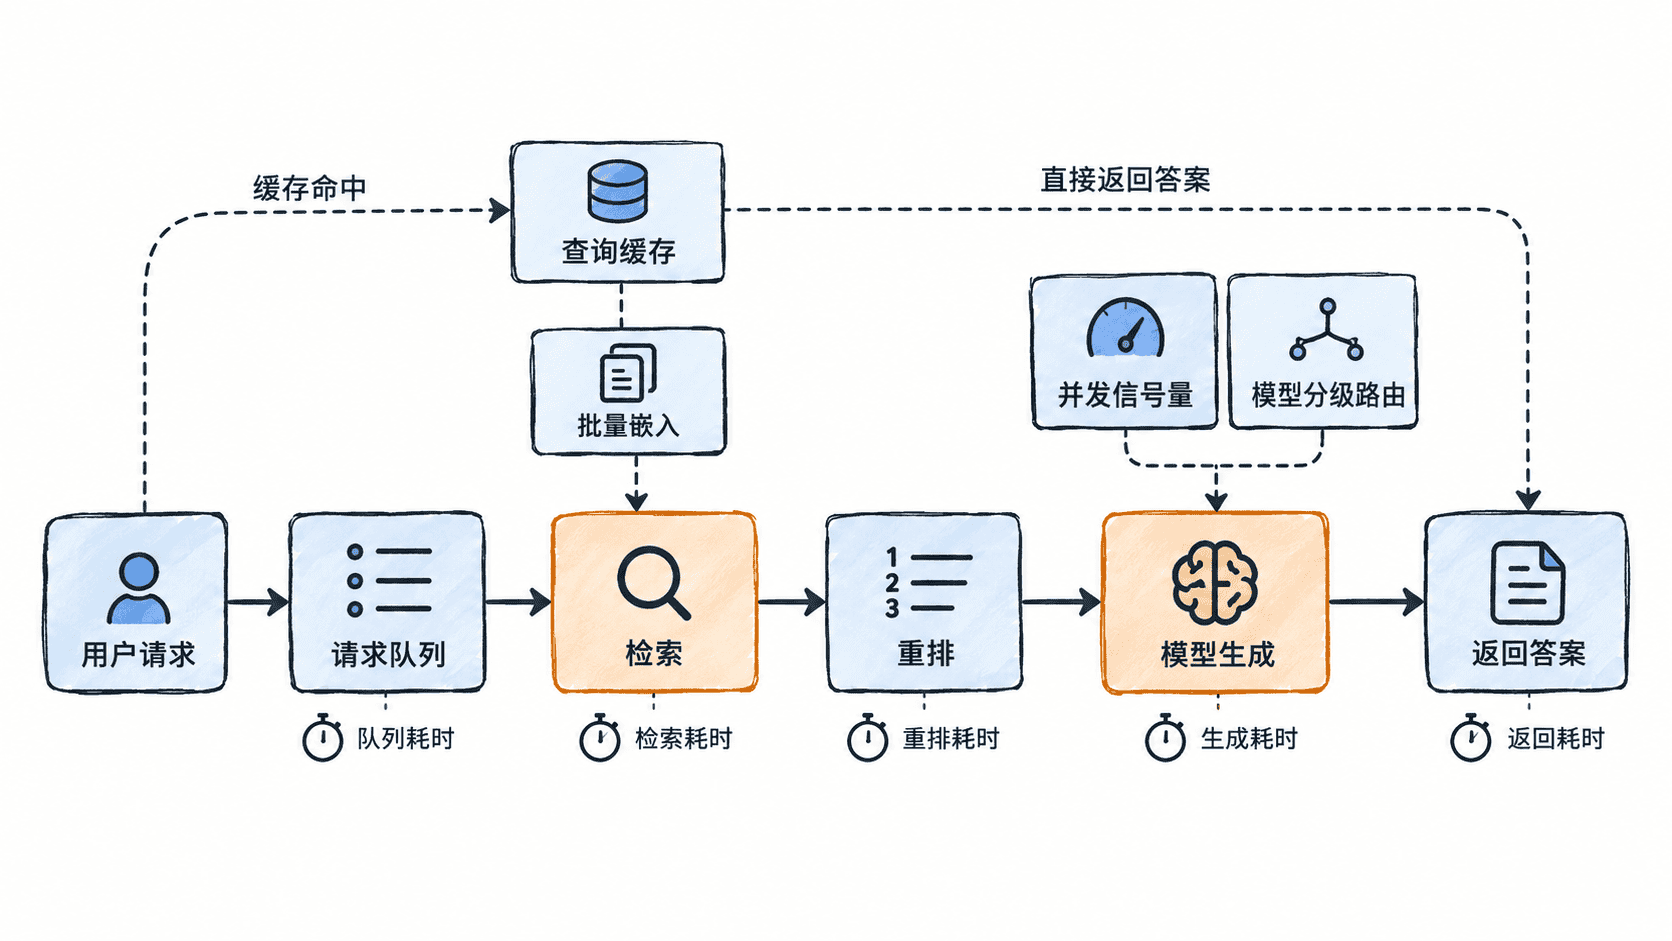
把四种优化放到正确位置
缓存适合“相同输入得到相同或近似结果”的环节,常见对象包括查询改写、检索结果和嵌入向量。批处理适合一次提交多个可独立计算的输入,减少网络往返和模型调用固定开销。并发控制不是越大越好,应通过信号量限制同时在途的检索或模型请求,避免把下游服务压垮。
模型分级应基于可解释规则,例如上下文长度、任务类型或置信度。简单问答走低延迟模型,复杂综合任务再升级到更强模型。这样能降低平均延迟和成本,同时避免所有请求都走最昂贵路径。
运行一个最小优化器
下面的示例只用 Python 标准库模拟检索和生成:同一查询第二次会命中缓存;批量请求通过 asyncio.gather 并发执行;Semaphore 限制最多两个生成任务同时运行;上下文较长时自动切换到 large 档模型。
import asyncio

cache = {}
model_gate = asyncio.Semaphore(2)

async def retrieve(query: str) -> list[str]:
    await asyncio.sleep(0.05)
    return [f"doc:{query}"]

async def generate(query: str, docs: list[str]) -> str:
    model = "large" if sum(map(len, docs)) > 20 else "small"
    async with model_gate:
        await asyncio.sleep(0.05)
        return f"{query}|model={model}|docs={len(docs)}"

async def answer(query: str) -> str:
    if query in cache:
        return f"cache_hit=True|{cache[query]}"

    docs = await retrieve(query)
    result = await generate(query, docs)
    cache[query] = result
    return f"cache_hit=False|{result}"

async def main() -> None:
    first = await asyncio.gather(answer("vector"), answer("rerank"))
    second = await answer("vector")
    print(*first, second, sep="\n")

asyncio.run(main())
预期输出:
cache_hit=False|vector|model=small|docs=1
cache_hit=False|rerank|model=small|docs=1
cache_hit=True|vector|model=small|docs=1
实际耗时会随机器与下游服务变化,应记录为 <TIME>,不要把示例中的睡眠时间当作真实性能基线。
验证优化是否真的有效
验证时至少比较优化前后的 P50、P95、错误率和吞吐量,而不是只看单次请求。缓存命中率提升但 P95 不降,往往说明瓶颈在生成或排队;并发提高后错误率上升,则说明已经越过下游服务可承受的并发点。
优化顺序应保持可回滚:先建立分阶段基线,再启用缓存和批处理,然后逐级调大并发,最后引入模型分级。每次只改变一类变量,才能判断收益来自哪里。