
大模型应用开发 / 系统课时
实现流式回答
实现流式回答
RAG 回答较长时,等模型完整生成再返回会放大首字延迟,也难以及时响应用户取消。本节用 SSE 把答案分片、引用和结束状态拆成事件,并补齐连接中断、服务端异常与客户端拼装规则。
学习目标
- 设计
token、citation、done、error四类流事件。 - 用 SSE 持续向客户端发送模型增量,并在断连时停止写入。
- 将正文增量与引用元数据分开传输,再在客户端形成最终答案状态。
先定义流事件协议
流式接口不要直接输出一串无法区分边界的文本。客户端至少要知道当前收到的是答案增量、引用、正常结束还是错误,因此可以把每个 SSE 事件设计成独立类型。
| 事件 | 作用 |
|---|---|
token |
追加一段答案文本 |
citation |
合并引用元数据,不直接写进正文 |
done |
标记本次生成正常结束 |
error |
标记生成失败,客户端停止等待后续内容 |
引用事件最好传稳定的文档或片段 ID,而不是让模型在自然语言中自己拼脚注。这样客户端可以去重、排序,并把引用样式与正文生成解耦。
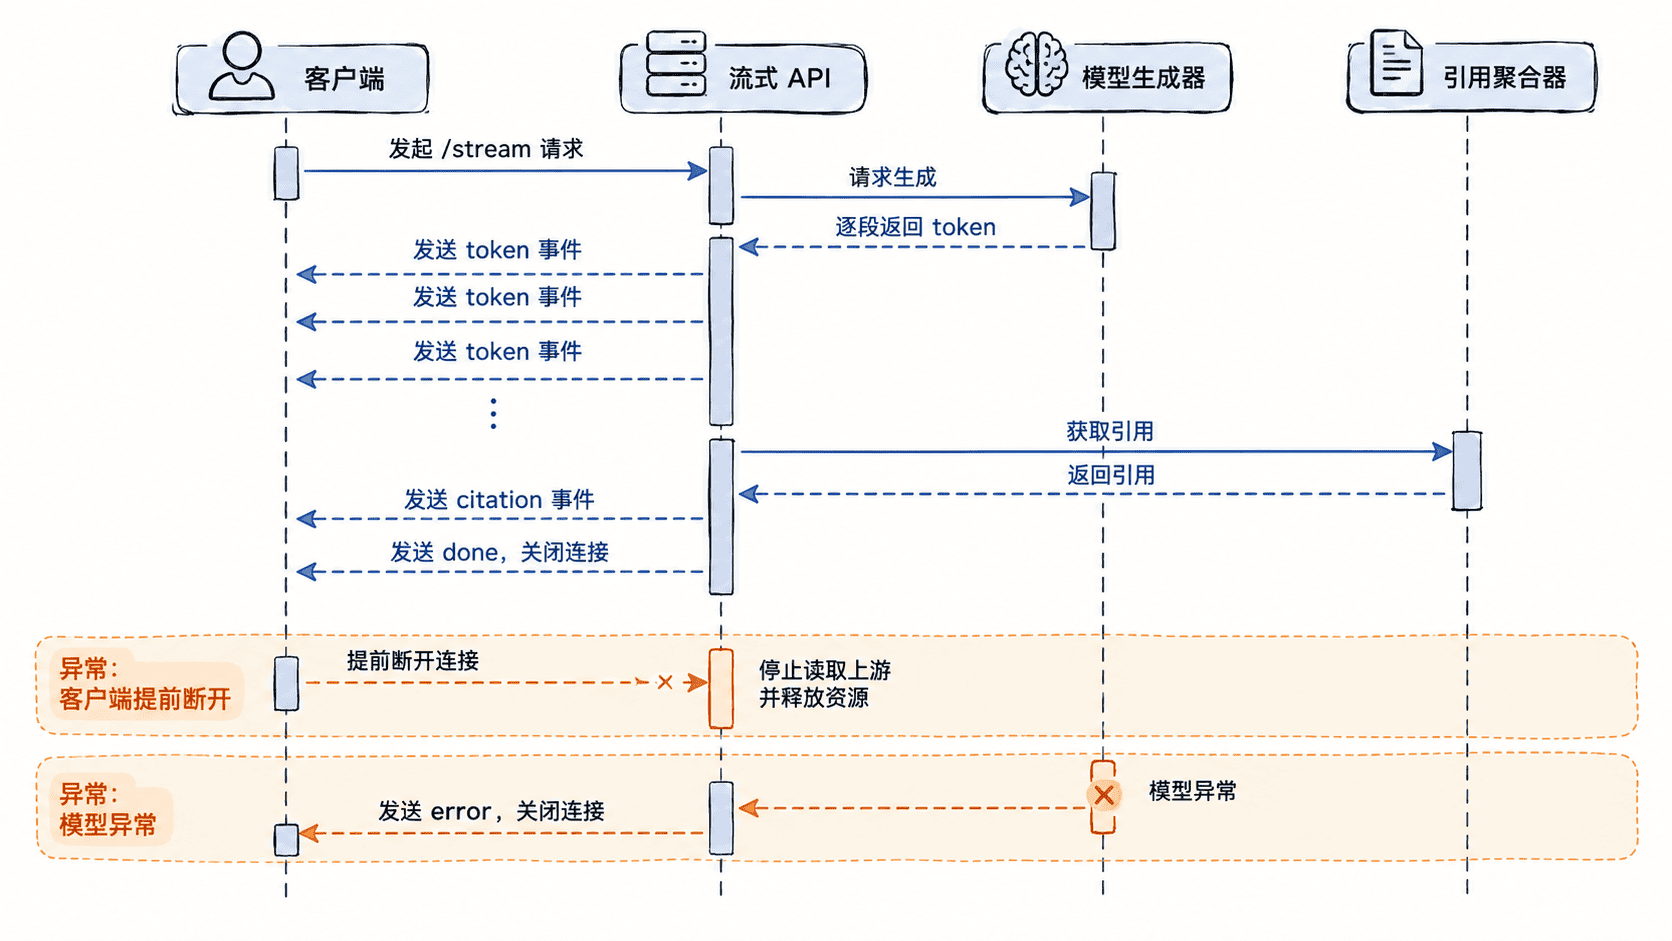
用 SSE 输出可中断的数据流
下面示例只使用 Python 标准库,模拟模型逐段产生文本。每次写入后立即 flush,让客户端尽快看到增量;如果客户端已经关闭连接,写入会触发异常,服务端直接结束本次请求。
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
import json
import time

def encode_event(name: str, payload: dict) -> bytes:
    data = json.dumps(payload, ensure_ascii=False, separators=(",", ":"))
    return f"event: {name}\ndata: {data}\n\n".encode("utf-8")

class StreamHandler(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"

    def log_message(self, format: str, *args) -> None:
        pass

    def do_GET(self) -> None:
        if self.path != "/stream":
            self.send_error(404)
            return

        self.send_response(200)
        self.send_header("Content-Type", "text/event-stream; charset=utf-8")
        self.send_header("Cache-Control", "no-cache")
        self.end_headers()

        try:
            for token in ["RAG ", "答案 ", "完成。"]:
                self.wfile.write(encode_event("token", {"delta": token}))
                self.wfile.flush()
                time.sleep(0.15)

            citations = {"items": [{"id": "doc-17", "chunk": "c3"}]}
            self.wfile.write(encode_event("citation", citations))
            self.wfile.write(encode_event("done", {"finishReason": "stop"}))
            self.wfile.flush()
        except (BrokenPipeError, ConnectionResetError):
            print("client disconnected")
        except Exception as exc:
            print(f"stream error: {exc}")
            try:
                self.wfile.write(
                    encode_event("error", {"message": "stream failed"})
                )
                self.wfile.flush()
            except (BrokenPipeError, ConnectionResetError):
                pass
        finally:
            self.close_connection = True

if __name__ == "__main__":
    server = ThreadingHTTPServer(("127.0.0.1", 8000), StreamHandler)
    print("listening on http://127.0.0.1:8000/stream", flush=True)
    server.serve_forever()
预期输出
listening on http://127.0.0.1:8000/stream服务启动后,用关闭缓冲的 curl 观察事件是否逐段到达。
curl -N http://127.0.0.1:8000/stream预期输出
event: token
data: {"delta":"RAG "}

event: token
data: {"delta":"答案 "}

event: token
data: {"delta":"完成。"}

event: citation
data: {"items":[{"id":"doc-17","chunk":"c3"}]}

event: done
data: {"finishReason":"stop"}
这里的端口固定为示例中的 8000;若你修改监听配置,实际端口也应同步调整客户端请求。
客户端按事件类型拼装状态
客户端维护两个独立容器即可:answer 只追加 token.delta,citations 只接收 citation.items 并按 ID 去重。收到 done 后再把当前状态标记为完成;收到 error 时停止加载状态,但保留已经展示的部分文本,是否允许重试由产品策略决定。
不要把 citation 当作普通文本片段拼进答案,否则引用显示格式、去重和点击跳转都会被模型输出绑死。引用 ID 还应在服务端发送前再次确认属于本次检索上下文,避免流式传输把错误引用更快地暴露给客户端。
断连和异常必须关闭上游
真实模型 SDK 通常提供可取消的流对象、生成器或请求上下文。客户端断开后,除了停止 wfile.write,还应立即关闭上游模型流,避免用户已经离开而服务端仍继续消耗推理资源。
异常路径也要保持协议一致:连接仍可写时发送一次 error,随后关闭;连接已经断开时只做日志和资源回收,不要反复尝试写错误消息。只要事件类型、终止条件和引用拼装边界固定,客户端就能稳定处理正常完成、失败和主动取消三种结果。