
大模型应用开发 / 系统课时
处理无结果查询
处理无结果查询
RAG 最危险的失败不是“没有结果”,而是检索不到可靠证据时仍继续生成一个看似完整的答案。本节把无召回、低相关度和正常命中分开处理,让系统在证据不足时主动澄清或明确表示未知。
学习目标
- 区分无召回与低相关度两类无结果查询
- 使用可校准阈值决定回答、澄清或返回未知
- 验证无结果分支不会把低质量上下文继续交给生成模型
先区分两种失败
“没有任何候选片段”和“有候选但都不够相关”不是同一个问题。前者常见于过滤条件过严、知识库确实缺资料或查询表达与索引完全错位;后者说明检索器勉强找到了相似文本,但没有足够证据支撑回答。
因此判断不能只写成 if not documents。系统至少还要检查重排序后的最高相关度、有效片段数量,以及必要时的业务过滤结果。只有达到证据门槛,才允许进入答案生成阶段。
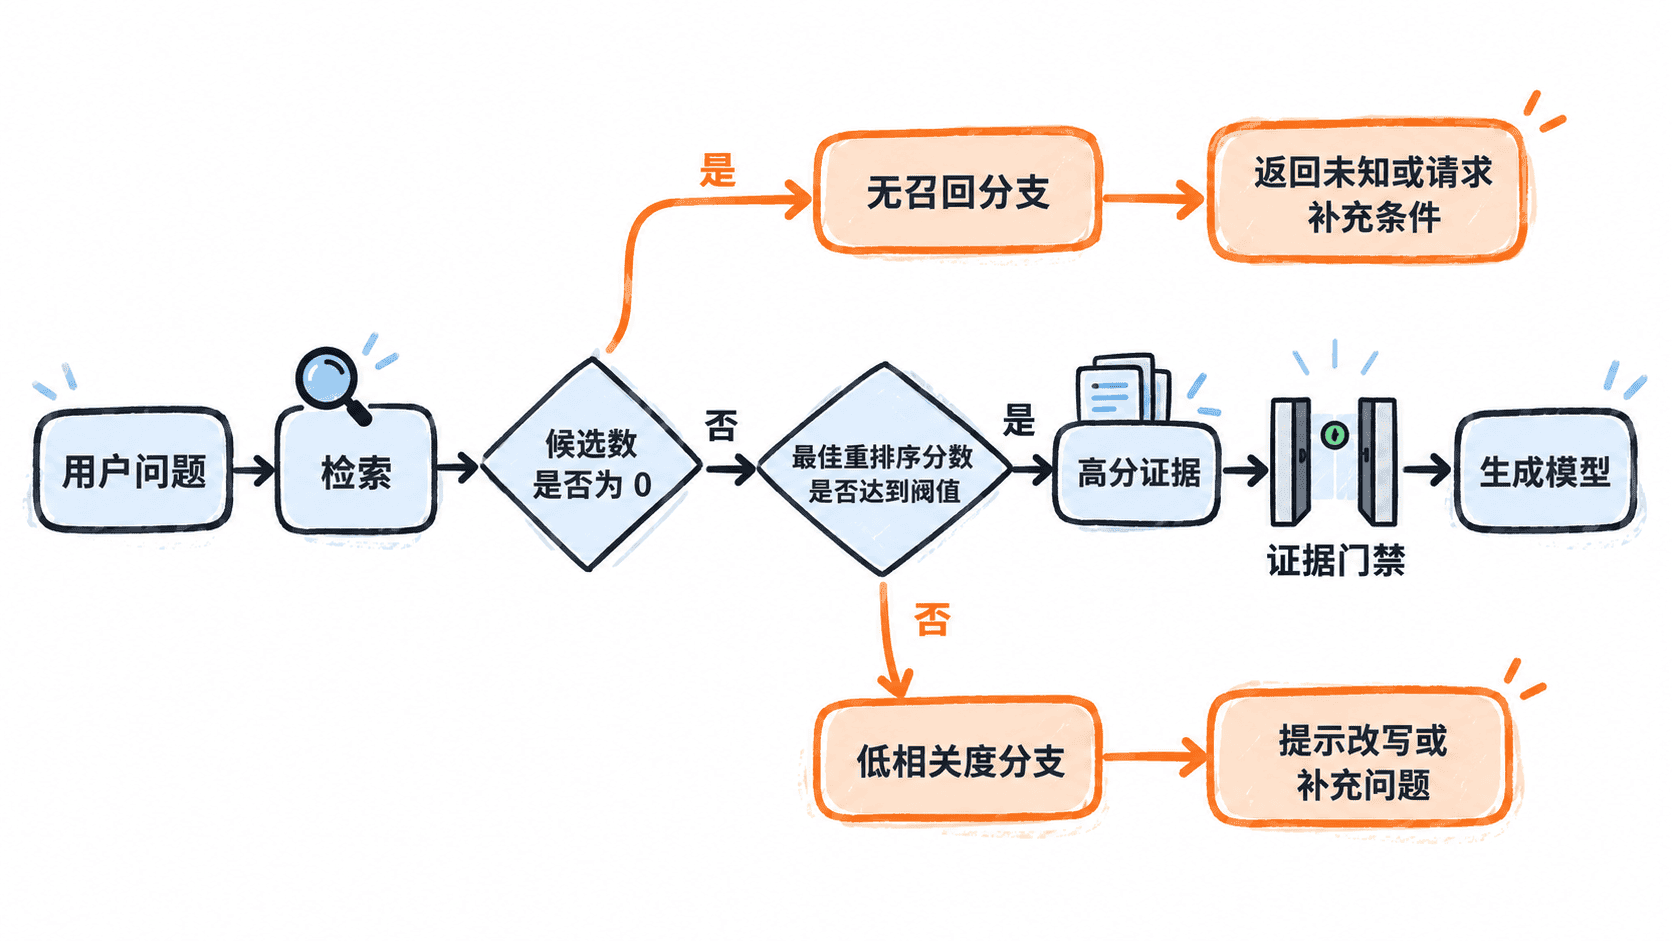
用证据门禁阻止猜测
下面的示例把检索结果数量和最佳相关度分开判断。分数只用于演示控制流,生产阈值必须通过自己的标注数据校准,不能把示例中的 0.45 当作通用标准。
from dataclasses import dataclass

@dataclass
class RetrievalState:
    candidate_count: int
    best_score: float

def decide(state: RetrievalState, min_score: float = 0.45) -> str:
    # 无候选表示召回链路没有提供任何可用证据。
    if state.candidate_count == 0:
        return "NO_RECALL"
    # 有候选仍需过相关度门槛,避免把弱相关文本交给生成模型。
    if state.best_score < min_score:
        return "LOW_RELEVANCE"
    return "ANSWER"

samples = [
    RetrievalState(candidate_count=0, best_score=0.0),
    RetrievalState(candidate_count=5, best_score=0.31),
    RetrievalState(candidate_count=5, best_score=0.82),
]

for sample in samples:
    print(decide(sample))
预期输出
NO_RECALL
LOW_RELEVANCE
ANSWER这三个状态应映射到不同响应:ANSWER 才调用生成模型;NO_RECALL 应明确说明知识库中没有找到依据;LOW_RELEVANCE 更适合提示用户补充实体、时间范围、产品版本或其他限定条件。
设计用户可执行的反馈
无结果提示不能只说“搜索失败”。好的反馈要告诉用户下一步能做什么,同时避免暴露内部阈值或模型细节。例如可以回答:“我暂时没有从知识库找到足够相关的依据。请补充产品名称、版本或具体报错,我再继续检索。”
如果问题本身含糊,应优先请求澄清;如果问题很明确但知识库确实没有覆盖,应直接返回未知;如果业务允许访问其他受控数据源,可以把“扩大数据源”作为独立策略,但必须重新经过同样的证据门禁,不能因为一次无结果就自动信任任意外部内容。
校准阈值而不是猜阈值
相关度阈值需要来自真实查询集。准备“可回答”和“不可回答”两类样本,记录每个问题的最高重排序分数,再观察两类分布的重叠区域。阈值过低会把弱相关片段当证据,阈值过高则会让大量本可回答的问题进入未知分支。
评估时至少同时看两项指标:错误放行率,即本不该回答却进入 ANSWER 的比例;错误拒绝率,即本可回答却被判为无结果的比例。对客服、医疗知识库或合规问答等高风险场景,通常更应优先压低错误放行率。
验证无结果分支
测试集至少覆盖三种情况:过滤后完全无候选、存在弱相关候选、存在明显高相关候选。除了检查返回状态,还要确认 NO_RECALL 和 LOW_RELEVANCE 分支不会调用生成模型,并记录用户是否通过补充条件成功转为可回答状态。
当无结果比例突然升高时,先检查索引是否更新、过滤字段是否变化、查询改写是否异常,再检查阈值。把“证据不足”变成显式状态后,系统才能把未知当作正常结果处理,而不是用语言流畅度掩盖检索失败。