
大模型应用开发 / 系统课时
实现混合检索
实现混合检索
单独使用向量检索可能漏掉错误码和产品编号,只用关键词又容易错过同义表达。本篇把两条召回链路合并,并用加权 RRF 按排名融合候选,让语义相关性与精确词命中同时参与最终排序。
学习目标
- 理解向量召回与关键词召回在混合检索中的分工
- 使用文档 ID 去重并通过排名融合生成统一候选集
- 根据业务目标调整两路检索权重和候选数量
为什么要保留两条召回链路
向量检索根据语义相似度找到表达不同但含义接近的内容,关键词检索则对 P-1002、函数名和错误码等字面信号更敏感。混合检索不是先任选一种,而是让同一个查询同时进入两套检索器,再统一处理两边返回的候选。
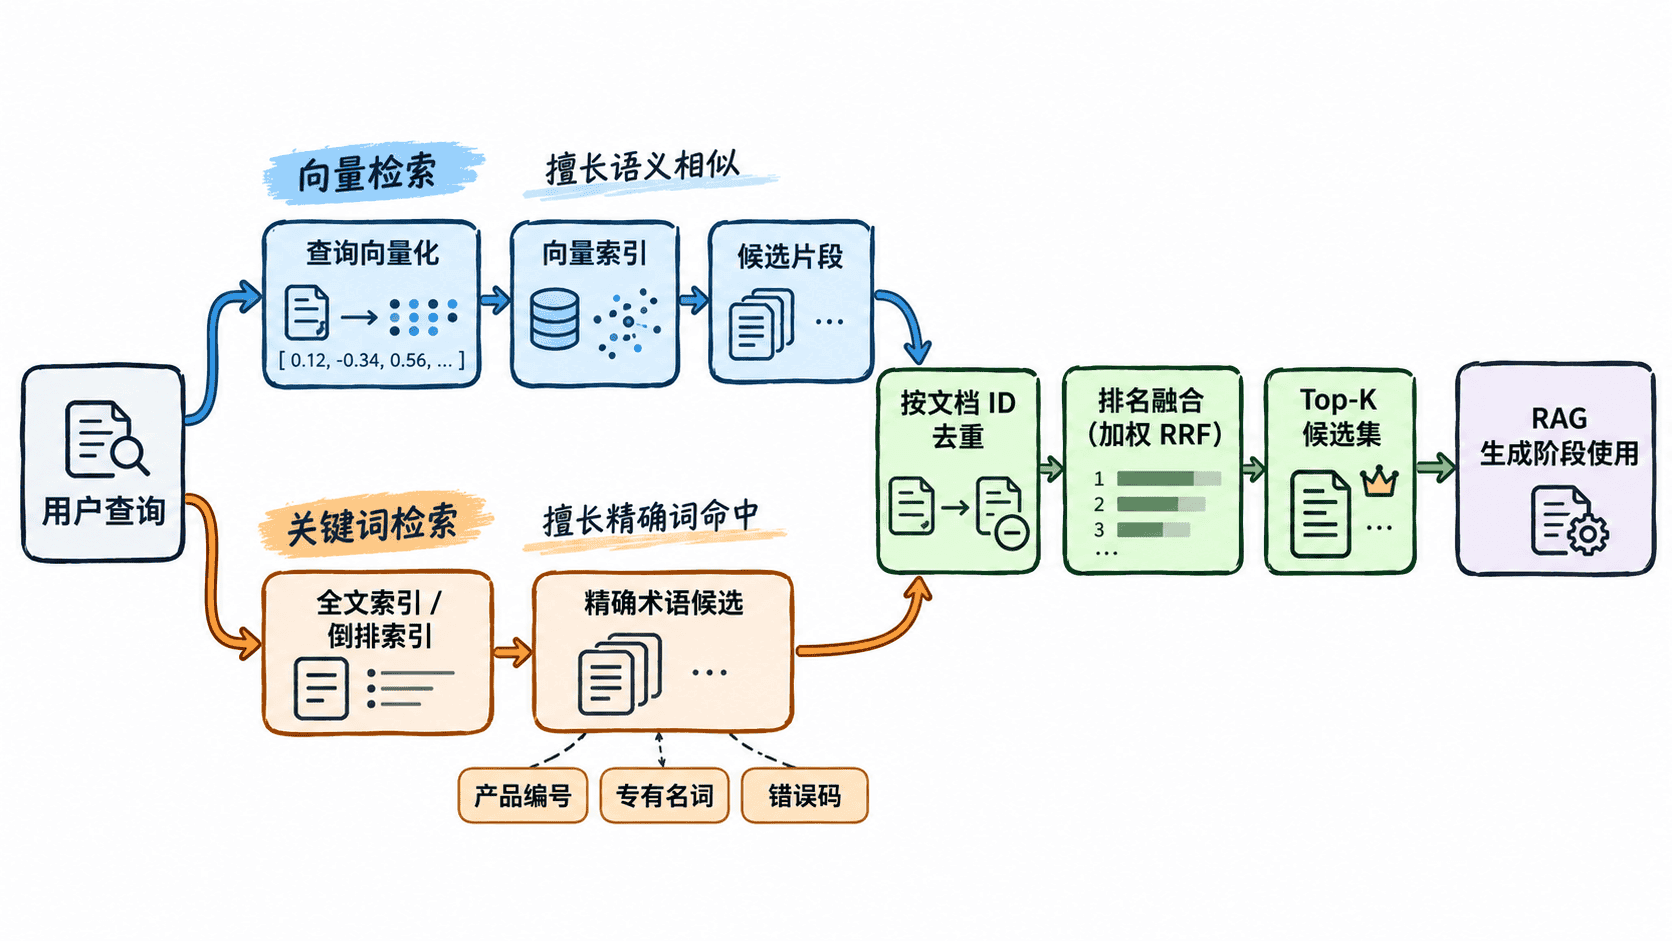
两套检索器的原始分数通常不能直接相加。例如余弦相似度可能落在 0 到 1 附近,而 BM25 的数值范围和方向完全不同。直接相加会让某一路因为分数量纲而占据优势,因此实际系统常先做分数归一化,或者像本篇一样直接融合排名。
用加权 RRF 融合排名
RRF 的核心思想是只关注文档在各检索器中的名次。文档排名越靠前,获得的贡献越大。加权版本还能控制语义召回和关键词召回的重要程度。
下面的完整示例用余弦相似度模拟向量检索,用产品编号和关键词命中数模拟关键词检索,然后按照文档 ID 合并结果。示例中的二维向量只为展示融合过程;真实应用应替换为嵌入模型和向量数据库返回的候选。
from math import sqrt

DOCS = [
    {"id": "d1", "text": "P-1002 connection timeout reset steps", "vec": [0.95, 0.10]},
    {"id": "d2", "text": "P-1002 warranty policy", "vec": [0.70, 0.30]},
    {"id": "d3", "text": "generic network timeout troubleshooting", "vec": [0.90, 0.20]},
]

QUERY_VEC = [1.0, 0.0]
QUERY_TERMS = ["P-1002", "timeout"]


def cosine(a, b):
    dot = sum(x * y for x, y in zip(a, b))
    norm_a = sqrt(sum(x * x for x in a))
    norm_b = sqrt(sum(x * x for x in b))
    return dot / (norm_a * norm_b)


def vector_search():
    scored = [(doc["id"], cosine(QUERY_VEC, doc["vec"])) for doc in DOCS]
    return [doc_id for doc_id, _ in sorted(scored, key=lambda x: x[1], reverse=True)]


def keyword_search():
    # 产品编号权重更高,避免普通词覆盖精确标识符信号。
    def score(doc):
        text = doc["text"].lower()
        return 2 * ("p-1002" in text) + 1 * ("timeout" in text)

    return [doc["id"] for doc in sorted(DOCS, key=score, reverse=True)]


def weighted_rrf(vector_ids, keyword_ids, k=60, vector_weight=0.6):
    scores = {}
    keyword_weight = 1.0 - vector_weight

    for rank, doc_id in enumerate(vector_ids, start=1):
        scores[doc_id] = scores.get(doc_id, 0.0) + vector_weight / (k + rank)

    for rank, doc_id in enumerate(keyword_ids, start=1):
        scores[doc_id] = scores.get(doc_id, 0.0) + keyword_weight / (k + rank)

    return sorted(scores.items(), key=lambda x: x[1], reverse=True)


vector_ids = vector_search()
keyword_ids = keyword_search()
results = weighted_rrf(vector_ids, keyword_ids)

print("vector :", vector_ids)
print("keyword:", keyword_ids)
for doc_id, score in results:
    print(f"{doc_id} {score:.6f}")
预期输出
vector : ['d1', 'd3', 'd2']
keyword: ['d1', 'd2', 'd3']
d1 0.016393
d3 0.016027
d2 0.015975
d1 在两条链路中都排第一,因此融合后稳定居首。d3 的关键词排名较低,但语义排名第二,在向量权重为 0.6 时最终超过 d2。这正是混合检索的价值:不同信号可以互相补足,而不是由单一路径决定结果。
控制候选集而不是无限合并
生产环境通常先让两路各召回一批候选,例如向量 Top-50 与关键词 Top-50,再按文档 ID 合并和融合,最后截取统一 Top-K。候选过少容易漏召回,候选过多则会增加融合、重排以及后续模型处理成本。
加权 RRF 中的权重也应根据查询类型调整。知识库大量包含产品编号和错误码时,可以提高关键词权重;用户问题以自然语言描述为主时,可以提高向量权重。更成熟的实现还可以先识别查询类型,再动态选择权重,而不是全站固定一个比例。
验证混合检索是否真正变好
验收时应准备同时包含自然语言改写、产品编号、错误码和专有名词的查询集,比较纯向量、纯关键词与混合检索的 Recall@K 或人工相关性结果。只有混合方案在关键查询上稳定提高候选质量,额外的检索和融合成本才有价值。
混合检索的关键不是简单执行两次搜索,而是让两种不同性质的信号在统一候选集中公平竞争。先独立召回、按文档 ID 去重,再通过可解释的排名融合产生 Top-K,通常比直接拼接结果或直接相加异构分数更稳健。