
大模型应用开发 / 系统课时
结合结构化查询
结合结构化查询
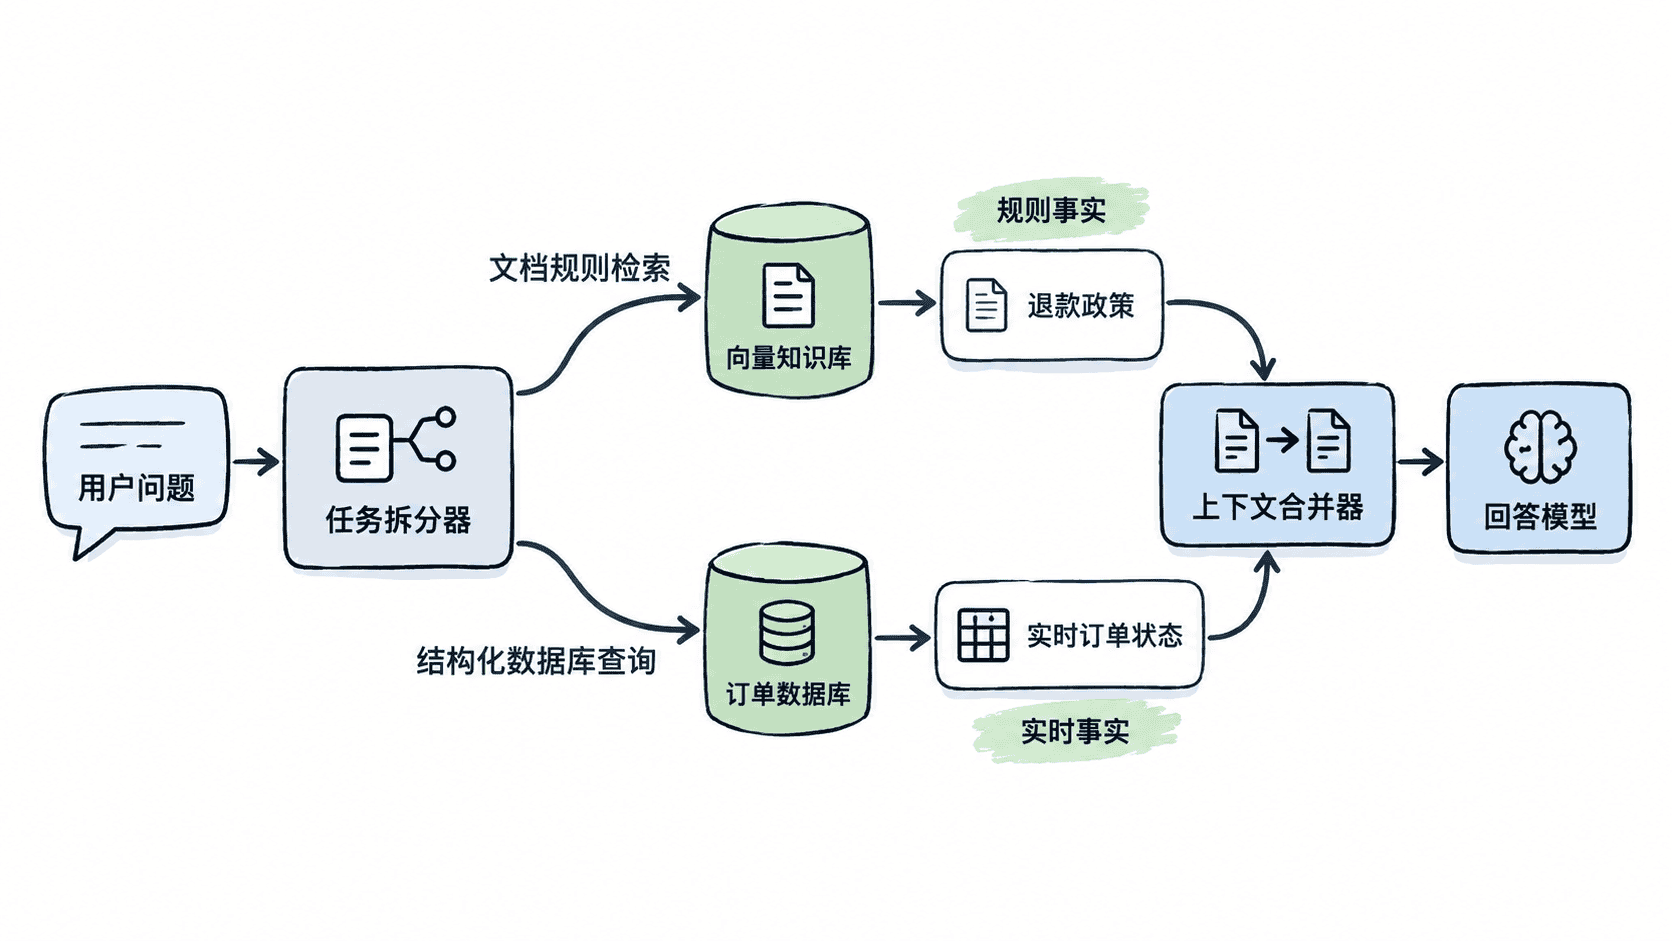
有些问题既依赖文档规则,又依赖数据库里的实时数据,例如“当前订单是否还能退款”。单纯向量检索只能找到退款规则,单纯 SQL 又缺少业务解释。本课把文档检索与结构化查询并行执行,再合并成可追溯的回答上下文。
学习目标
- 能判断问题中哪些信息来自文档,哪些来自实时数据库
- 能组合文档检索结果与 SQL 查询结果
- 能避免让模型直接生成并执行不受控 SQL
先拆分两类事实来源
结构化增强 RAG 通常同时处理两类事实:稳定规则来自知识库,例如退款期限;动态状态来自数据库,例如订单金额、支付状态和下单时间。回答器需要同时看到这两部分证据,但两条查询链应独立执行,最后再汇合。
用参数化 SQL 获取实时事实
不要让模型自由拼接 SQL 后直接执行。更稳妥的方式是由应用先识别业务动作,再调用预定义查询模板。下面用 SQLite 模拟订单实时数据,查询逻辑可直接迁移到 PostgreSQL、MySQL 等数据库。
import sqlite3

conn = sqlite3.connect(":memory:")
conn.execute(
    "CREATE TABLE orders (id TEXT PRIMARY KEY, status TEXT, amount REAL, days_since_paid INTEGER)"
)
conn.execute(
    "INSERT INTO orders VALUES (?, ?, ?, ?)",
    ("ORD-1001", "paid", 199.0, 3),
)

order_id = "ORD-1001"

row = conn.execute(
    "SELECT id, status, amount, days_since_paid FROM orders WHERE id = ?",
    (order_id,),
).fetchone()

print(row)
预期输出
('ORD-1001', 'paid', 199.0, 3)这里的关键不是 SQLite,而是参数化查询。订单号作为参数传入,避免字符串拼接造成 SQL 注入;同时查询字段固定,模型也无法借机读取无关表或敏感列。
再检索规则并合并上下文
假设知识库检索到的规则是“已支付订单在 7 天内可申请退款”。应用层可以把这条规则与数据库结果组合为结构化上下文,再交给模型生成自然语言答案。
下面是片段示例,依赖上一段代码中的 row 查询结果,只演示规则证据、实时事实与确定性判断如何合并。
policy_doc = "退款规则:已支付订单在付款后 7 天内可申请退款。"

order = {
    "id": row[0],
    "status": row[1],
    "amount": row[2],
    "days_since_paid": row[3],
}

context = {
    "policy": policy_doc,
    "order": order,
}

eligible = (
    order["status"] == "paid"
    and order["days_since_paid"] <= 7
)

print(context)
print(f"refund_eligible={eligible}")
预期输出
{'policy': '退款规则:已支付订单在付款后 7 天内可申请退款。', 'order': {'id': 'ORD-1001', 'status': 'paid', 'amount': 199.0, 'days_since_paid': 3}}
refund_eligible=True
在真实 RAG 中,policy_doc 来自向量检索,而 order 来自数据库查询。回答模型最好收到带来源标签的数据,例如 policy 与 order,而不是把两者拼成一大段无结构文本,这样更容易约束模型分别引用规则事实和实时事实。
让应用负责判断,模型负责表达
对于可以被确定性代码判断的条件,优先由应用执行。例如退款资格本质上是状态与天数条件,没必要让模型“推理”出布尔值。模型更适合把结果解释成人话,并指出依据。
可以把最终提示上下文组织为三部分:用户问题、规则证据、实时数据,再附上应用计算结果 refund_eligible=True。这样即使模型措辞变化,核心业务结论仍由确定性逻辑控制。
验证两条链都没有失真
混合 RAG 出错时,要分别验证文档链与数据库链。文档检索错了,通常表现为规则不匹配;数据库查询错了,通常表现为订单状态、金额或时间不正确;合并层错了,则会出现证据都正确但结论错误。
验收时至少保留三类可观测数据:命中的文档与版本、实际执行的查询模板与参数、最终用于回答的结构化上下文。这样才能判断错误发生在检索、查询还是答案生成阶段。
当问题同时依赖“长期规则”和“实时状态”时,最稳妥的设计不是让一个模型包办所有步骤,而是让文档检索提供规则、结构化查询提供事实、应用代码做确定性判断,最后再由模型负责解释。