
大模型应用开发 / 系统课时
理解文本切分
理解文本切分
文本切分决定了检索系统“拿什么粒度去匹配问题”。片段过短会丢失语义和上下文,过长又会降低检索区分度并占用模型窗口。本节建立一个可操作的判断框架,帮助你在召回质量、语义完整性和上下文成本之间取得平衡。
学习目标
- 解释片段过短和过长分别会带来什么问题
- 理解 chunk 大小、重叠与语义边界之间的关系
- 根据文档结构选择合适的切分策略
切分解决的核心矛盾
RAG 检索不是直接把整份文档交给模型,而是先把文档拆成可索引的片段。片段越小,匹配越精细,但一句话可能失去前后条件;片段越大,语义更完整,却可能同时混入多个主题,使向量表示变得模糊。
因此没有一个对所有文档都通用的固定长度。真正要优化的是:让一个 chunk 尽量只表达一个相对完整的知识单元,同时又足够小,便于被问题准确命中。
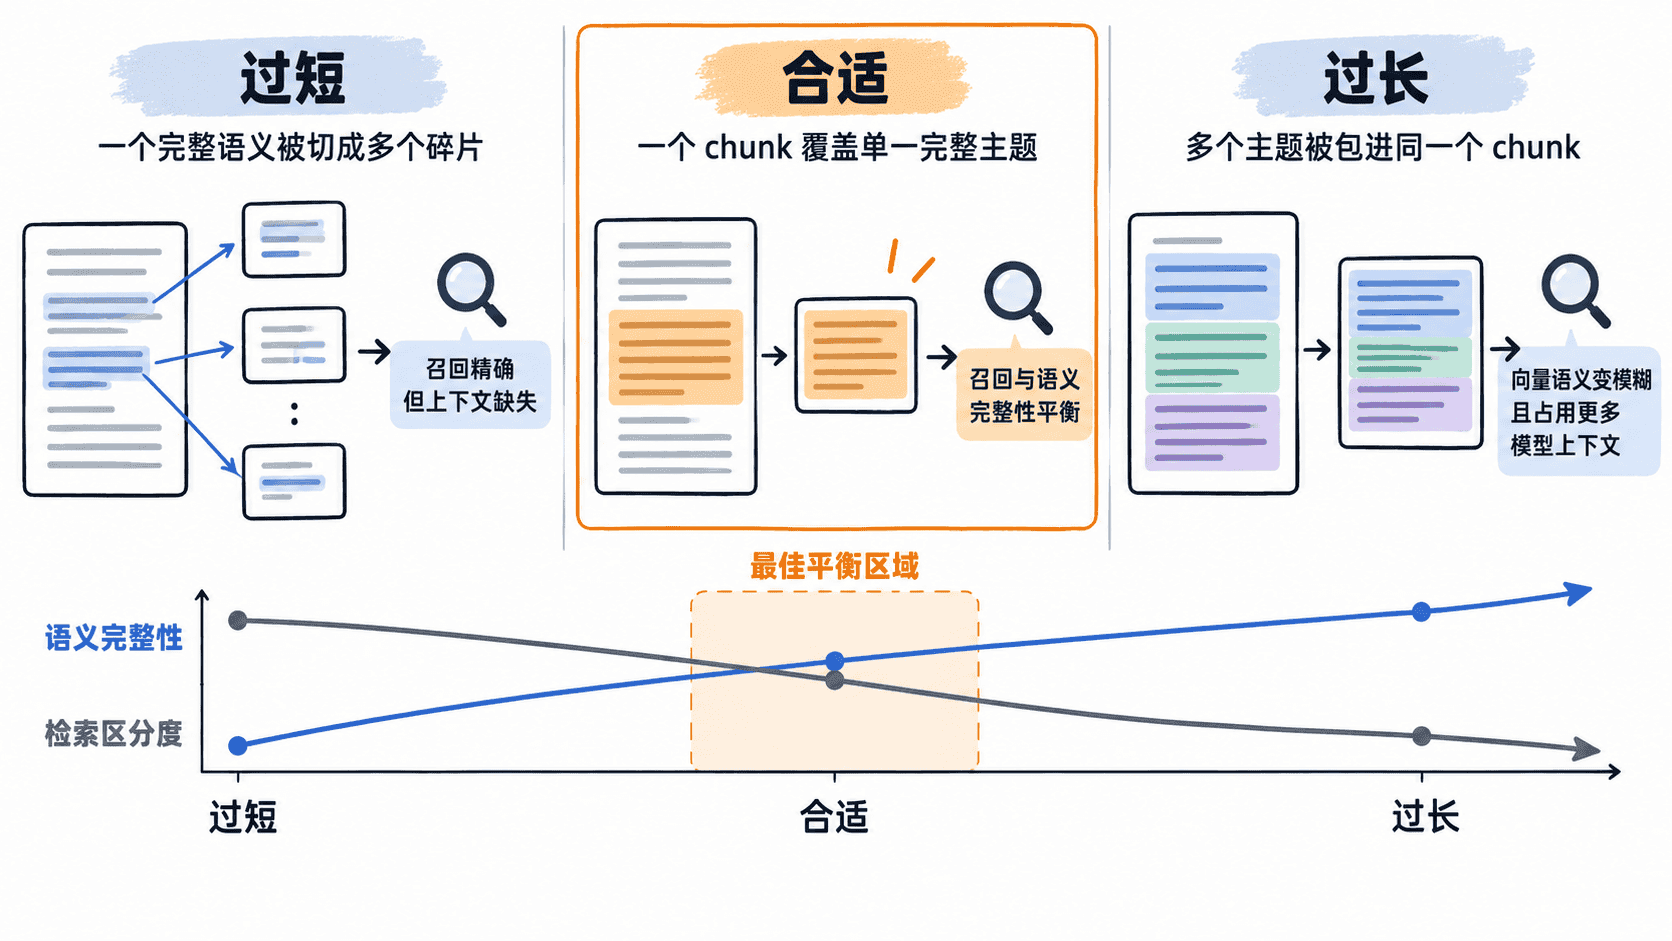
片段过短会发生什么
假设原文是“退款申请提交后,财务会在三个工作日内审核;审核通过后原路退回”。如果切成“退款申请提交后”“财务会在三个工作日内审核”“审核通过后原路退回”三个独立片段,用户询问“退款多久能到账”时,系统可能只召回其中一段,缺少完整条件。
过短还会增加索引条目数量。相同文档被拆得越碎,向量化、存储和召回后的去重成本越高,而且多个相邻片段往往会同时占据 Top-K 名额,挤掉真正来自其他文档的有用证据。
片段过长会发生什么
如果把整章甚至整篇文档作为一个 chunk,一个向量就必须同时代表多个主题。用户只问其中一个细节时,这个大块的整体语义未必和问题足够接近,反而可能输给内容更短、更聚焦的片段。
即使成功召回,长片段也会占用更多模型上下文。多个长 chunk 同时进入提示词时,真正与问题相关的句子只占很小比例,模型需要在大量无关文本中再次寻找证据。
优先按语义边界切分
实际切分通常先尊重文档结构,再用长度作为兜底。标题、段落、列表项、代码块、FAQ 问答对都可以天然形成语义边界;只有单个结构块仍然过长时,才继续按句子或字符数量切分。
重叠用于缓解边界附近的信息断裂,但不是越大越好。少量重叠能保留前后衔接;重叠过大则会让大量重复文本进入索引,增加存储成本,并让相邻 chunk 在召回结果中高度重复。
用检索结果反推切分质量
切分是否合理,最终要看检索结果而不是配置值本身。可以抽取一组真实问题,检查 Top-K 片段是否包含完整答案、是否被无关文本稀释,以及相邻重复片段是否占据过多名额。
当答案经常跨越两个 chunk 边界时,应优先调整语义切分规则或适度增加重叠;当召回结果总是整段很长且主题混杂时,应缩小块大小或按标题层级继续拆分。好的切分不是“最小”或“最大”,而是让检索到的片段刚好足以支持回答。