
大模型应用开发 / 系统课时
评估答案相关性
评估答案相关性
相关性评估关注的不是“答案有没有正确事实”,而是“它是否真正回答了用户当前的问题”。通过拆解用户意图、检查答案覆盖范围和无关信息比例,可以识别答非所问、只回答一半以及内容过度扩展等问题。
学习目标
- 把用户问题拆成可检查的意图点
- 同时衡量意图覆盖和无关内容比例
- 用回归样本发现“正确但偏题”的答案
从用户意图而不是关键词出发
只看关键词重合很容易误判。用户问“如何降低 RAG 首答延迟,同时尽量不降低召回”,真正需要覆盖的通常是三个意图点:降低首答延迟、保持召回质量、给出可执行的权衡方法。如果答案只解释“什么是向量检索”,即使内容完全正确,相关性仍然很低。
评估时可以先把问题转换成少量、可核对的意图点,再检查答案中的各个句子分别服务于哪个意图。没有对应意图、也不是理解答案所必需的内容,应标记为无关或冗余。
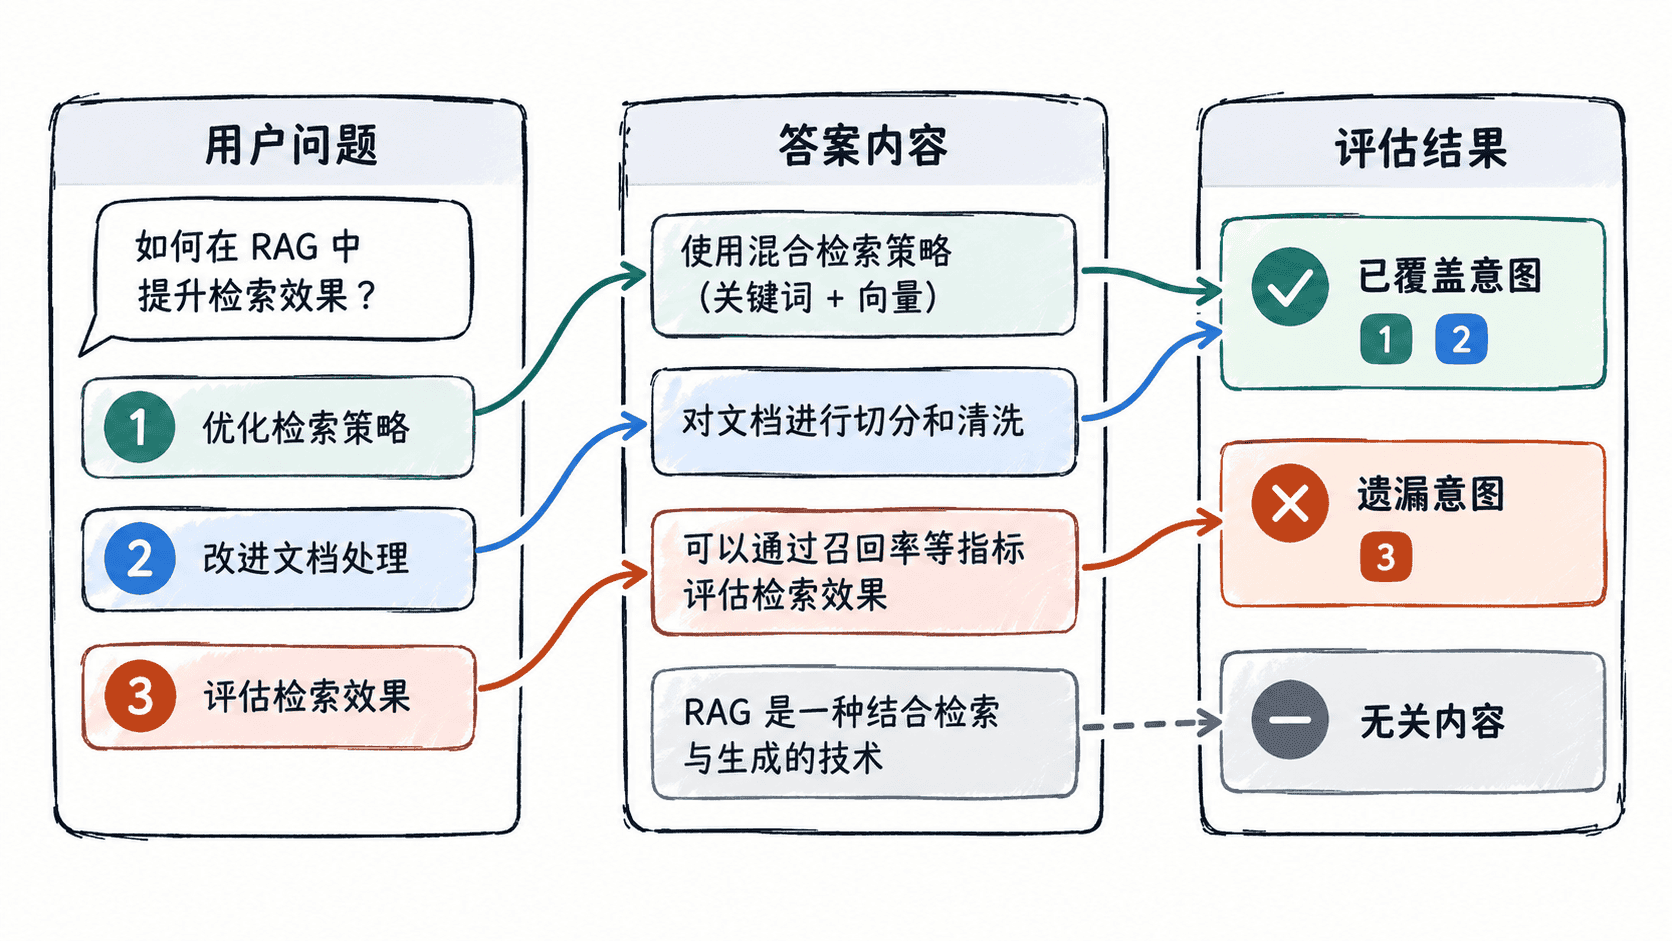
同时看覆盖率和无关比例
相关性至少要从两个方向观察。意图覆盖率衡量用户真正关心的点回答了多少;无关比例衡量答案里有多少内容没有服务当前问题。只看其中一个都会漏掉问题。
例如,一个答案覆盖了全部三个意图,却额外加入大量部署历史、数据库备份和团队流程,覆盖率可能是 100%,但阅读体验仍然很差。反过来,一个极短答案没有废话,却只回答了一个意图点,也不能算高相关。
用评分脚本汇总句级标注
下面的示例把“意图是否覆盖”和“答案句子是否相关”分开统计。句级标签可以由人工产生,也可以由固定评审提示词生成。
intent_points = {"降低首答延迟", "保持召回质量", "给出可执行措施"}
covered_intents = {"降低首答延迟", "给出可执行措施"}

sentence_labels = [
    "RELEVANT",
    "RELEVANT",
    "IRRELEVANT",
    "RELEVANT",
]

# 覆盖率看用户意图有没有被回答,无关比例看答案是否跑题。
coverage = len(covered_intents) / len(intent_points)
irrelevant = sum(label == "IRRELEVANT" for label in sentence_labels)
irrelevant_ratio = irrelevant / len(sentence_labels)

missing = sorted(intent_points - covered_intents)

print(f"intent_coverage={coverage:.2f}")
print(f"irrelevant_ratio={irrelevant_ratio:.2f}")
print(f"missing_intents={missing}")
预期输出
intent_coverage=0.67
irrelevant_ratio=0.25
missing_intents=['保持召回质量']
不要急着把这两个指标强行合并成一个总分。分别观察更容易判断该缩短答案,还是补充遗漏内容;如果业务确实需要单一排序分数,再根据真实用户反馈确定权重。
识别常见的偏题模式
遗漏关键意图最常见于复合问题,例如用户同时要求“原因、修复和验证”,答案只讲原因。范围膨胀则常见于模型把相关背景全部展开,导致核心建议被淹没。还有一种情况是答案围绕检索片段展开,却没有回到用户问题本身,这说明“内容相关于资料”不等于“内容相关于用户意图”。
用固定回归集持续检查
为高频问题保存“用户问题、预期意图点、模型答案、句级相关标签”四类信息。版本更新后,用同一批问题重新生成答案并统计覆盖率与无关比例,再抽查低分样本。这样可以区分检索器变差、提示词跑偏,还是生成模型开始过度展开。
当覆盖率下降时,优先检查问题理解和检索结果是否覆盖了关键意图;当无关比例上升时,优先收紧回答范围、输出结构和长度约束。相关性评估的目标不是让答案越短越好,而是让每一段都服务于用户当前的问题。